SEO d’un CMS headless dans un flux de travail natif de l’IA
SEO d’un CMS headless dans un flux de travail natif de l’IA avec contenu structuré, métadonnées, localisation, médias et contrôle qualité éditorial pour développer l’optimisation dans un seul CMS.
 Grzegorz
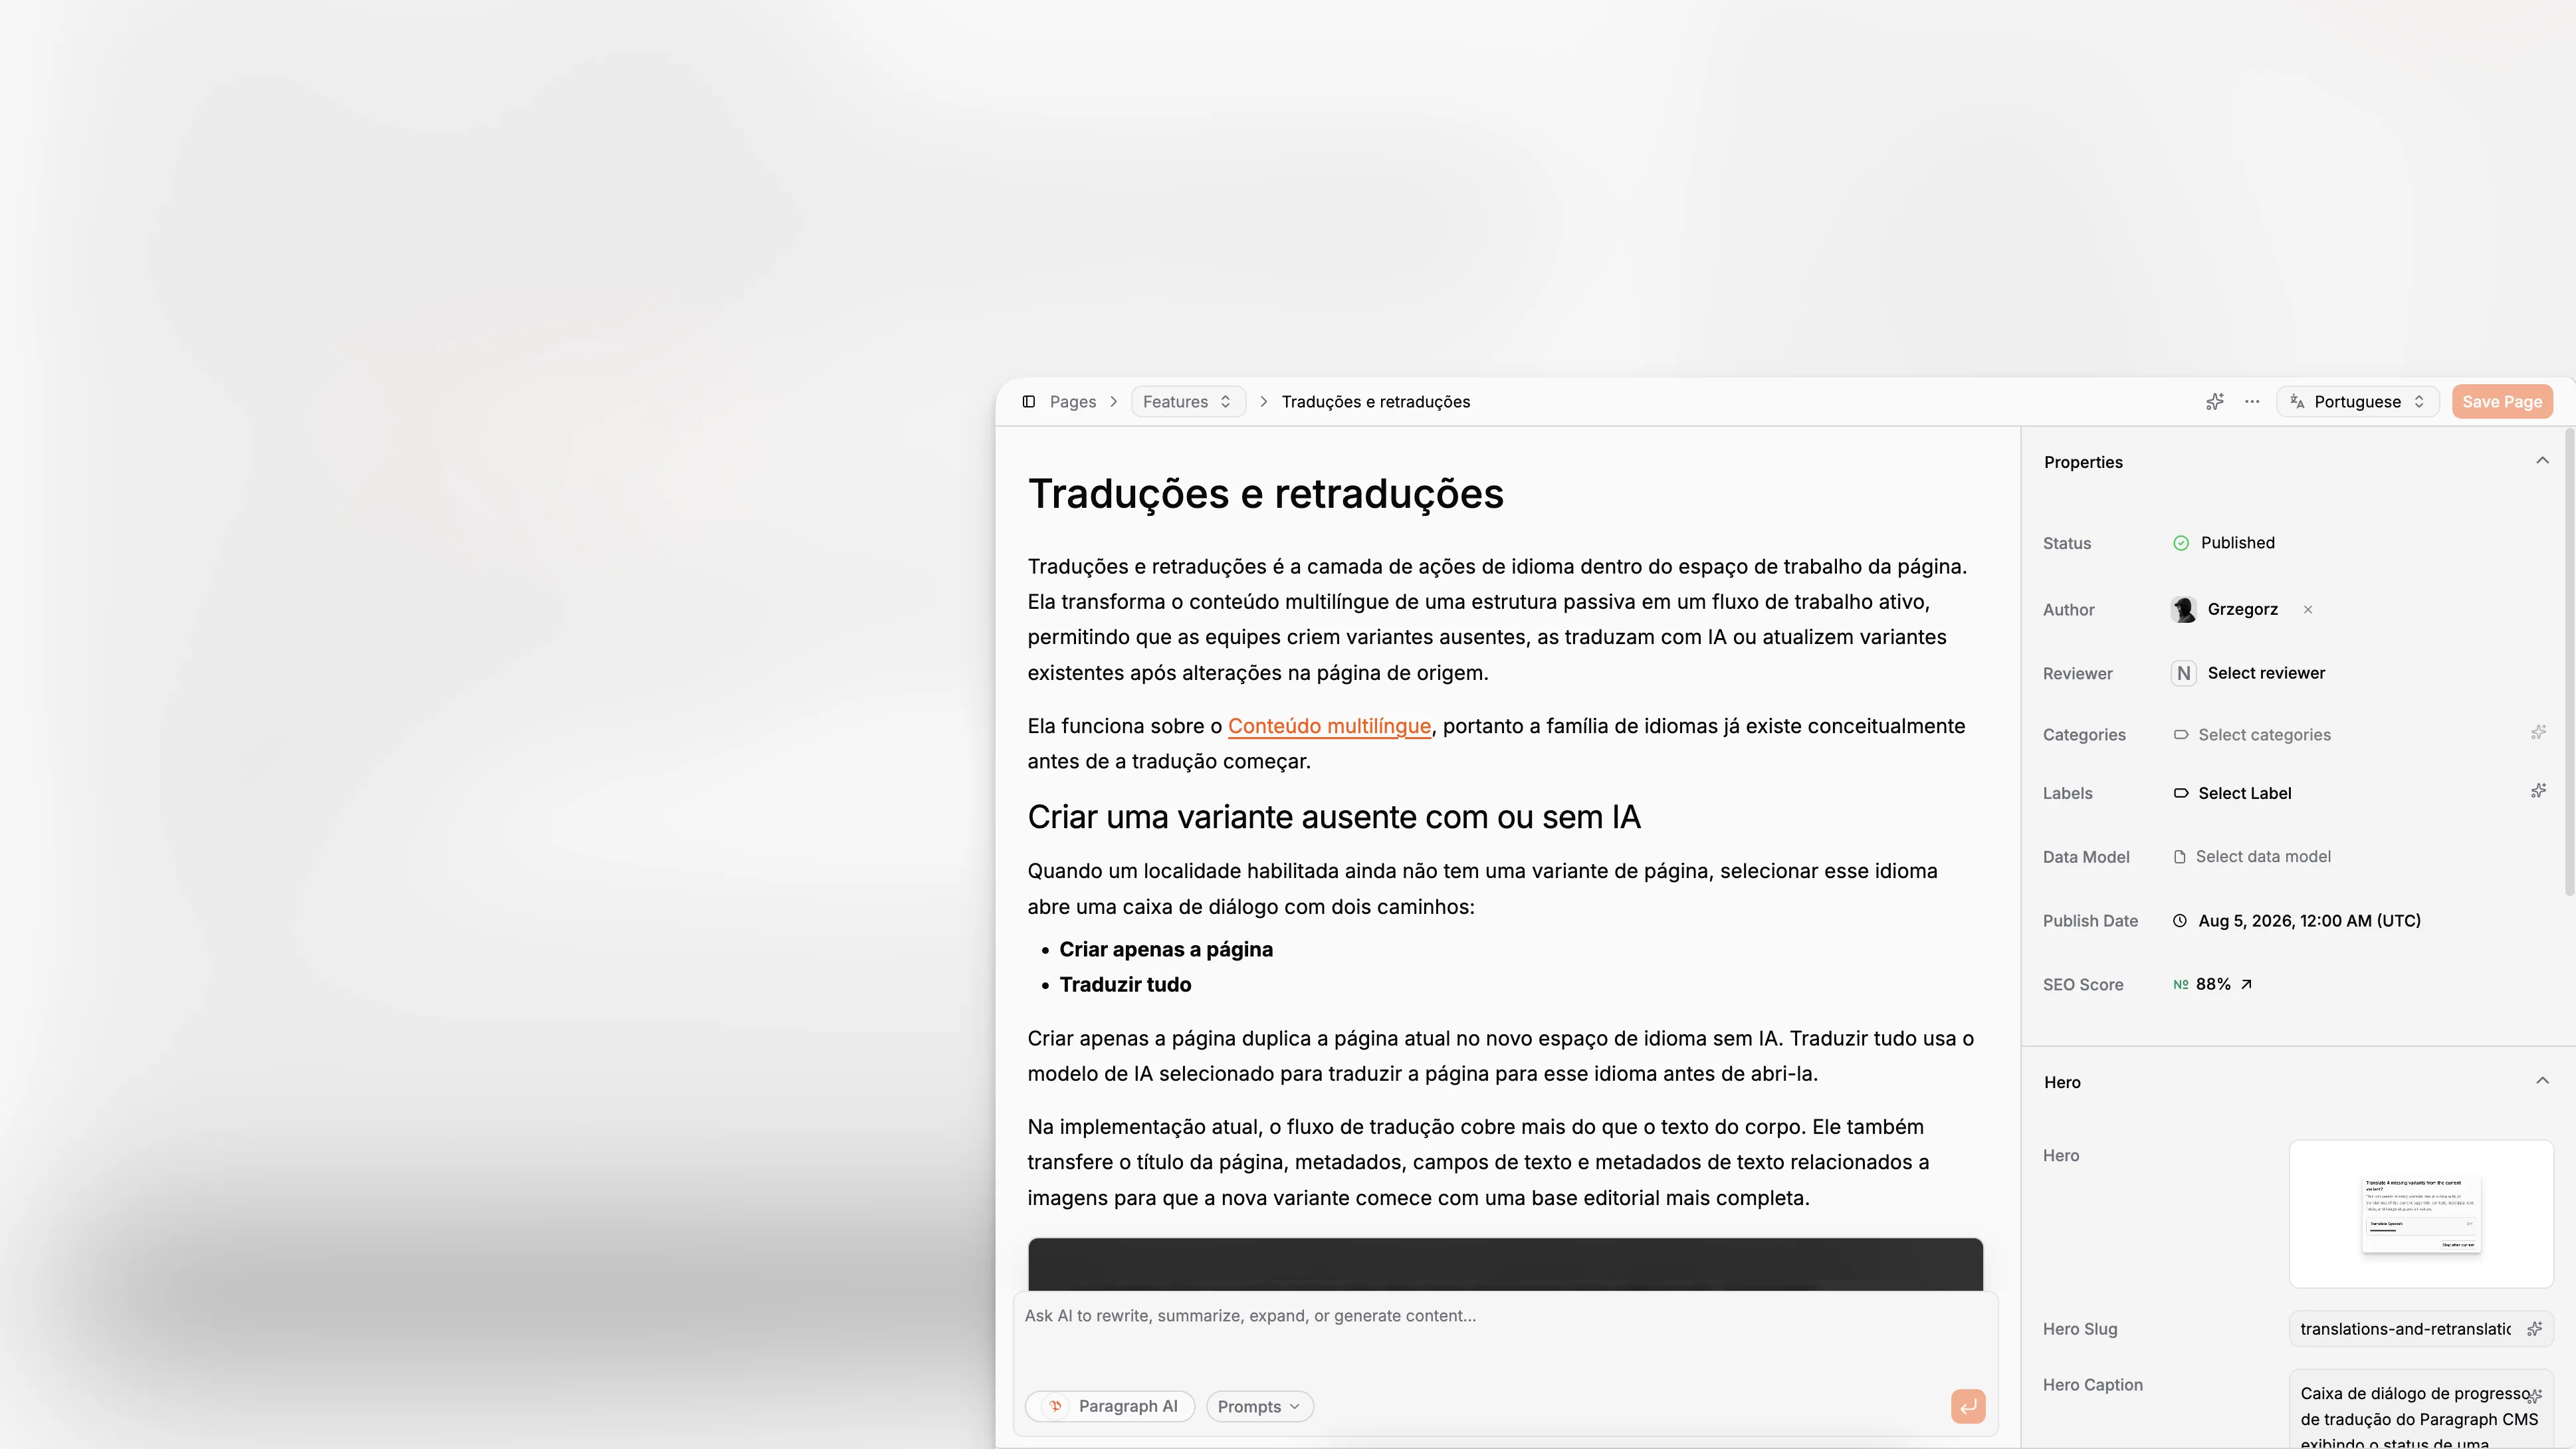
Le SEO d’un CMS headless ne consiste pas simplement à déplacer le SEO traditionnel dans une pile de contenu plus récente. Il modifie l’endroit où l’optimisation se produit, qui en est responsable et avec quelle fiabilité les équipes peuvent changer d’échelle. Dans un CMS headless natif pour l’IA comme Paragraph CMS, l’avantage pratique n’est pas seulement la diffusion structurée. C’est la capacité de réunir la rédaction, les métadonnées, la localisation, les médias et le contrôle qualité éditorial dans un seul système d’exploitation, au lieu de disperser le travail SEO entre des documents, des plugins, des feuilles de calcul et des onglets de navigateur.
TL;DR : Les configurations SEO de CMS headless les plus solides traitent le SEO comme un système d’opérations de contenu, et non comme une checklist de dernière minute. Le contenu structuré, les champs de métadonnées prévisibles, les contrôles de localisation, la gestion des médias et les workflows éditoriaux assistés par l’IA rendent l’optimisation plus facile à faire évoluer. Paragraph CMS est particulièrement pertinent lorsque vous souhaitez réunir ces éléments dans un seul CMS headless natif pour l’IA plutôt que de les assembler à partir d’outils distincts.
Que signifie réellement le SEO d’un CMS headless ?
Le SEO d’un CMS headless est la pratique consistant à créer un contenu prêt pour la recherche dans un système où le contenu est géré séparément de la présentation. Cette séparation donne plus de liberté aux équipes, mais elle supprime aussi certains garde-fous que les plateformes CMS traditionnelles cachent derrière des thèmes, des plugins ou des constructeurs de pages. Comme l’indique clairement la documentation de Google pour les développeurs, la performance dans la recherche dépend toujours d’un HTML explorable, d’un sens de page compréhensible et d’une implémentation technique solide.
Dans un CMS traditionnel, les éditeurs héritent souvent du comportement SEO d’un écosystème de thèmes ou de plugins. Dans un environnement headless, la structure du contenu et l’architecture de diffusion comptent davantage. L’aperçu du SEO headless par Ahrefs et le guide du SEO headless de Contentful soulignent tous deux le même changement : les fondamentaux du SEO ne disparaissent pas, mais leur mise en œuvre devient plus explicite.
C’est pourquoi un CMS headless natif pour l’IA mérite une attention particulière. Si le CMS peut générer des brouillons, améliorer les métadonnées, organiser des champs structurés, prendre en charge la localisation et faire remonter les problèmes SEO près de l’éditeur, le workflow devient beaucoup plus facile à opérationnaliser.
Pourquoi le SEO est-il plus difficile dans de nombreuses configurations headless ?
La promesse de l’architecture headless, c’est la flexibilité. Son coût, c’est que cette flexibilité crée davantage de points de défaillance possibles. Les équipes supposent souvent que headless signifie automatiquement de meilleures performances et un meilleur SEO. C’est possible. Mais ce n’est pas le cas par défaut.
Le schéma d’échec le plus courant ressemble à ceci :
Les équipes contenu choisissent un CMS headless pour sa flexibilité.
Les développeurs créent des front ends rapides.
Les exigences SEO sont reportées.
Les éditeurs gèrent les métadonnées de manière incohérente.
La localisation, les canoniques, le texte alternatif des médias et les données structurées deviennent un travail de nettoyage manuel.
C’est ici que la conception du workflow compte plus que les slogans d’outils. Google ne peut évaluer que ce qui est réellement rendu et correctement connecté. Les métadonnées doivent exister. La logique canonique doit être cohérente. Le maillage interne doit être planifié. Les médias ont besoin d’un texte alternatif descriptif lorsque c’est approprié. Les données structurées doivent correspondre au contenu de la page, ce qu’exigent précisément la documentation de Google sur les données structurées et ses règles générales.
Une configuration headless faible laisse ces préoccupations dispersées dans des tickets Jira et des conventions ponctuelles. Une configuration plus solide les centralise dans le système éditorial.
Qu’est-ce qui rend un CMS headless natif pour l’IA meilleur pour le travail SEO ?
L’expression AI-native est utilisée de manière assez floue, donc il est utile d’être précis. Dans ce contexte, cela signifie que l’IA n’est pas ajoutée comme un simple gadget d’écriture séparé. Elle est intégrée aux workflows que les éditeurs utilisent déjà.
Paragraph CMS se positionne comme un CMS headless natif pour l’IA avec génération de contenu intégrée, chat IA, génération de métadonnées, traduction, outils SEO de page, gestion des médias, localisation, rôles et modélisation de contenu structuré. Ses pages produit publiques décrivent une assistance IA intégrée, la traduction en un clic dans plus de 75 langues, la gestion des médias, le SEO de page, la diffusion mondiale de contenu et la prise en charge de frameworks modernes, notamment Next.js, Astro, Nuxt, React Router et SvelteKit.
Cela compte parce que le travail SEO est répétitif à grande échelle. Pas répétitif sur le plan intellectuel, mais répétitif sur le plan opérationnel. Les équipes reviennent sans cesse aux mêmes tâches :
rédiger et réécrire du contenu
générer ou affiner des titres et des descriptions
produire du texte alternatif et des légendes
gérer les slugs
traduire et retraduire les mises à jour
vérifier les éléments de contenu manquants
coordonner le passage de relais entre éditeurs et développeurs
Lorsque ces tâches vivent près du modèle de contenu plutôt qu’en dehors, le système devient plus facile à gouverner.
Quelles capacités SEO d’un CMS headless comptent le plus ?
Toutes les fonctionnalités étiquetées « SEO » n’ont pas la même importance. Le tableau ci-dessous montre les capacités qui ont généralement la plus grande valeur opérationnelle pour les équipes contenu.
Capability | Why it matters for SEO | What to look for in practice |
|---|---|---|
Modèles de contenu structurés | Rend les métadonnées et les éléments de page cohérents | Champs séparés pour le titre, le slug, la description, le hero, le corps, les entrées de schéma, les variantes de langue |
Contrôles SEO au niveau de la page | Empêche les métadonnées de devenir une réflexion après coup | Titres modifiables, descriptions, champs sociaux, logique d’indexation, prise en charge de l’aperçu |
Workflows de localisation | Évite les pages multilingues dupliquées ou obsolètes | Contrôles de traduction, retraduction après mises à jour, organisation par langue |
Gestion des médias | Prend en charge le SEO des images et la cohérence du contenu | Ressources centralisées, légendes, génération de texte alternatif, URLs de diffusion stables |
Rôles et autorisations | Réduit les erreurs de publication | Autorisations claires entre éditeurs, développeurs et approbateurs |
Assistance IA dans l’éditeur | Accélère le travail d’optimisation répétitif | Réécrire, résumer, générer des métadonnées, ajuster le ton, combler les manques |
Prise en charge de la sortie technique | Relie les opérations de contenu à l’explorabilité | Sitemap, robots, modèles de sortie structurée, compatibilité framework |
Un système n’a pas besoin d’accomplir lui-même toutes les tâches de SEO technique. Votre front end et votre infrastructure comptent toujours. Mais le CMS doit rendre le SEO éditorial répétable plus facile, et non plus difficile.
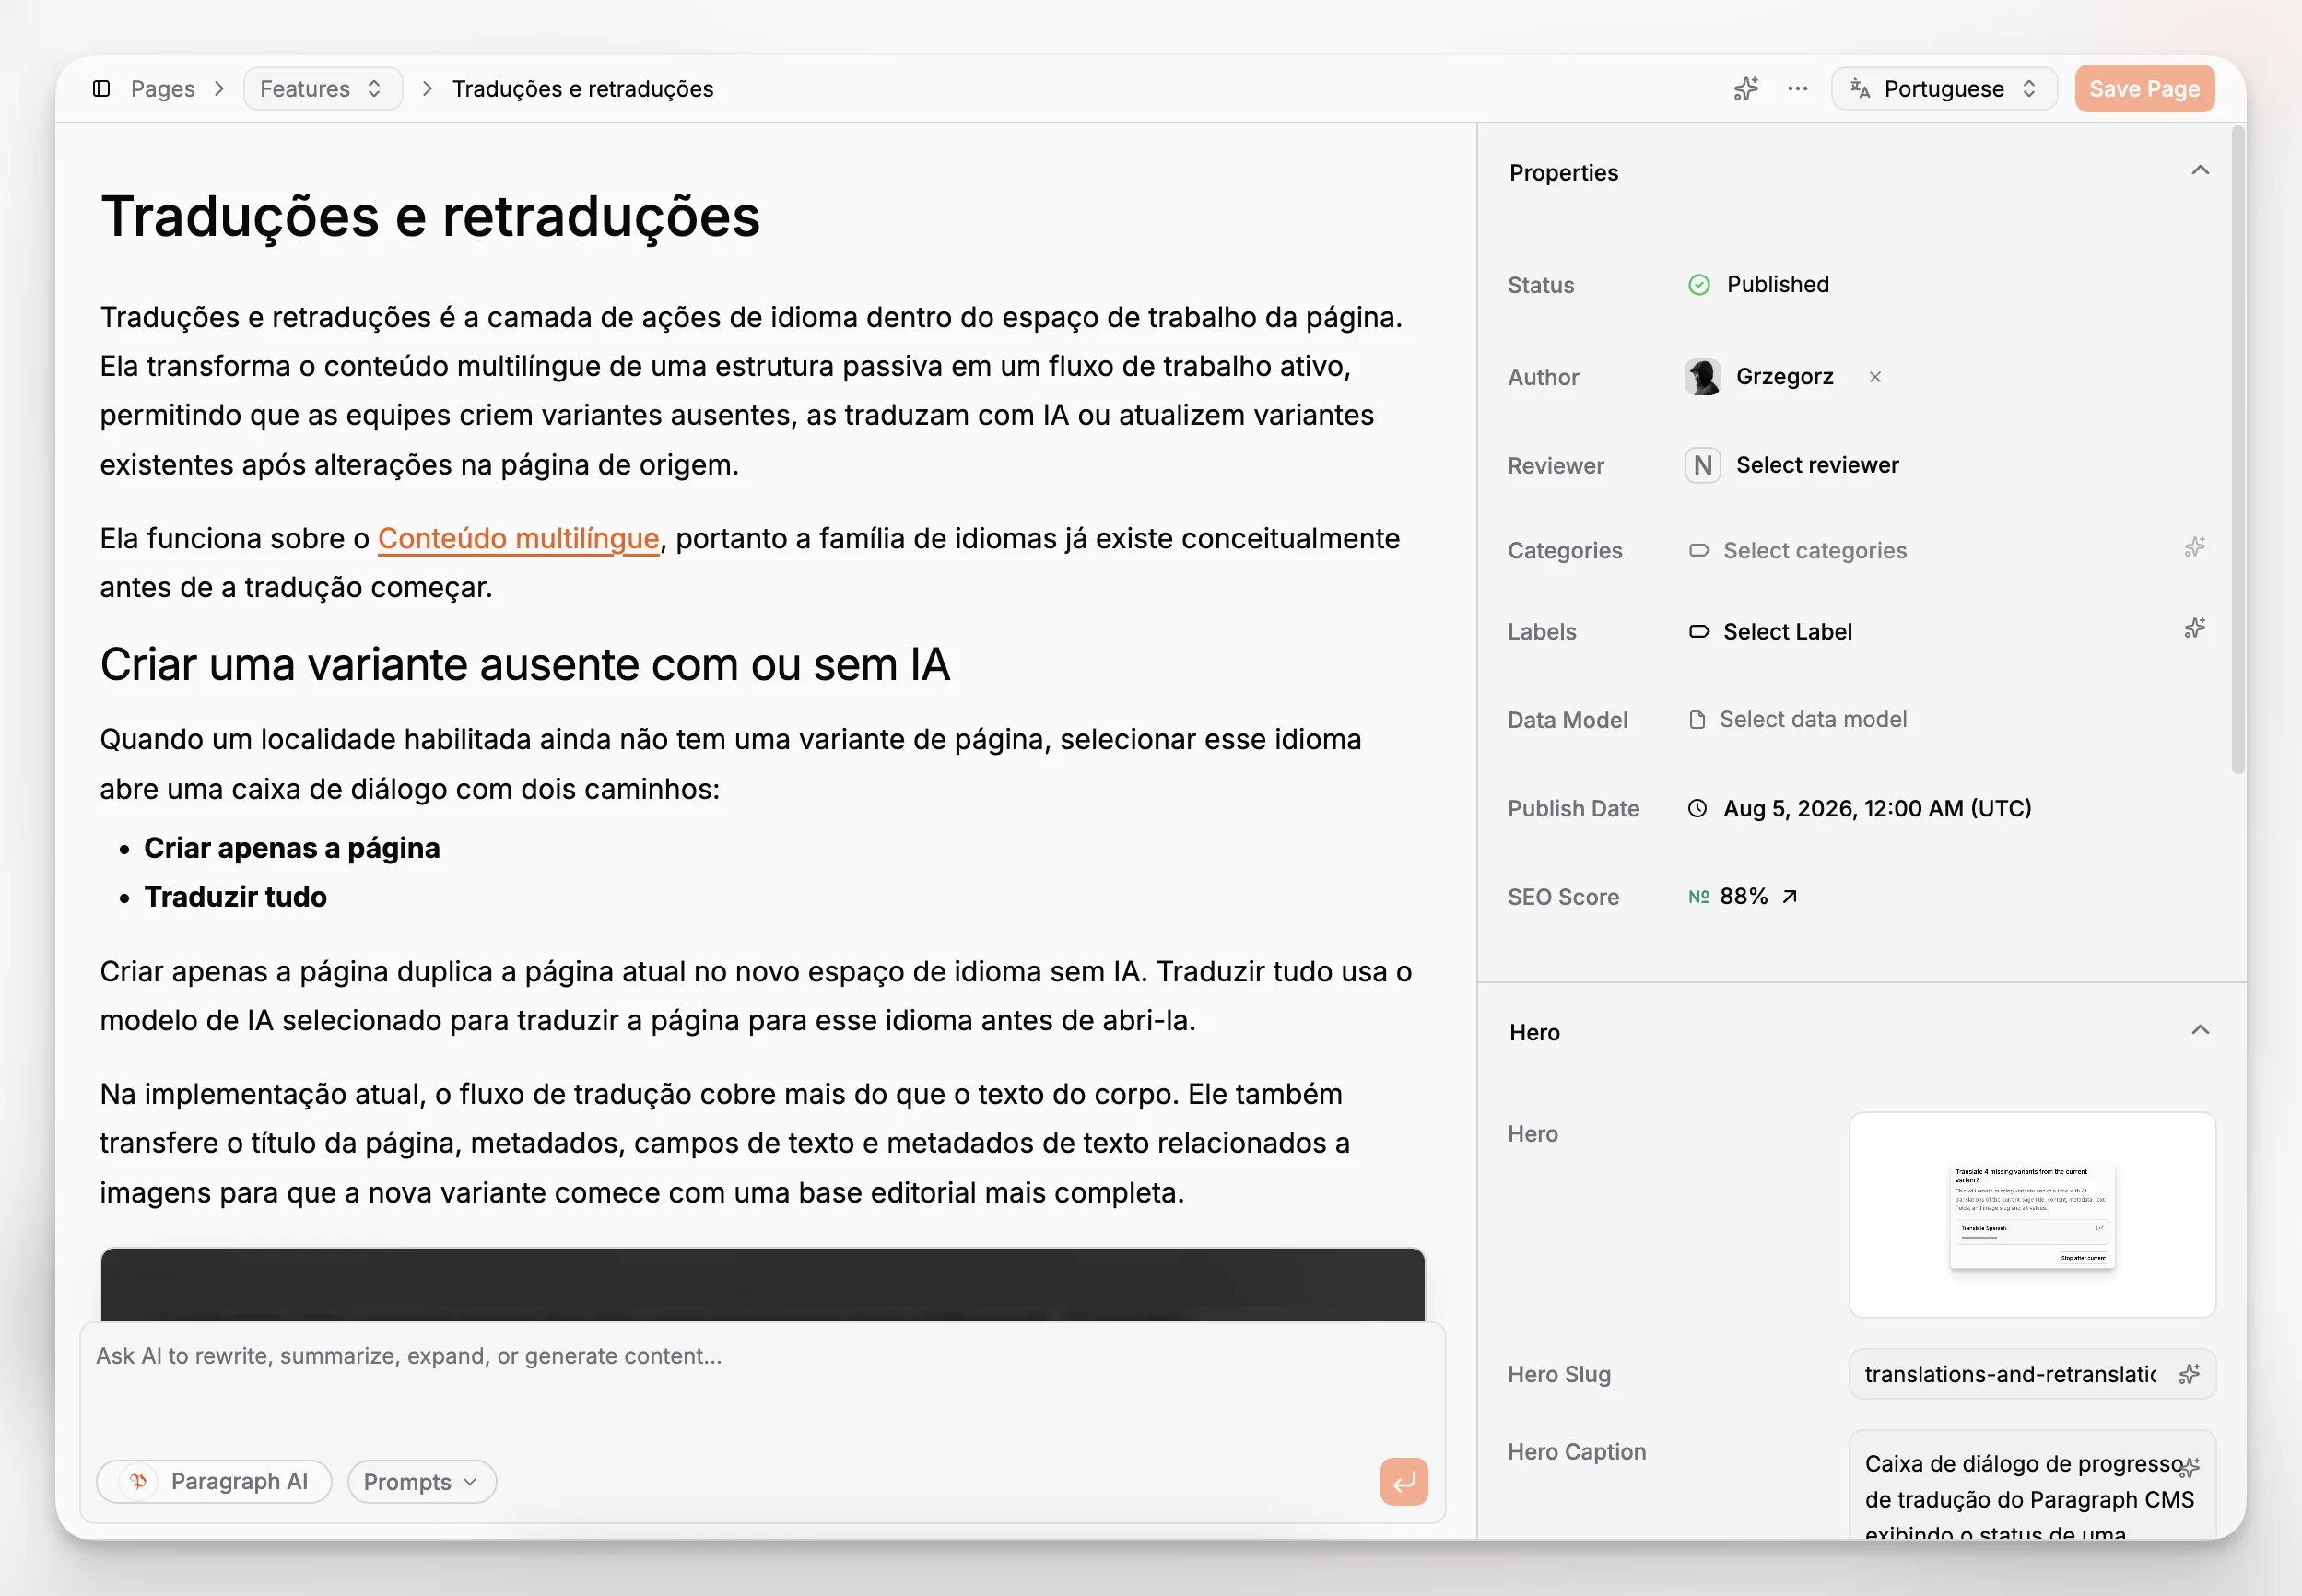
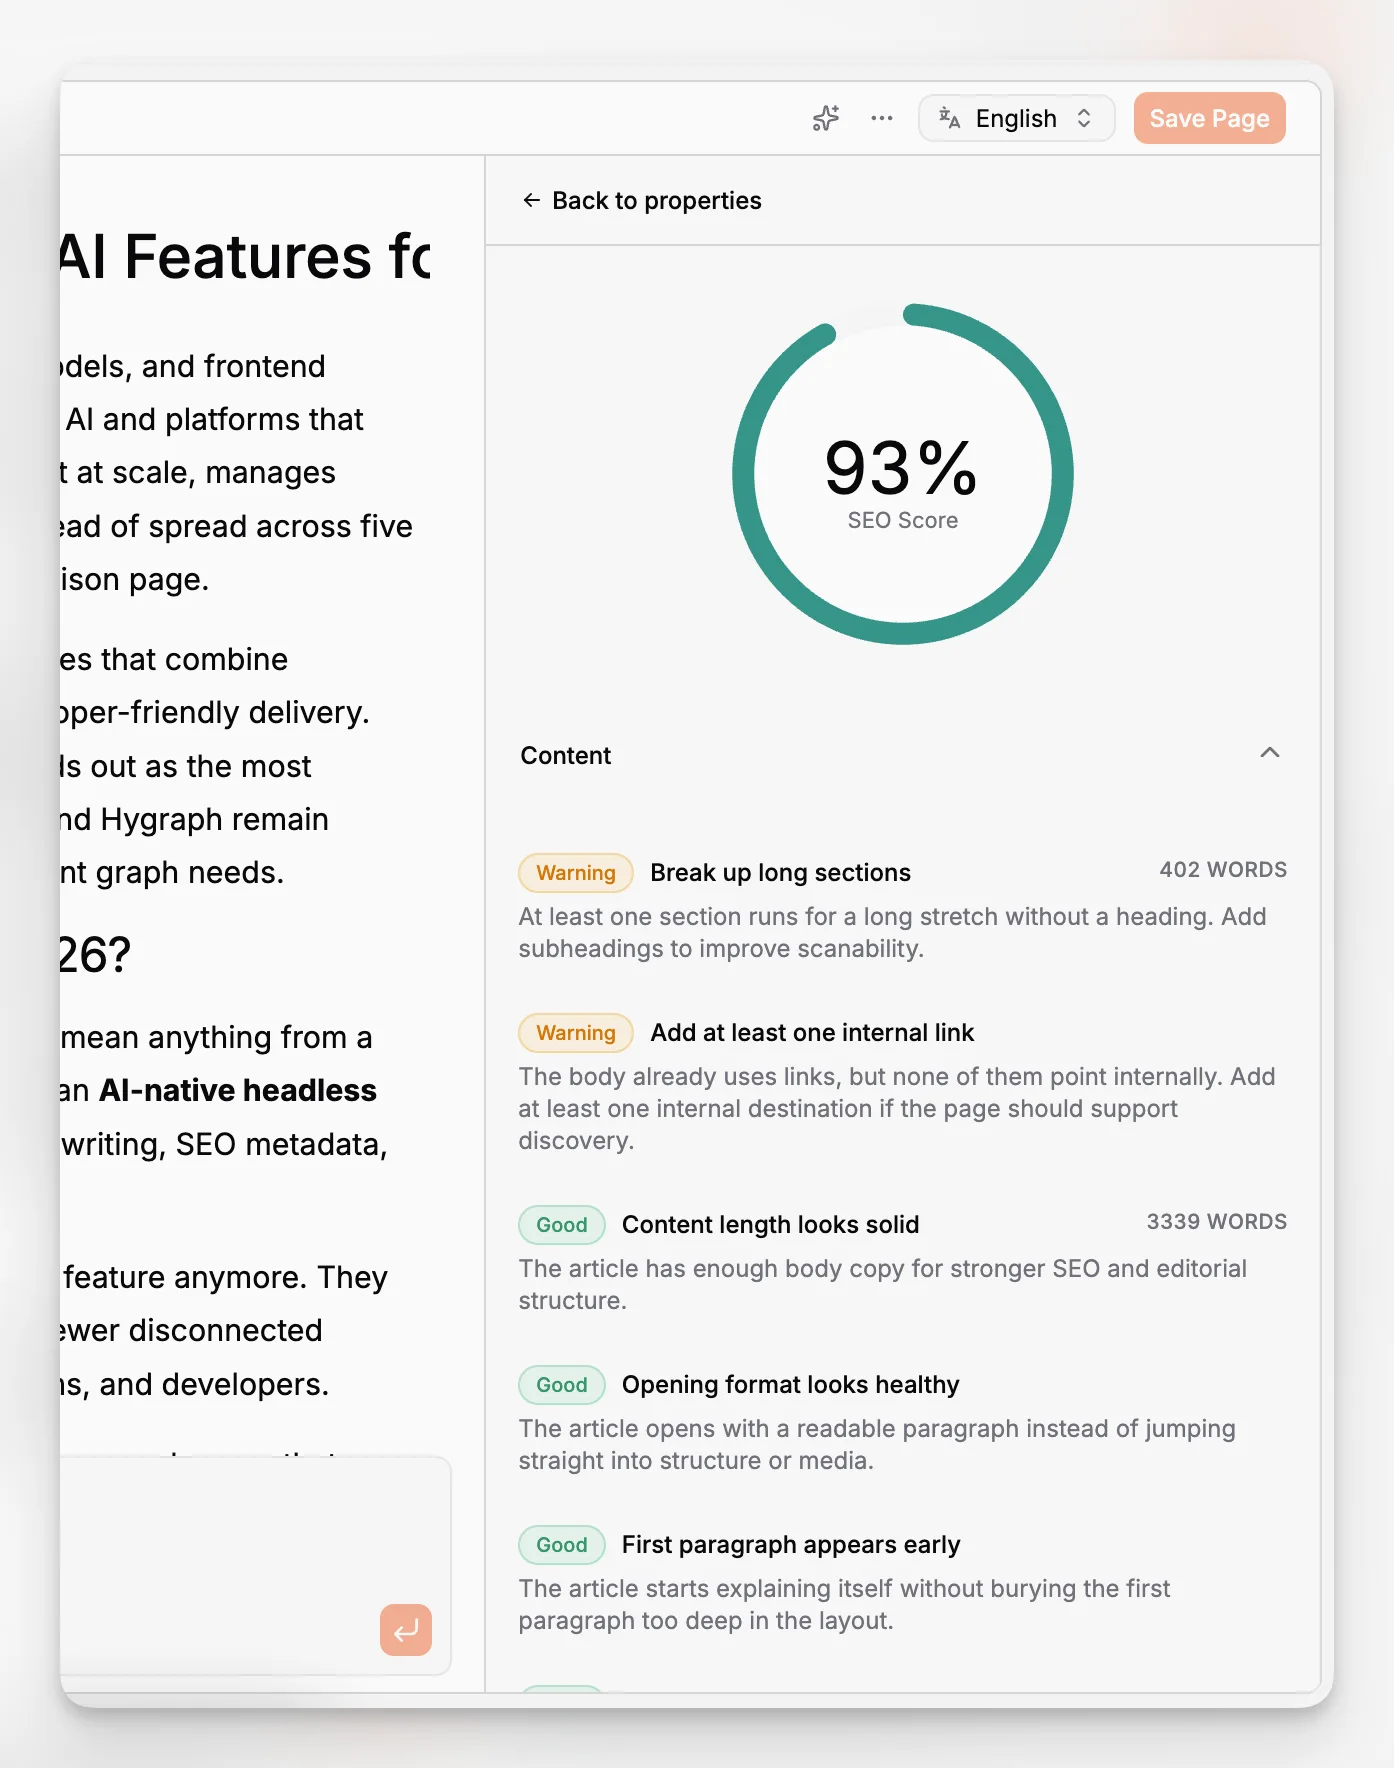
Paragraph CMS est remarquable ici, car son ensemble de fonctionnalités publiques couvre Editor, Pages, Multilingual Content, Media Management et Page SEO. Cette combinaison est particulièrement pertinente pour les équipes qui veulent une seule surface opérationnelle pour le contenu sensible au SEO.
Comment le contenu structuré améliore-t-il les résultats SEO ?
Le contenu structuré fait partie de ces expressions auxquelles les gens acquiescent sans toujours les détailler. En pratique, cela signifie que votre contenu est stocké sous forme de champs et de composants distincts et réutilisables, plutôt que dans un énorme bloc unique. La checklist CMS headless de Contentful présente cela comme l’organisation du contenu en éléments pouvant être réutilisés sur plusieurs canaux. Pour le SEO, cette structure est utile parce qu’elle impose de la clarté.
Un modèle bien conçu peut séparer :
le titre de recherche du titre affiché sur la page
la meta description du texte d’introduction
la cible canonique de l’URL publiée
les détails de l’auteur du corps de l’article
le texte alternatif de l’image hero de l’imagerie décorative
les questions et réponses FAQ des blocs de texte généraux
Cette séparation donne aux éditeurs un meilleur contrôle et aux développeurs une sortie prévisible. Elle améliore aussi les chances que vos templates traitent le contenu de manière cohérente sur des centaines ou des milliers de pages.
Par exemple, si chaque article de votre CMS inclut des champs dédiés pour le titre SEO, la meta description, le slug, l’extrait, l’image hero, la langue et les modules de contenu, votre front end peut rendre ces champs avec moins de conditions et moins de surprises liées aux cas limites. Le résultat n’est pas magiquement un meilleur classement. Le résultat, c’est moins de friction opérationnelle et moins d’erreurs évitables.
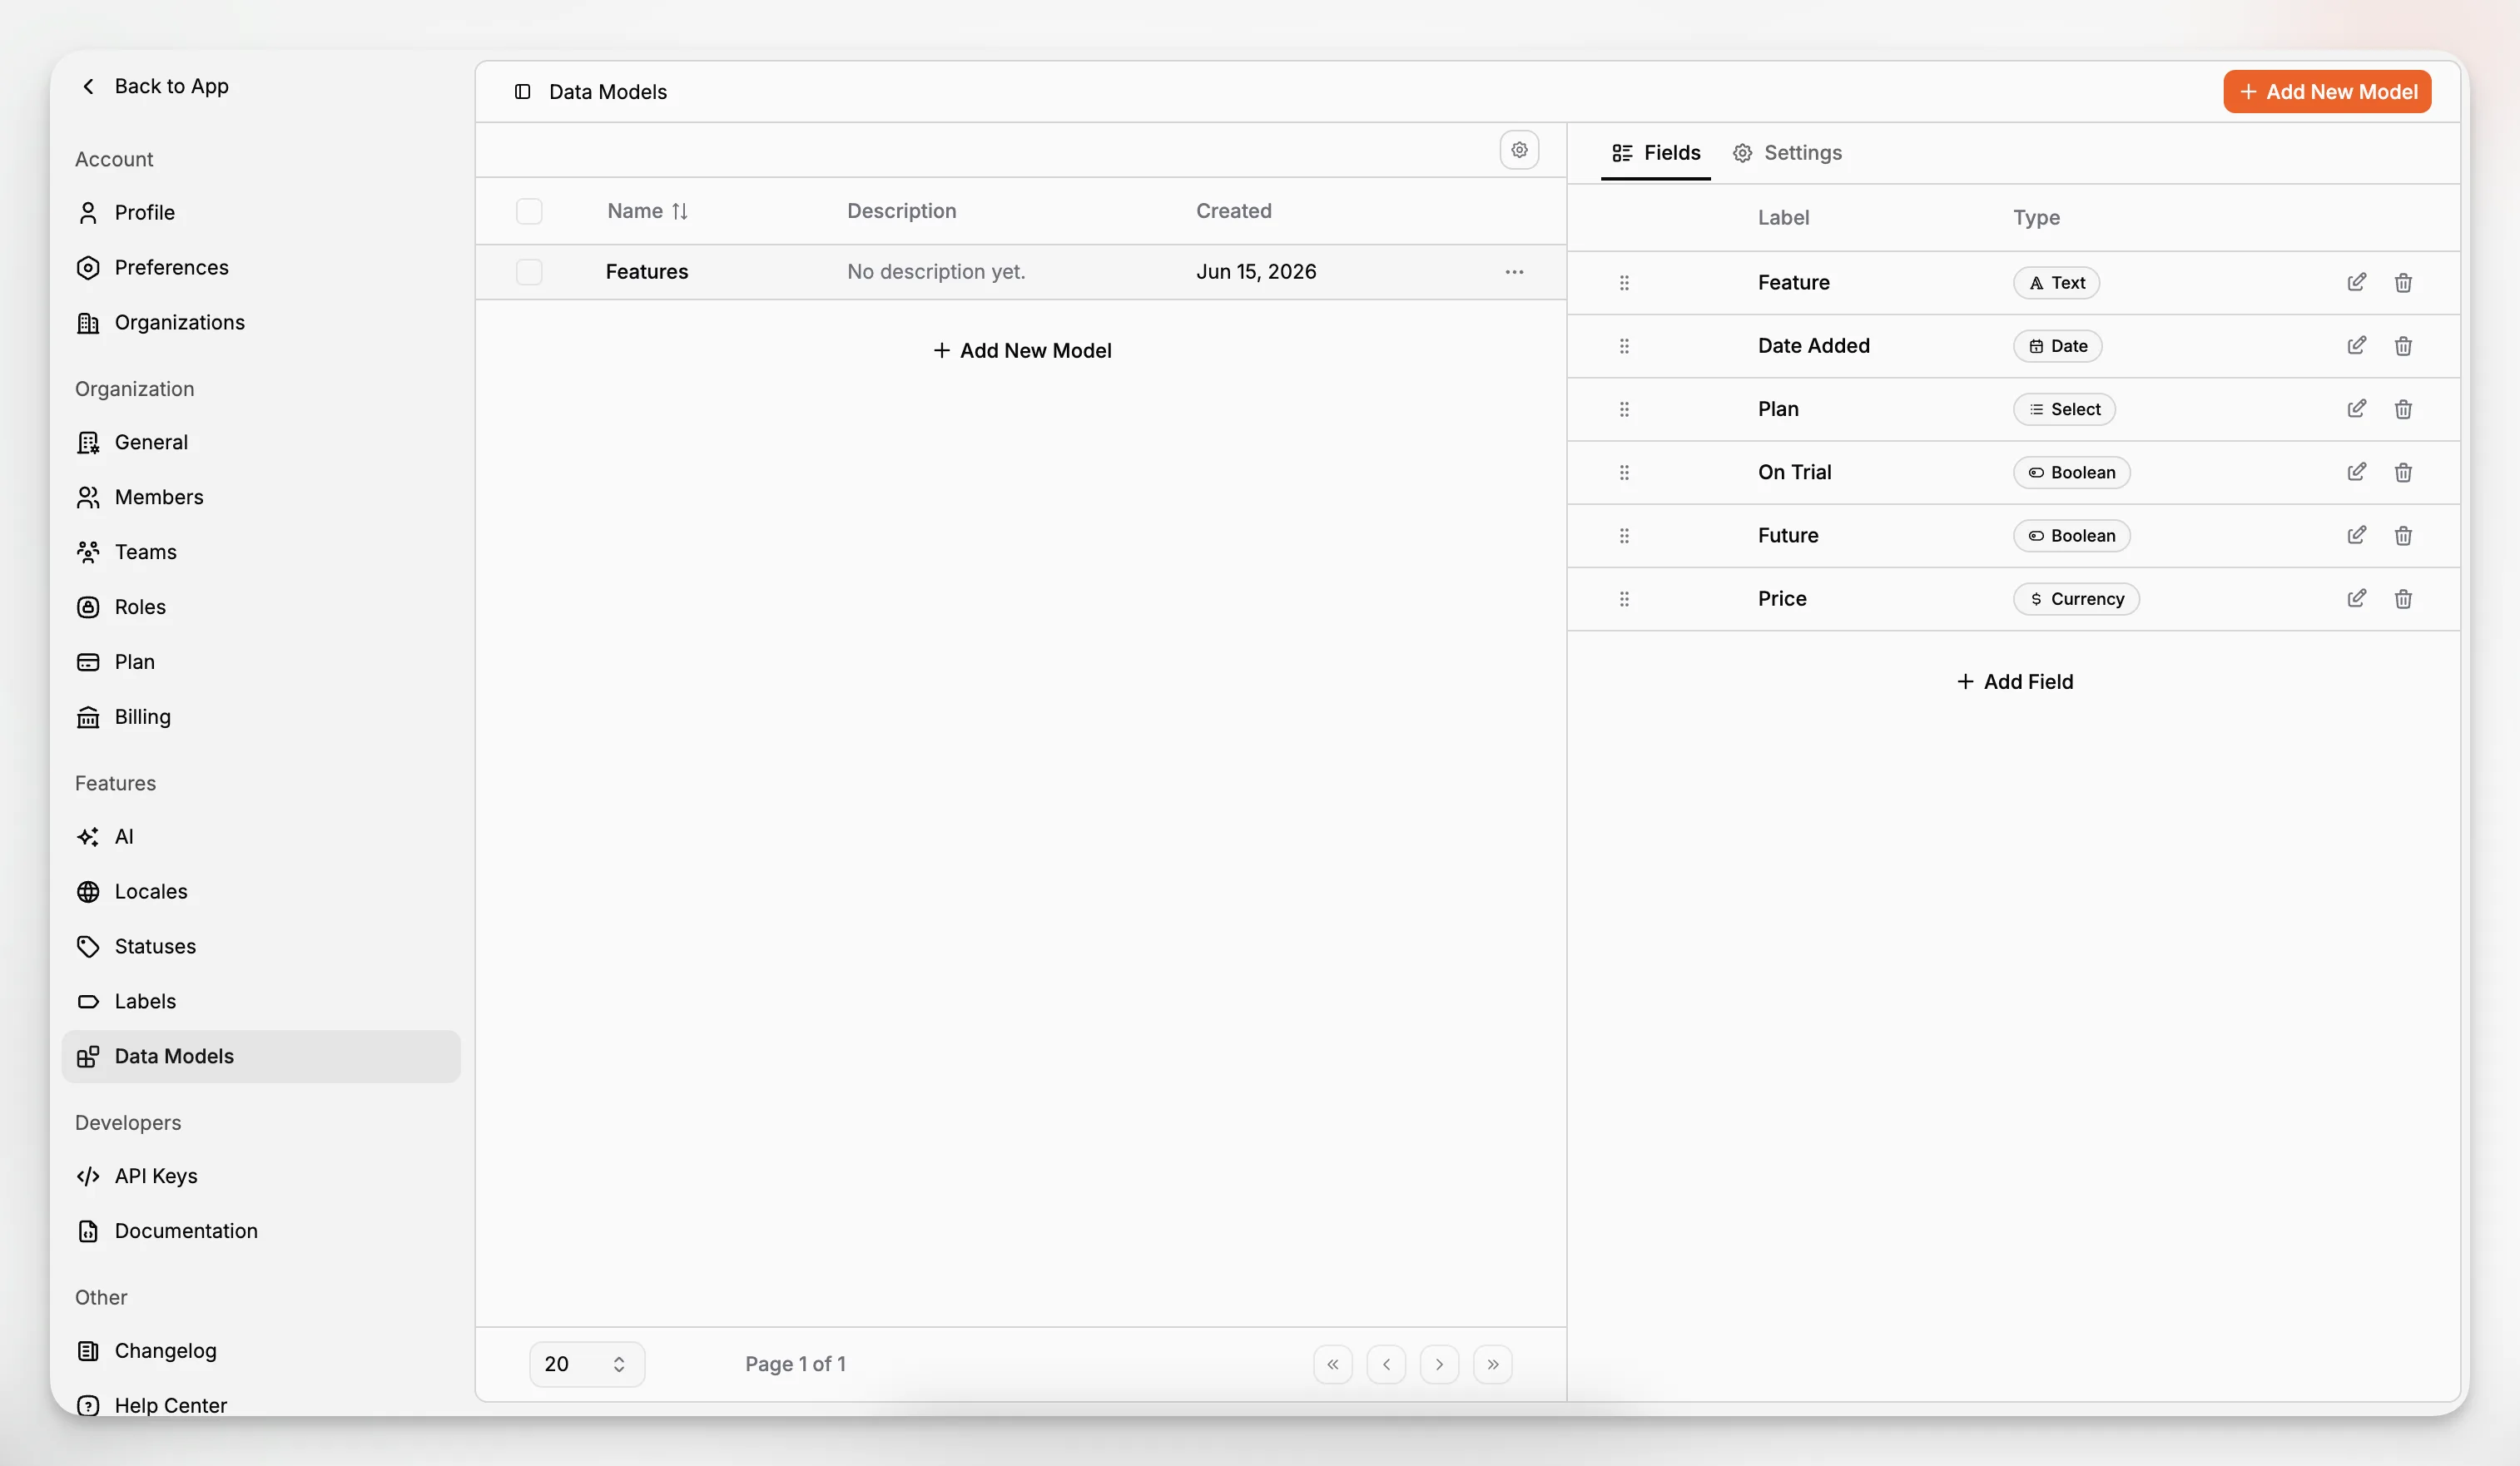
Comment modéliser le contenu pour la recherche, et pas seulement pour la publication ?
Beaucoup d’équipes modélisent le contenu uniquement autour de la mise en page. C’est compréhensible. C’est aussi limitant. La recherche a besoin d’une logique supplémentaire.
Un modèle de contenu pratique pour le SEO éditorial inclut généralement au moins les décisions suivantes :
H3 : Identité fondamentale de la page
Chaque type de contenu doit définir ce qu’est fondamentalement la page. Article, landing page, page de catégorie, page fonctionnalité, page locale, entrée de documentation. Cela affecte la logique des templates, le maillage interne et les conventions de métadonnées.
H3 : Champs distincts pour les titres et les résumés
Ne supposez pas qu’un seul champ titre peut remplir tous les rôles. Le titre qu’un lecteur voit n’est pas forcément celui que vous souhaitez dans l’onglet du navigateur ou dans l’extrait de SERP. De même, un chapô ou une introduction n’est pas toujours une bonne meta description. La documentation de Google sur les extraits explique que les extraits de recherche peuvent varier, mais donner aux éditeurs un espace dédié pour rédiger de bonnes descriptions améliore tout de même le contrôle.
H3 : Modules réutilisables pensés pour le SEO
Si vos pages utilisent des blocs FAQ, des biographies d’auteurs, des mises en avant produit, des listes de fonctionnalités ou des modules de témoignages, modélisez-les comme des composants plutôt que de les coller manuellement dans de longs champs de texte enrichi. Cela améliore la cohérence et facilite les améliorations futures.
H3 : Localisation dès le départ
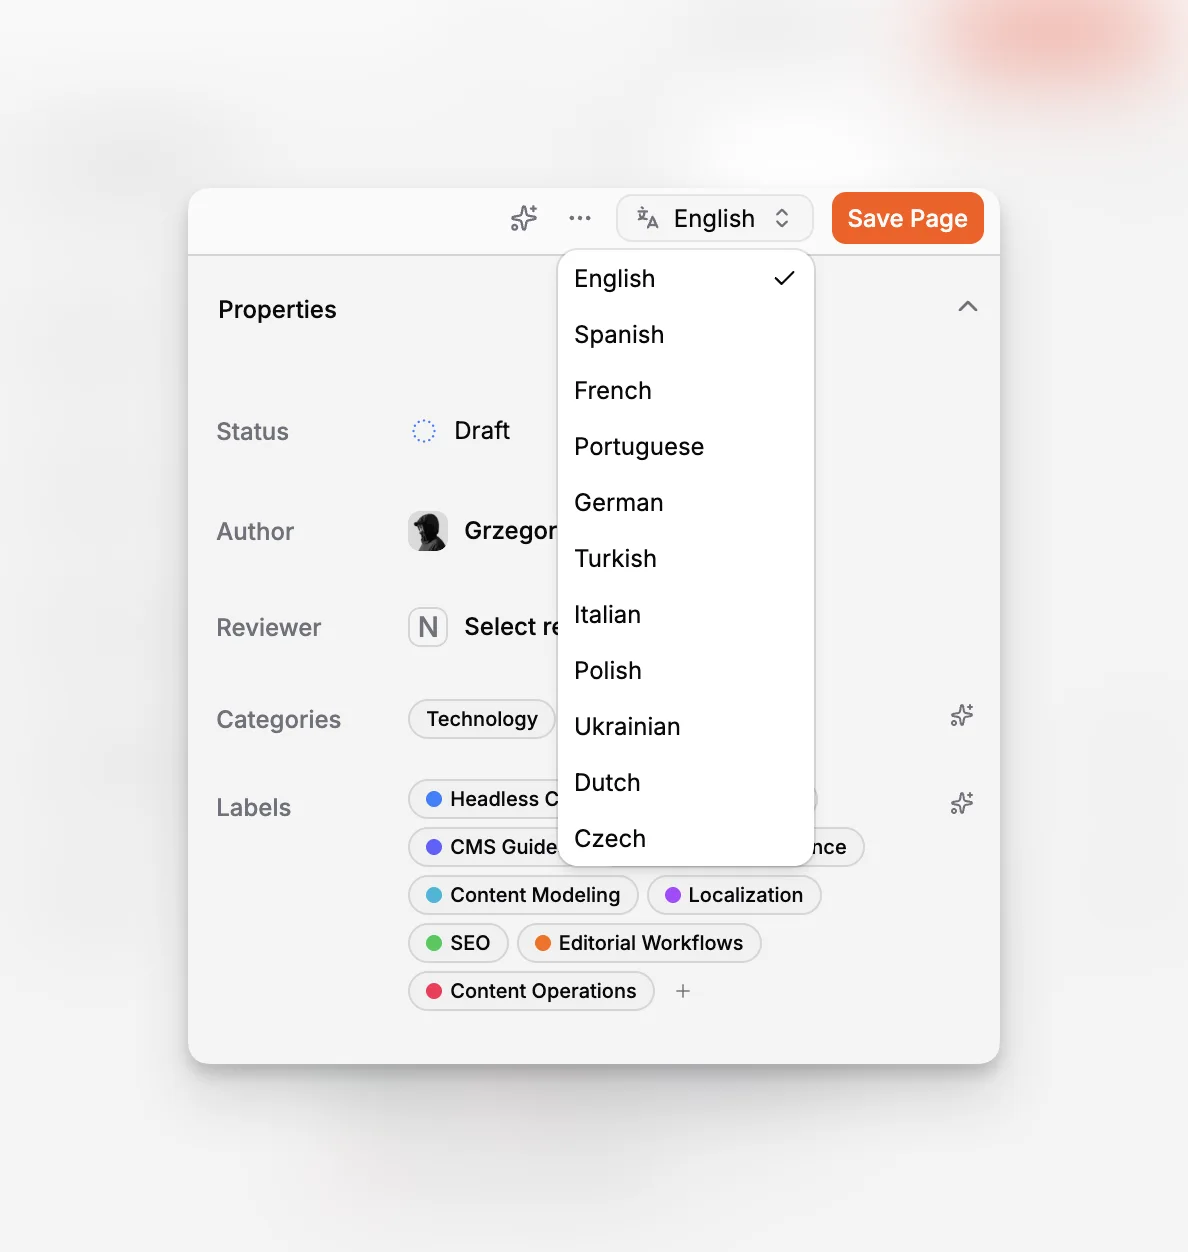
Ajouter la localisation après qu’une prolifération de contenu s’est déjà produite coûte cher. Si le trafic international compte, modélisez tôt les variantes linguistiques et le statut de traduction. Paragraph CMS met publiquement en avant des workflows de traduction et de retraduction, ce qui correspond exactement au type de fonctionnalité dont les équipes SEO multilingues ont besoin.
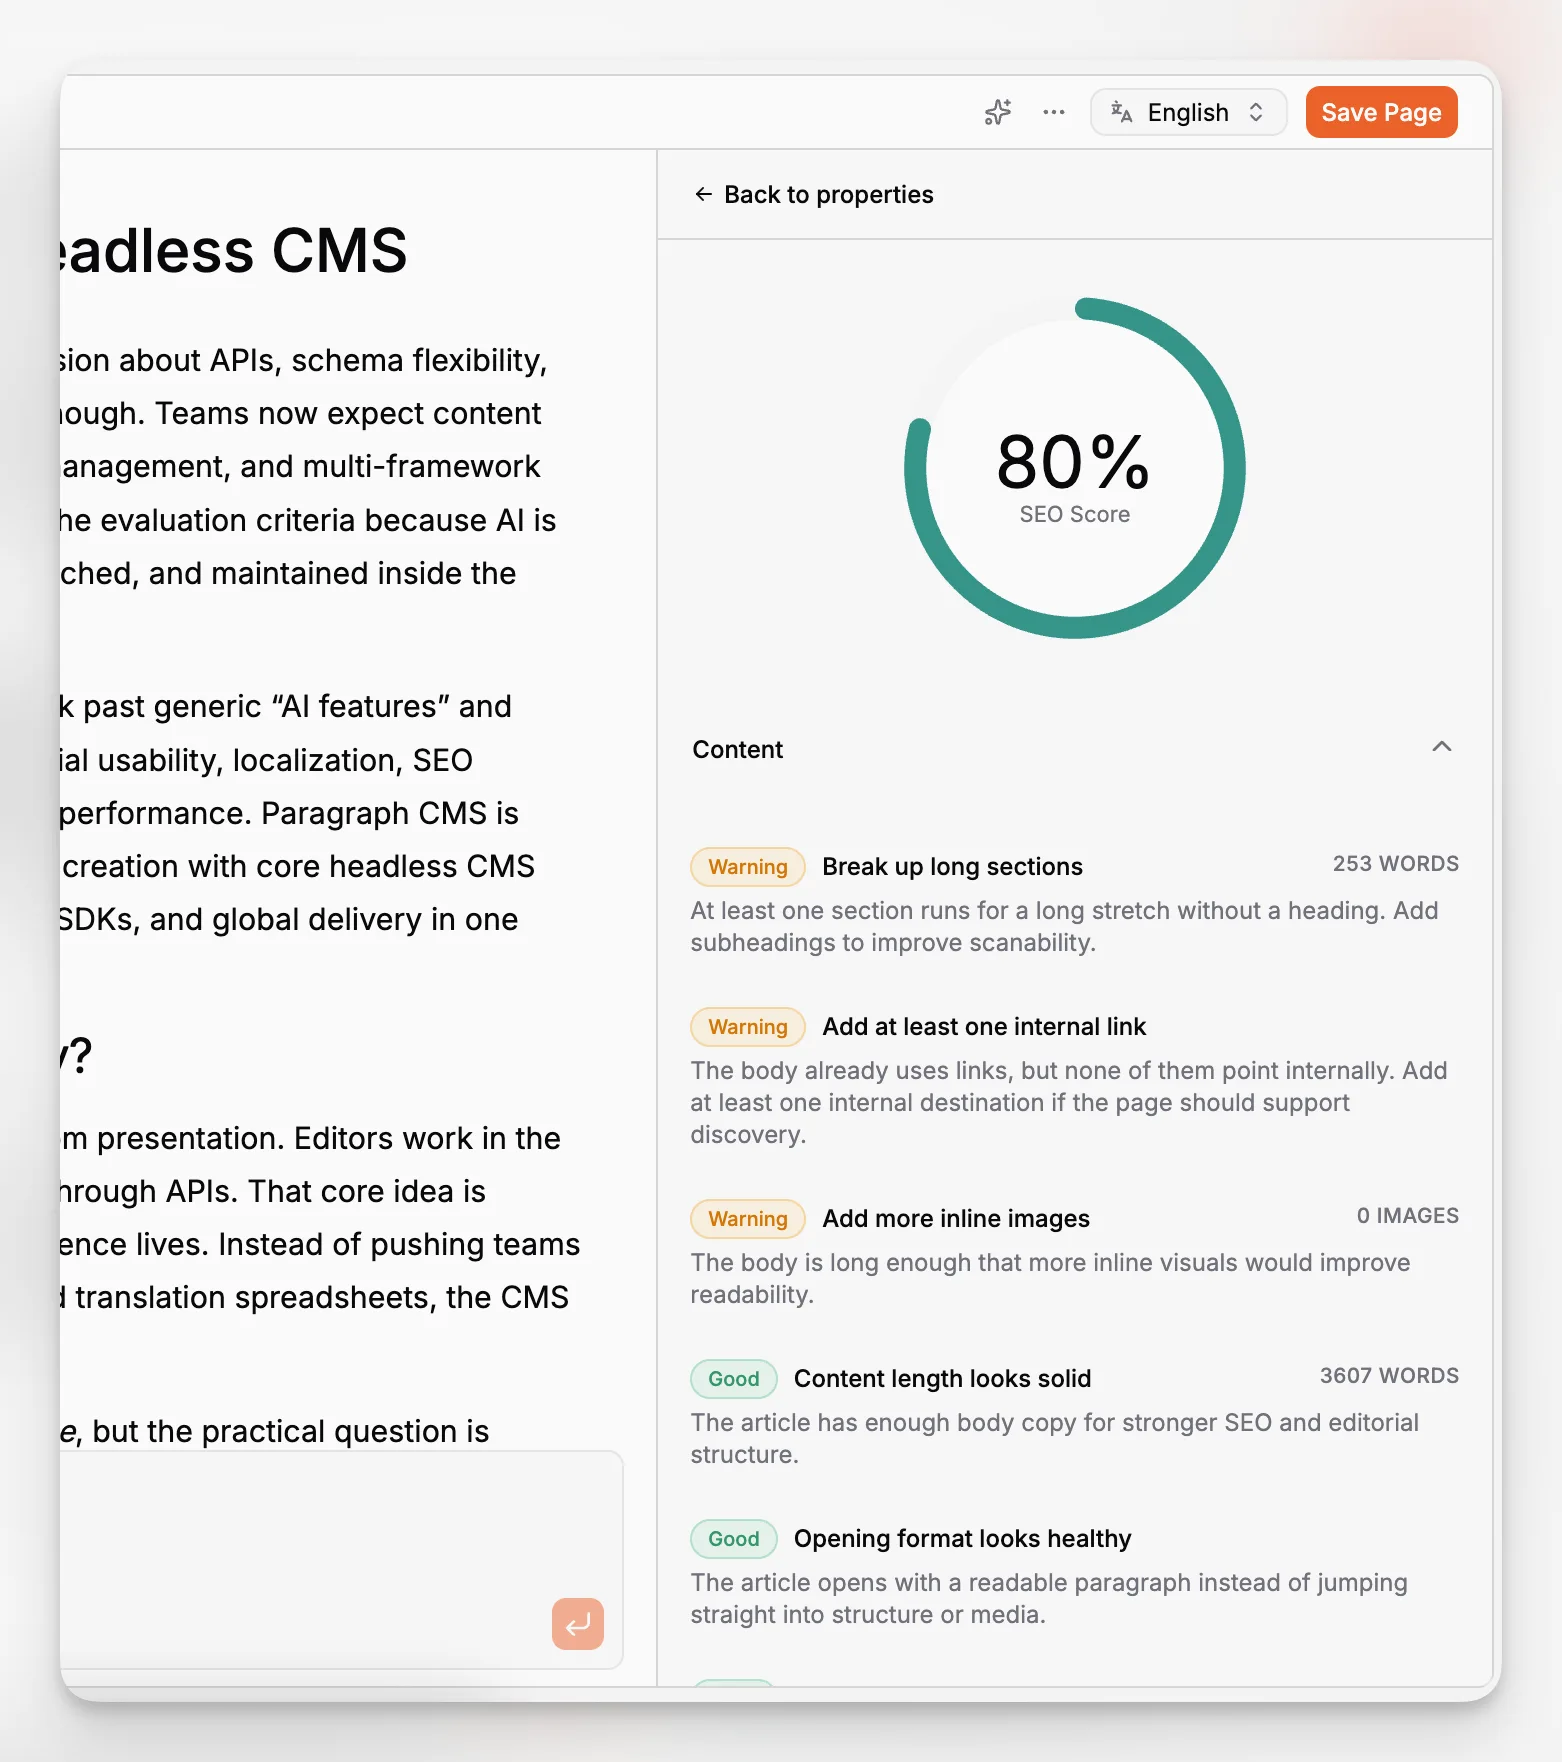
Où l’IA aide-t-elle réellement, et où faut-il être prudent ?
C’est la partie que beaucoup d’articles réduisent à un optimisme facile ou à un cynisme facile. La réponse la plus utile est plus précise. L’IA aide surtout lorsqu’elle compresse le travail éditorial répétitif, pas lorsqu’elle remplace le jugement éditorial.
Dans un CMS headless natif pour l’IA, les cas d’usage les plus solides sont généralement :
la génération de premier jet à partir d’un brief clair
la réécriture pour la clarté ou le ton
la génération de texte alternatif, de légendes et de slugs
la suggestion de variantes de métadonnées
le résumé de longues sources dans des champs structurés
la traduction et la retraduction des mises à jour de contenu
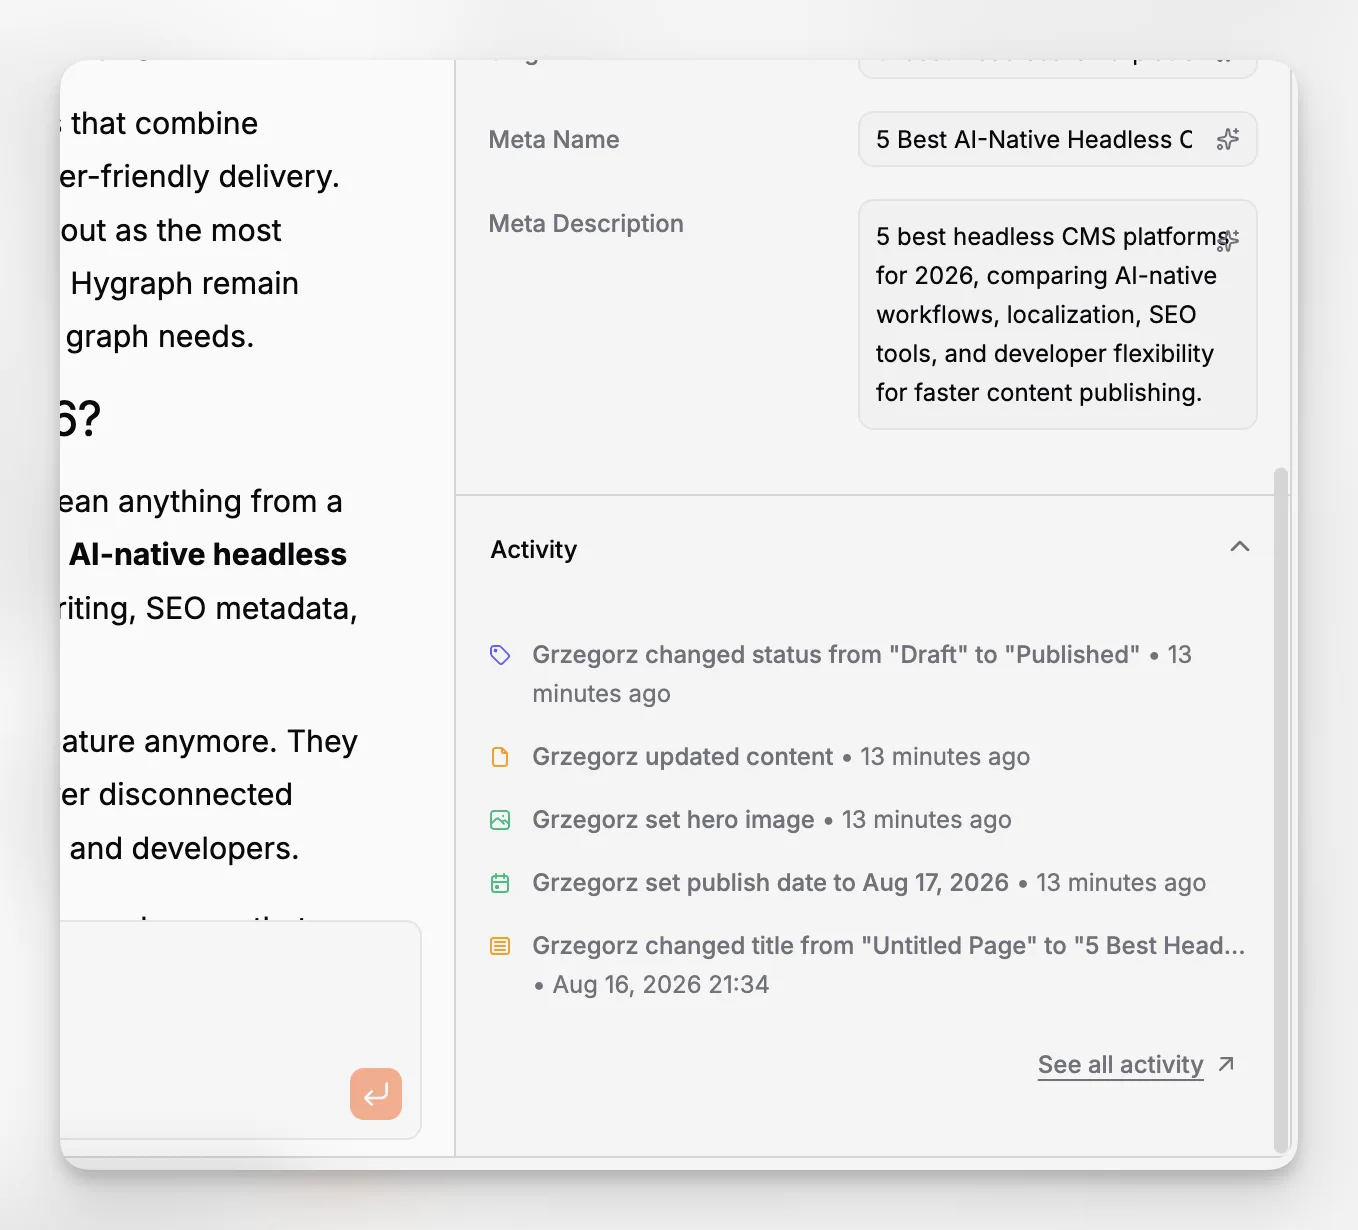
Ce sont des tâches à fort levier, car elles font gagner du temps sans vous obliger à externaliser la stratégie. Paragraph CMS décrit publiquement un chat IA intégré, une édition assistée par IA, une assistance SEO générative pour les métadonnées et le texte d’image, ainsi que des workflows de traduction. Cette combinaison est particulièrement utile pour les équipes contenu qui cherchent à standardiser la production sans faire sonner toutes les pages de la même façon.
Il existe néanmoins de vraies limites. L’IA est une couche de rédaction et d’accélération, pas une couche de vérité. Il ne faut pas lui faire confiance pour inventer des affirmations, des sources, des faits produit, des déclarations juridiques ou des promesses de performance. Elle a aussi tendance à sur-généraliser l’intention de recherche lorsque le brief n’est pas précis.
Un meilleur principe de fonctionnement est simple :
laisser l’IA créer un texte candidat
laisser les humains valider la spécificité, le ton et les affirmations
laisser le CMS préserver la structure et la discipline du workflow
Comment la localisation et les workflows multilingues affectent-ils le SEO ?
La localisation est souvent traitée comme un problème de contenu distinct. C’est aussi un problème SEO. Les pages internationales échouent lorsque les équipes publient des traductions automatiques maigres, oublient de mettre à jour les variantes traduites après des modifications de la source, ou perdent la trace des métadonnées propres à chaque langue.
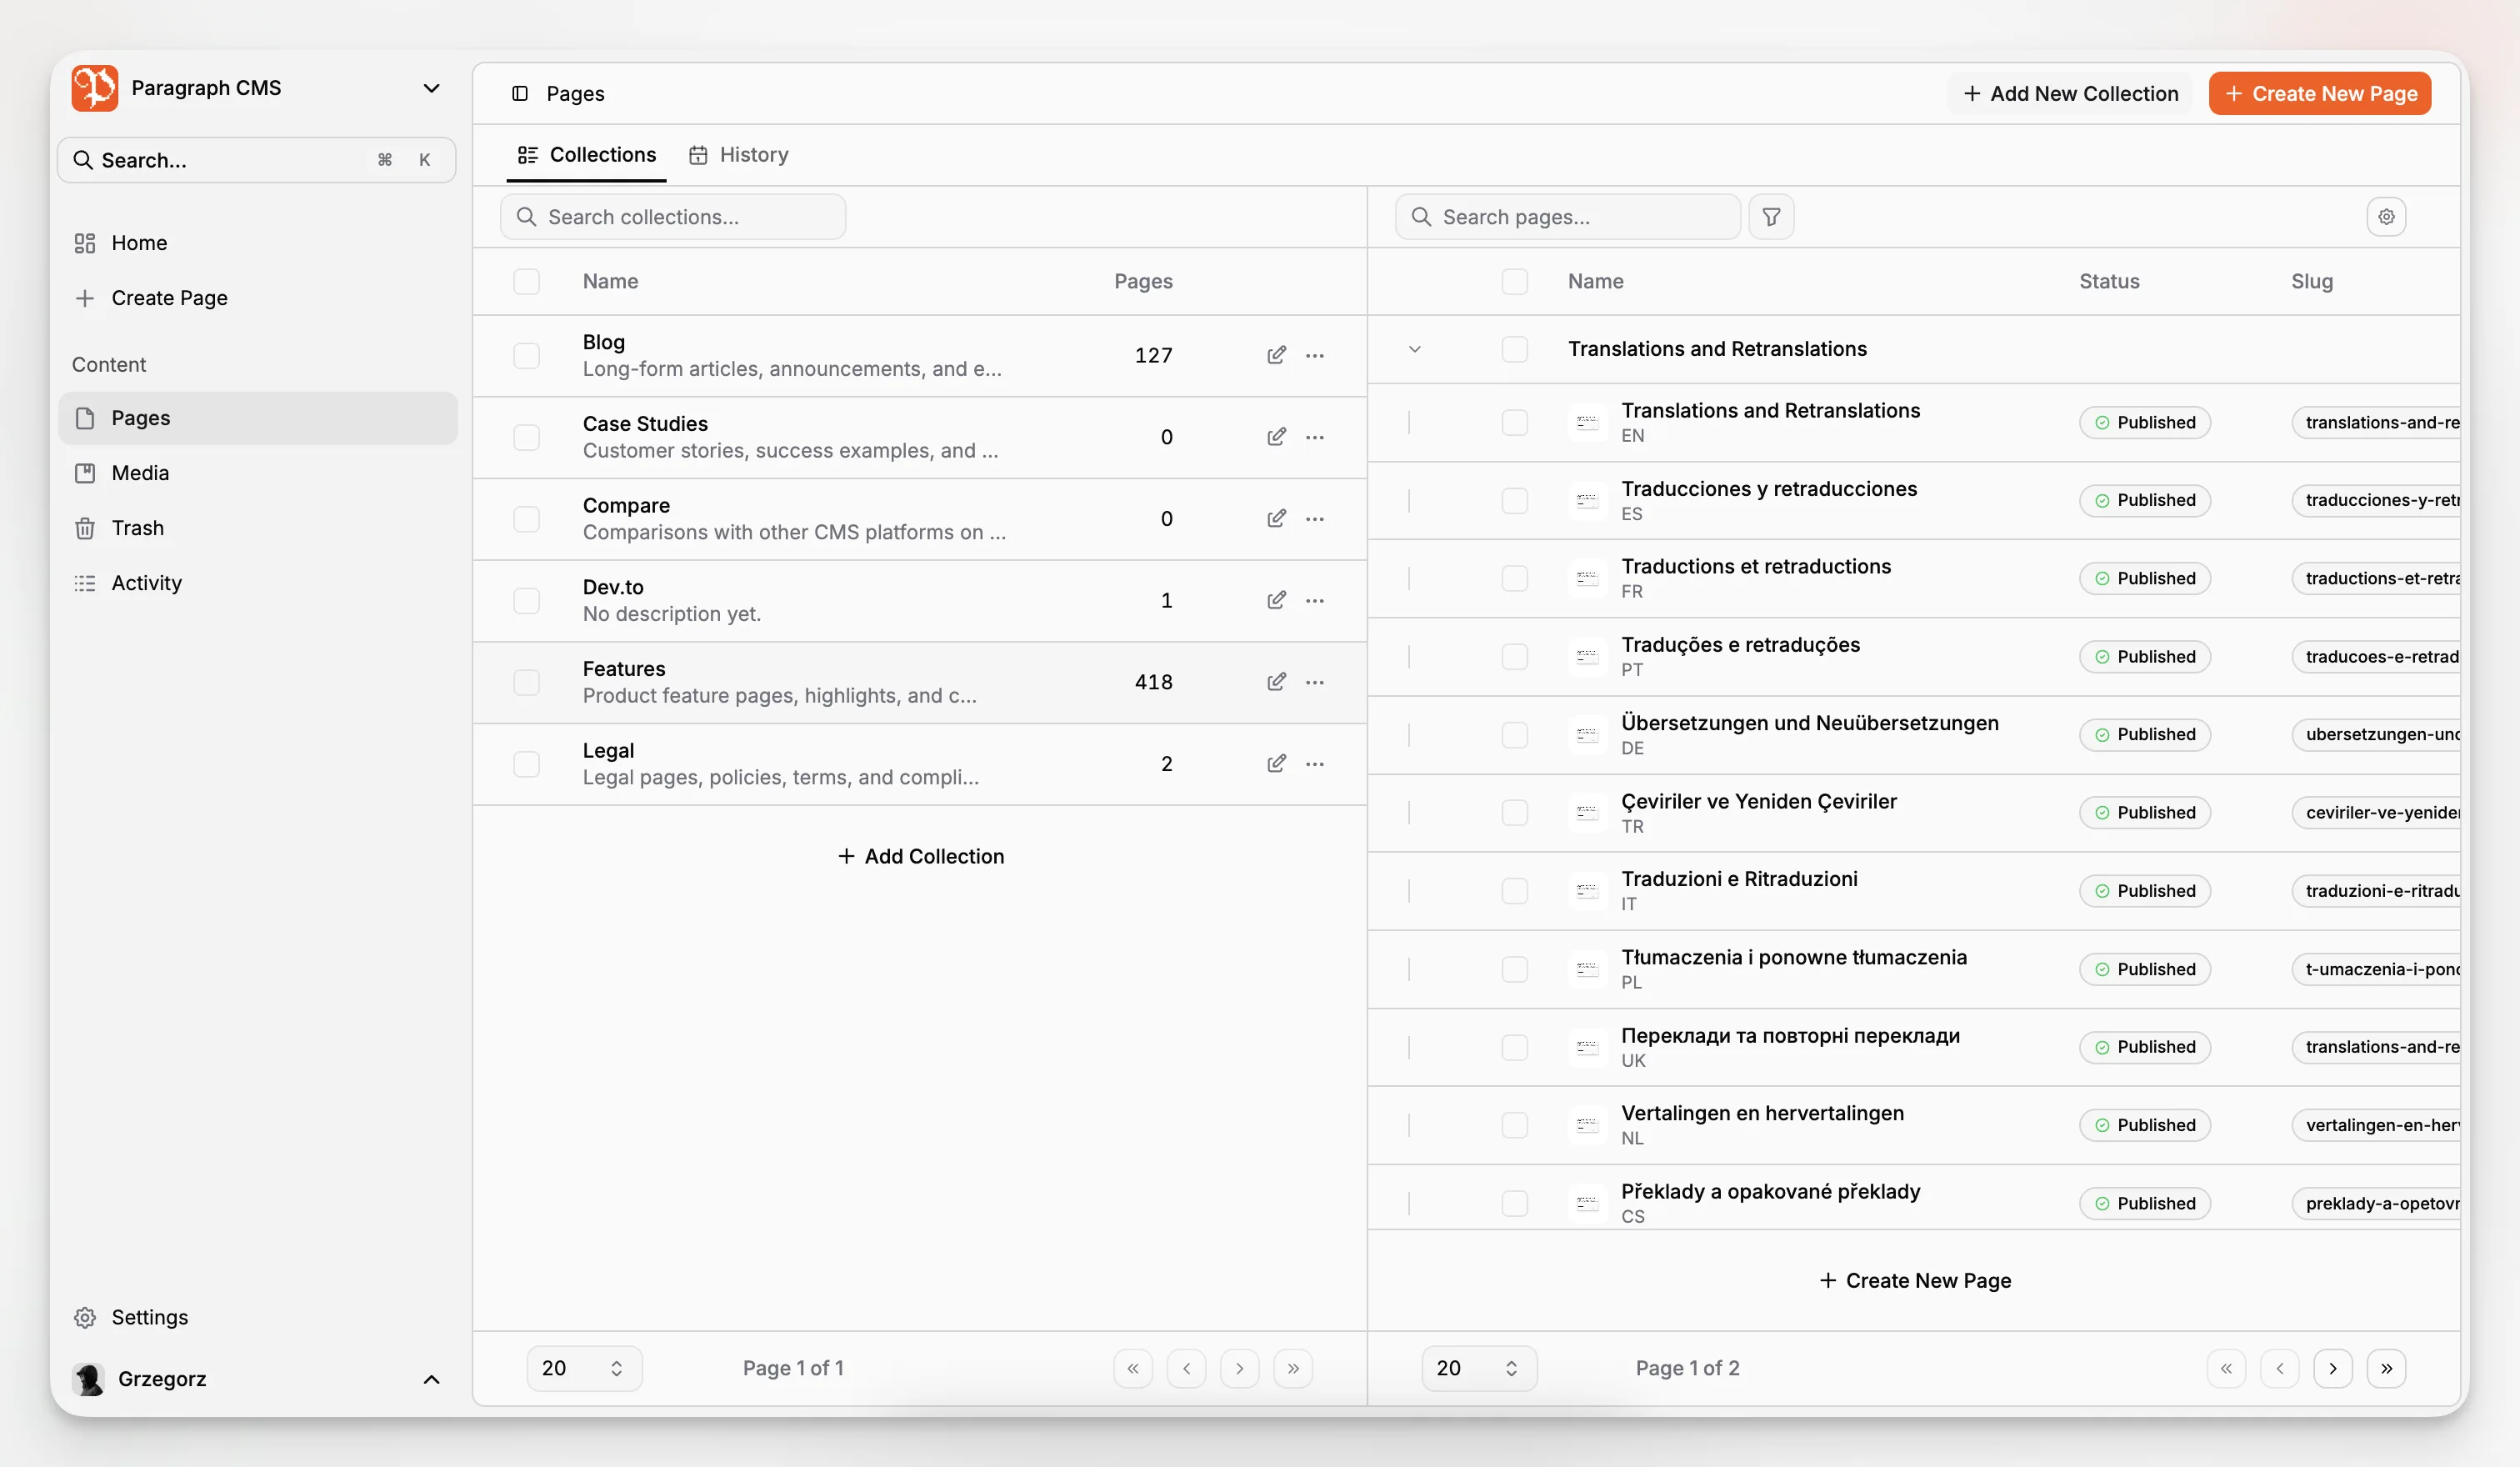
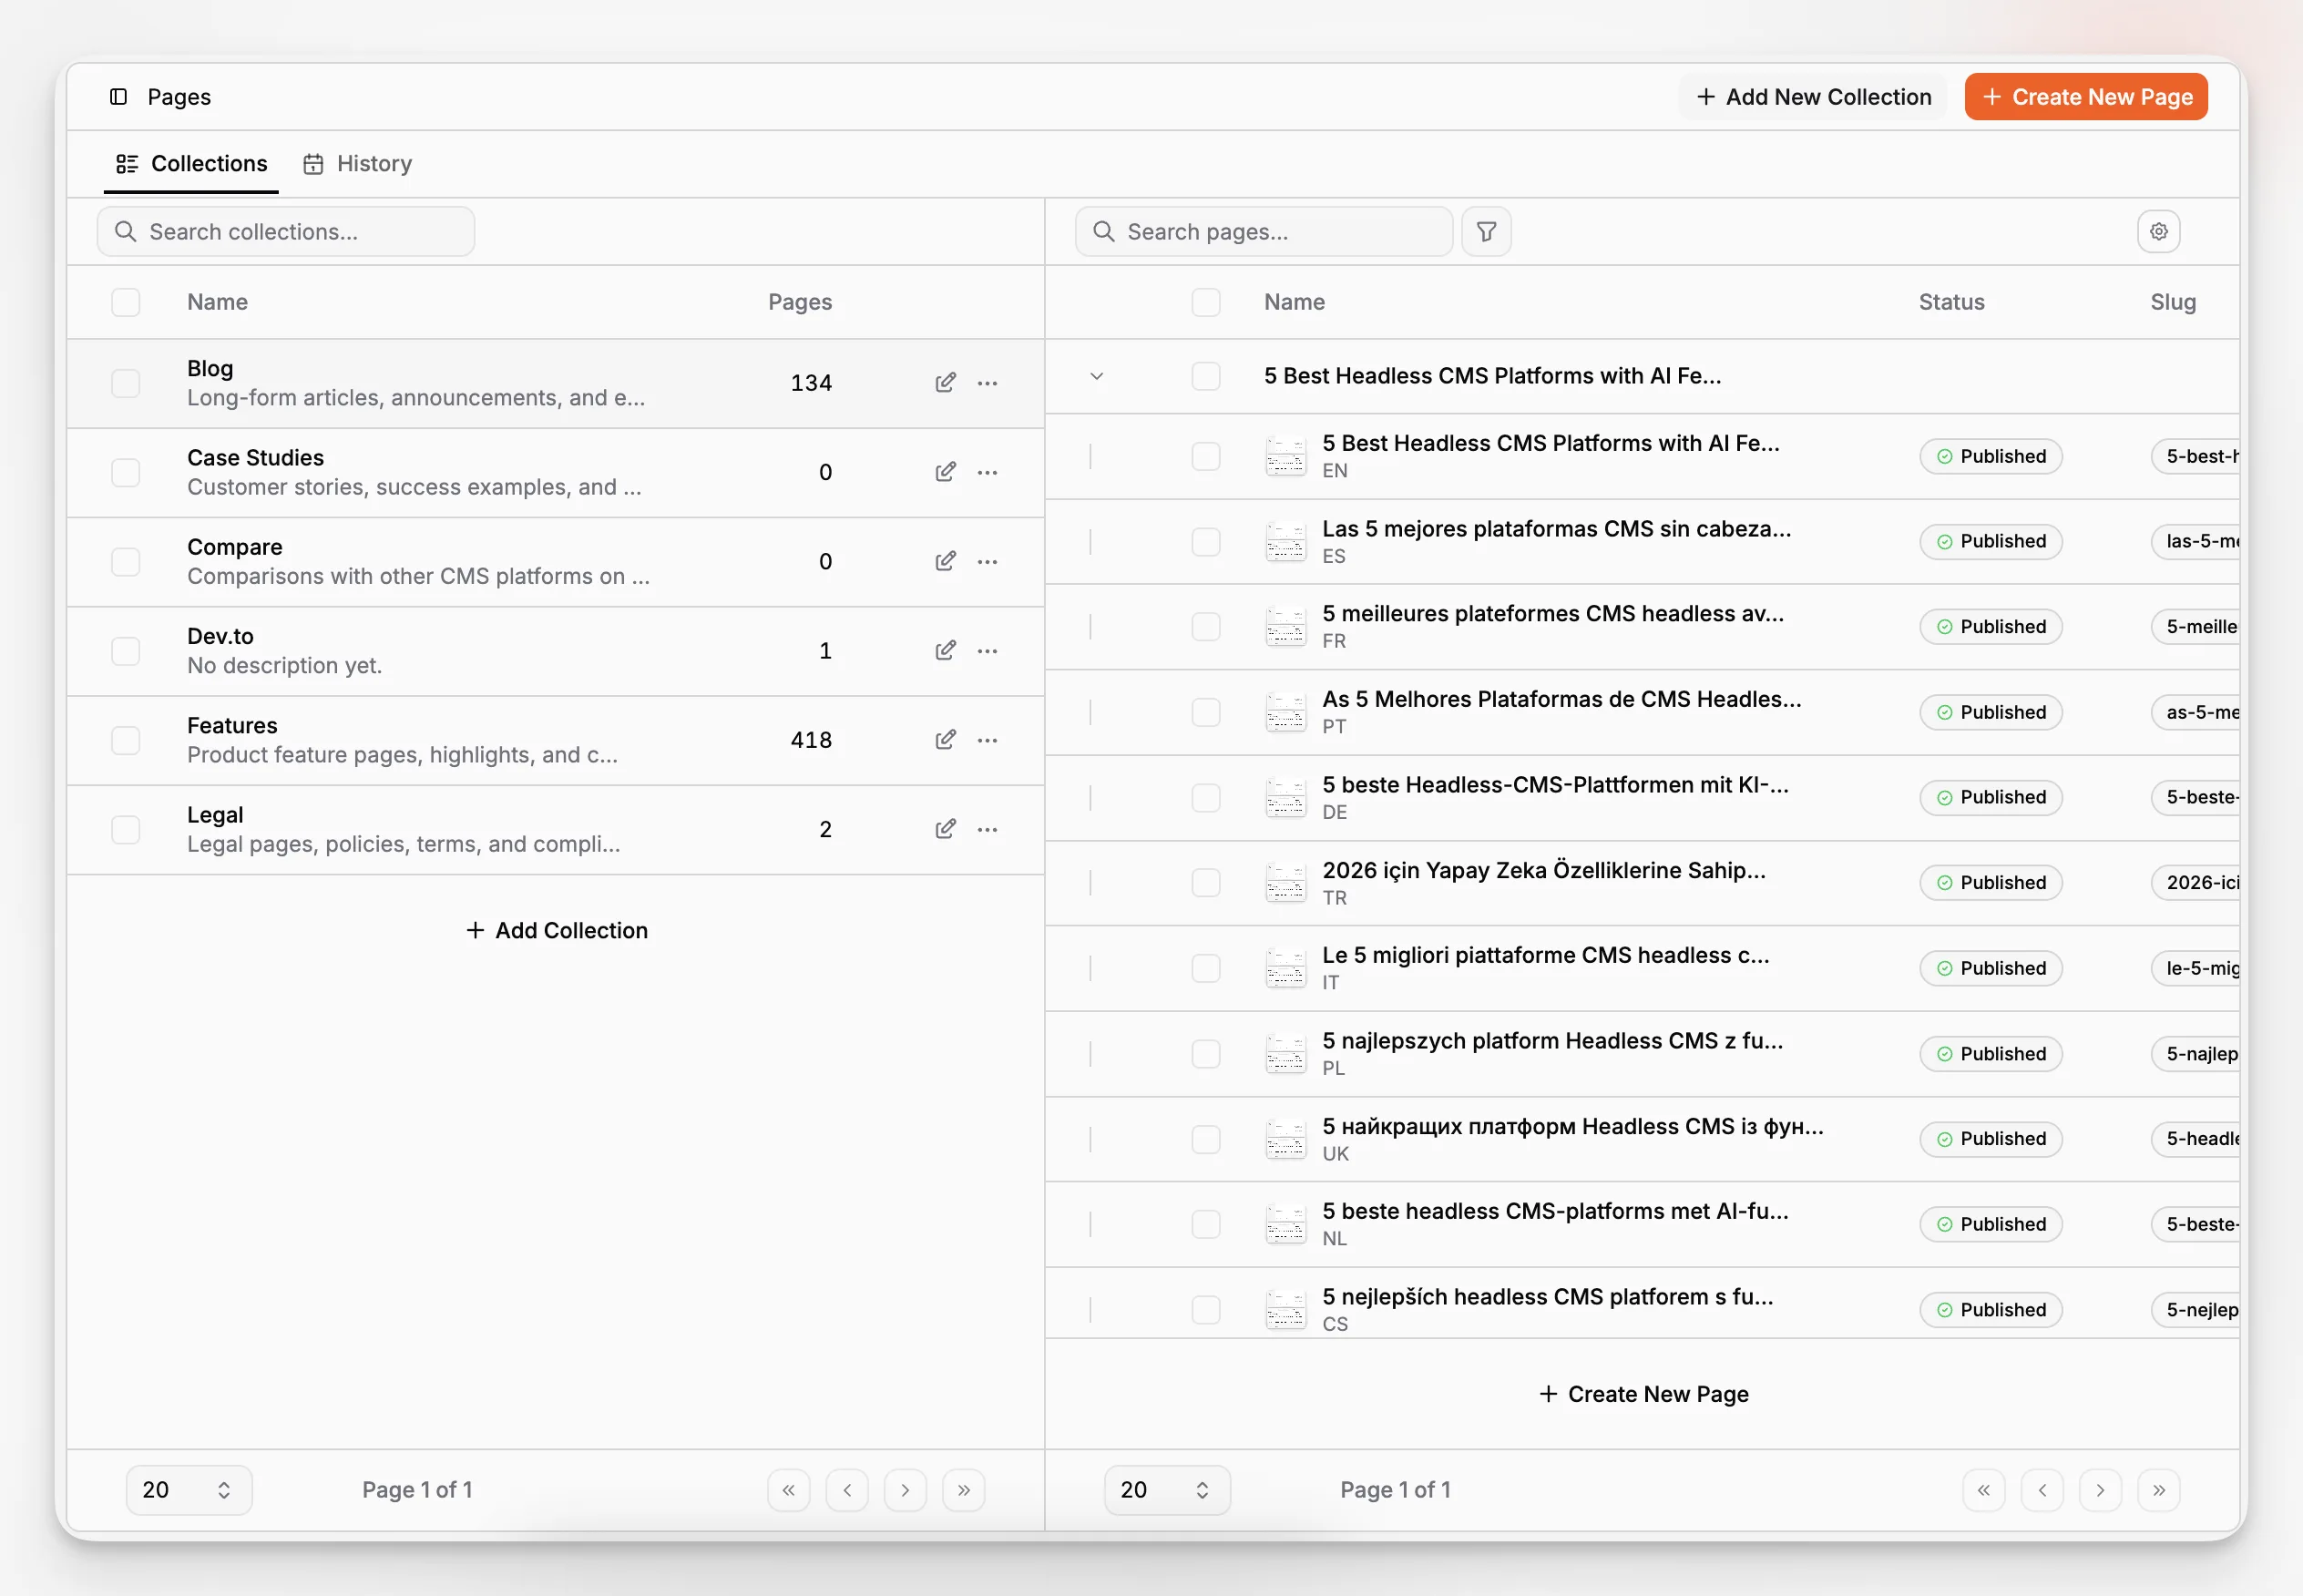
Un CMS headless natif pour l’IA peut aider ici s’il prend en charge plus qu’une traduction ponctuelle. Ce qui compte, c’est le workflow complet : contenu source, versions traduites, historique des révisions et retraduction efficace lorsque l’original change. Paragraph CMS mentionne publiquement la traduction en un clic dans plus de 75 langues et la prise en charge de la retraduction, ce qui correspond bien aux besoins éditoriaux multilingues réels.
Cela compte parce que le SEO multilingue ne se résume pas au volume de traduction. Il dépend de la capacité de chaque langue à maintenir :
des titres et descriptions pertinents pour la recherche
des schémas d’URL propres
un contenu localisé sur la page
des médias et légendes cohérents si nécessaire
des mises à jour synchronisées après des révisions de la source
Pour des normes de mise en œuvre multilingue plus larges, les équipes doivent toujours travailler avec des modèles d’internationalisation côté développeur et la documentation pour la recherche, mais le CMS devrait réduire la friction éditoriale plutôt que l’augmenter.
Quel rôle la gestion des médias joue-t-elle dans le SEO headless ?
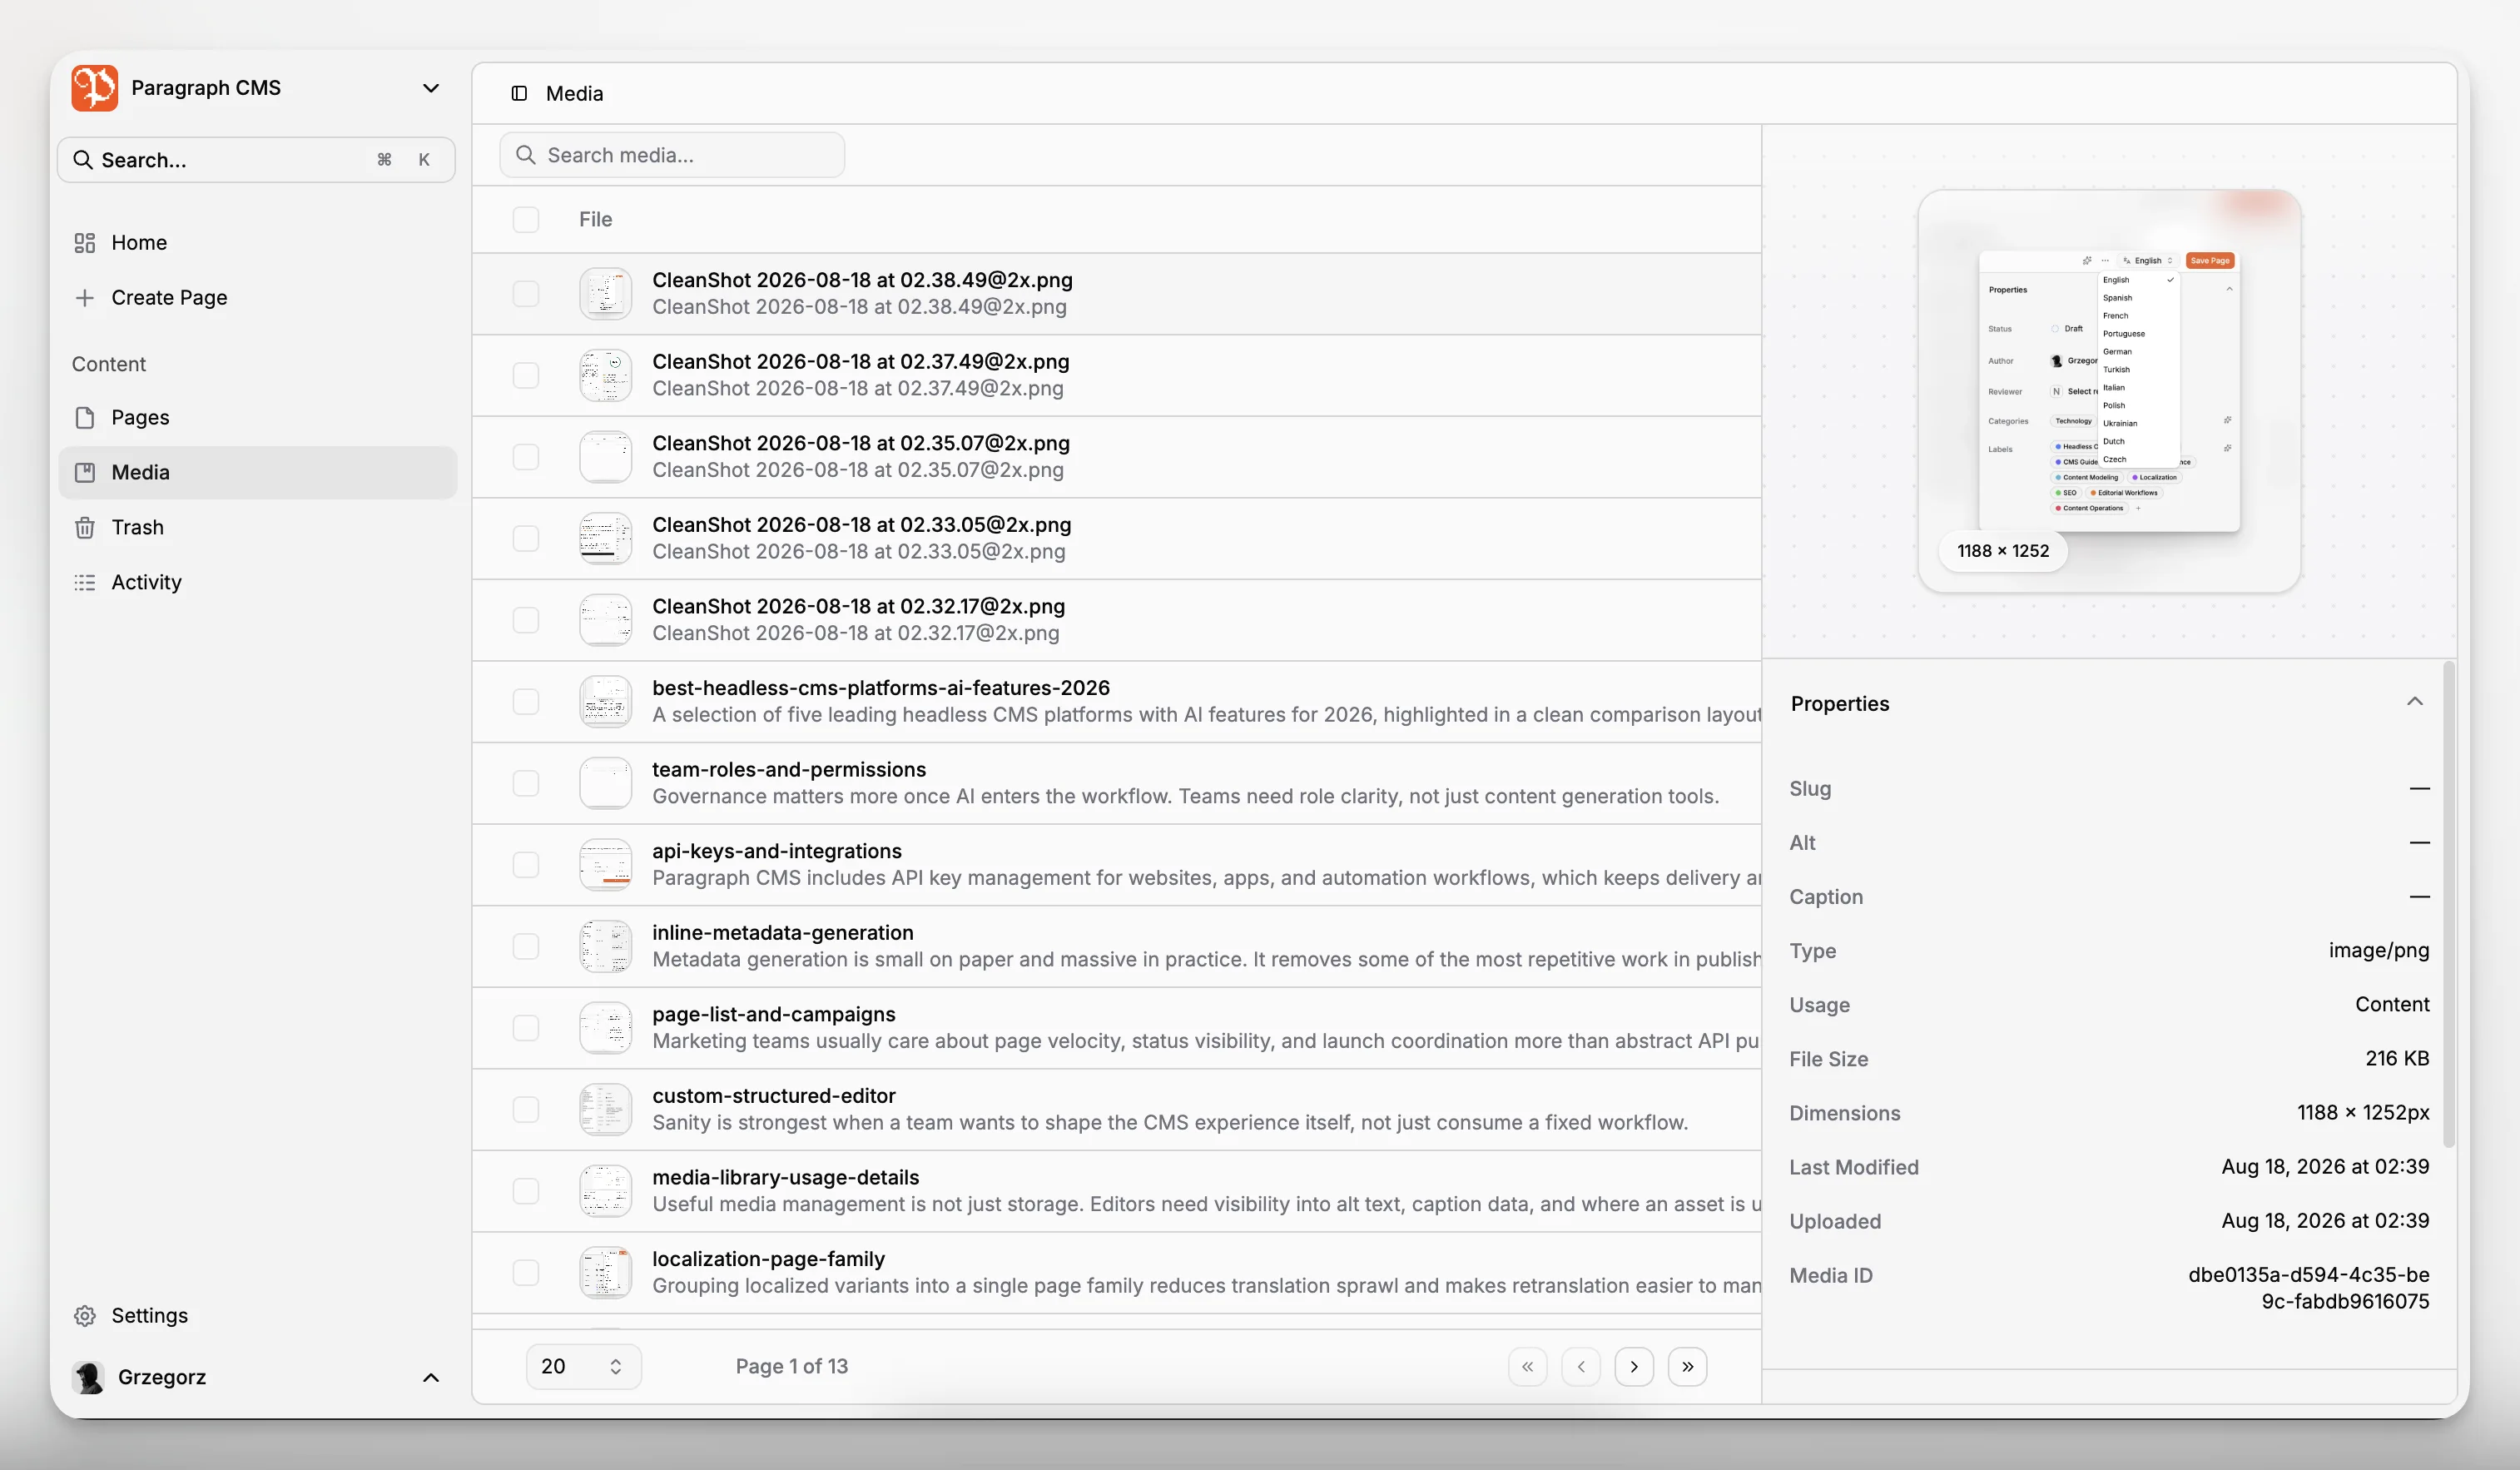
Les médias sont l’un des endroits les plus faciles où laisser fuiter la qualité. Les équipes téléversent des ressources dans un outil, écrivent les légendes ailleurs, laissent le texte alternatif vide, puis finissent par casser des URLs lors d’un nettoyage. La performance dans la recherche ne dépend pas d’un seul champ image, mais la qualité des médias affecte l’accessibilité, la clarté de la page et la cohérence.
Paragraph CMS met en avant la gestion des médias, la diffusion publique, la mise en cache edge, les images auto-optimisées et une fenêtre de rétention qui aide à éviter les URLs de médias cassées lorsque des ressources sont remplacées. Ce ne sont pas des détails anodins. Une gestion stable des ressources protège les pages existantes contre des régressions évitables.
Pour des opérations de contenu attentives au SEO, les questions utiles sont :
Les éditeurs peuvent-ils ajouter un texte alternatif descriptif sans quitter le workflow ?
Les URLs d’images sont-elles assez stables pour éviter les ruptures accidentelles ?
Les légendes et les médias hero sont-ils traités de manière cohérente selon les types de contenu ?
L’optimisation est-elle gérée centralement ou manuellement par chaque éditeur ?
La documentation de Google pour les développeurs souligne à plusieurs reprises que les contenus non textuels bénéficient d’un support descriptif approprié et d’un contexte de page compréhensible. La gestion des médias dans le CMS est l’un des moyens les plus simples d’opérationnaliser cela.
Comment les développeurs et les éditeurs doivent-ils se partager la responsabilité du SEO ?
L’un des avantages discrets des systèmes headless est la clarté des rôles, mais seulement si l’organisation la définit réellement. Trop d’équipes finissent avec l’inverse : les éditeurs supposent que les développeurs gèrent le SEO, les développeurs supposent que les éditeurs en sont responsables, et personne ne possède les manques.
Un modèle plus propre consiste à répartir les responsabilités par couche.
Les éditeurs sont généralement responsables de :
l’alignement sur l’intention de recherche
la qualité des titres et des meta descriptions
le maillage interne dans le contenu
les modules FAQ et les blocs de contenu de soutien
la sélection des images, les légendes et la revue du texte alternatif
la revue de la localisation et la cohérence éditoriale
Les développeurs sont généralement responsables de :
le rendu des templates et le HTML explorable
l’implémentation du schéma
la logique canonique et d’indexation
le comportement du sitemap et de robots
la performance et le comportement du framework
le routage, les codes de statut, les redirections et les systèmes de prévisualisation
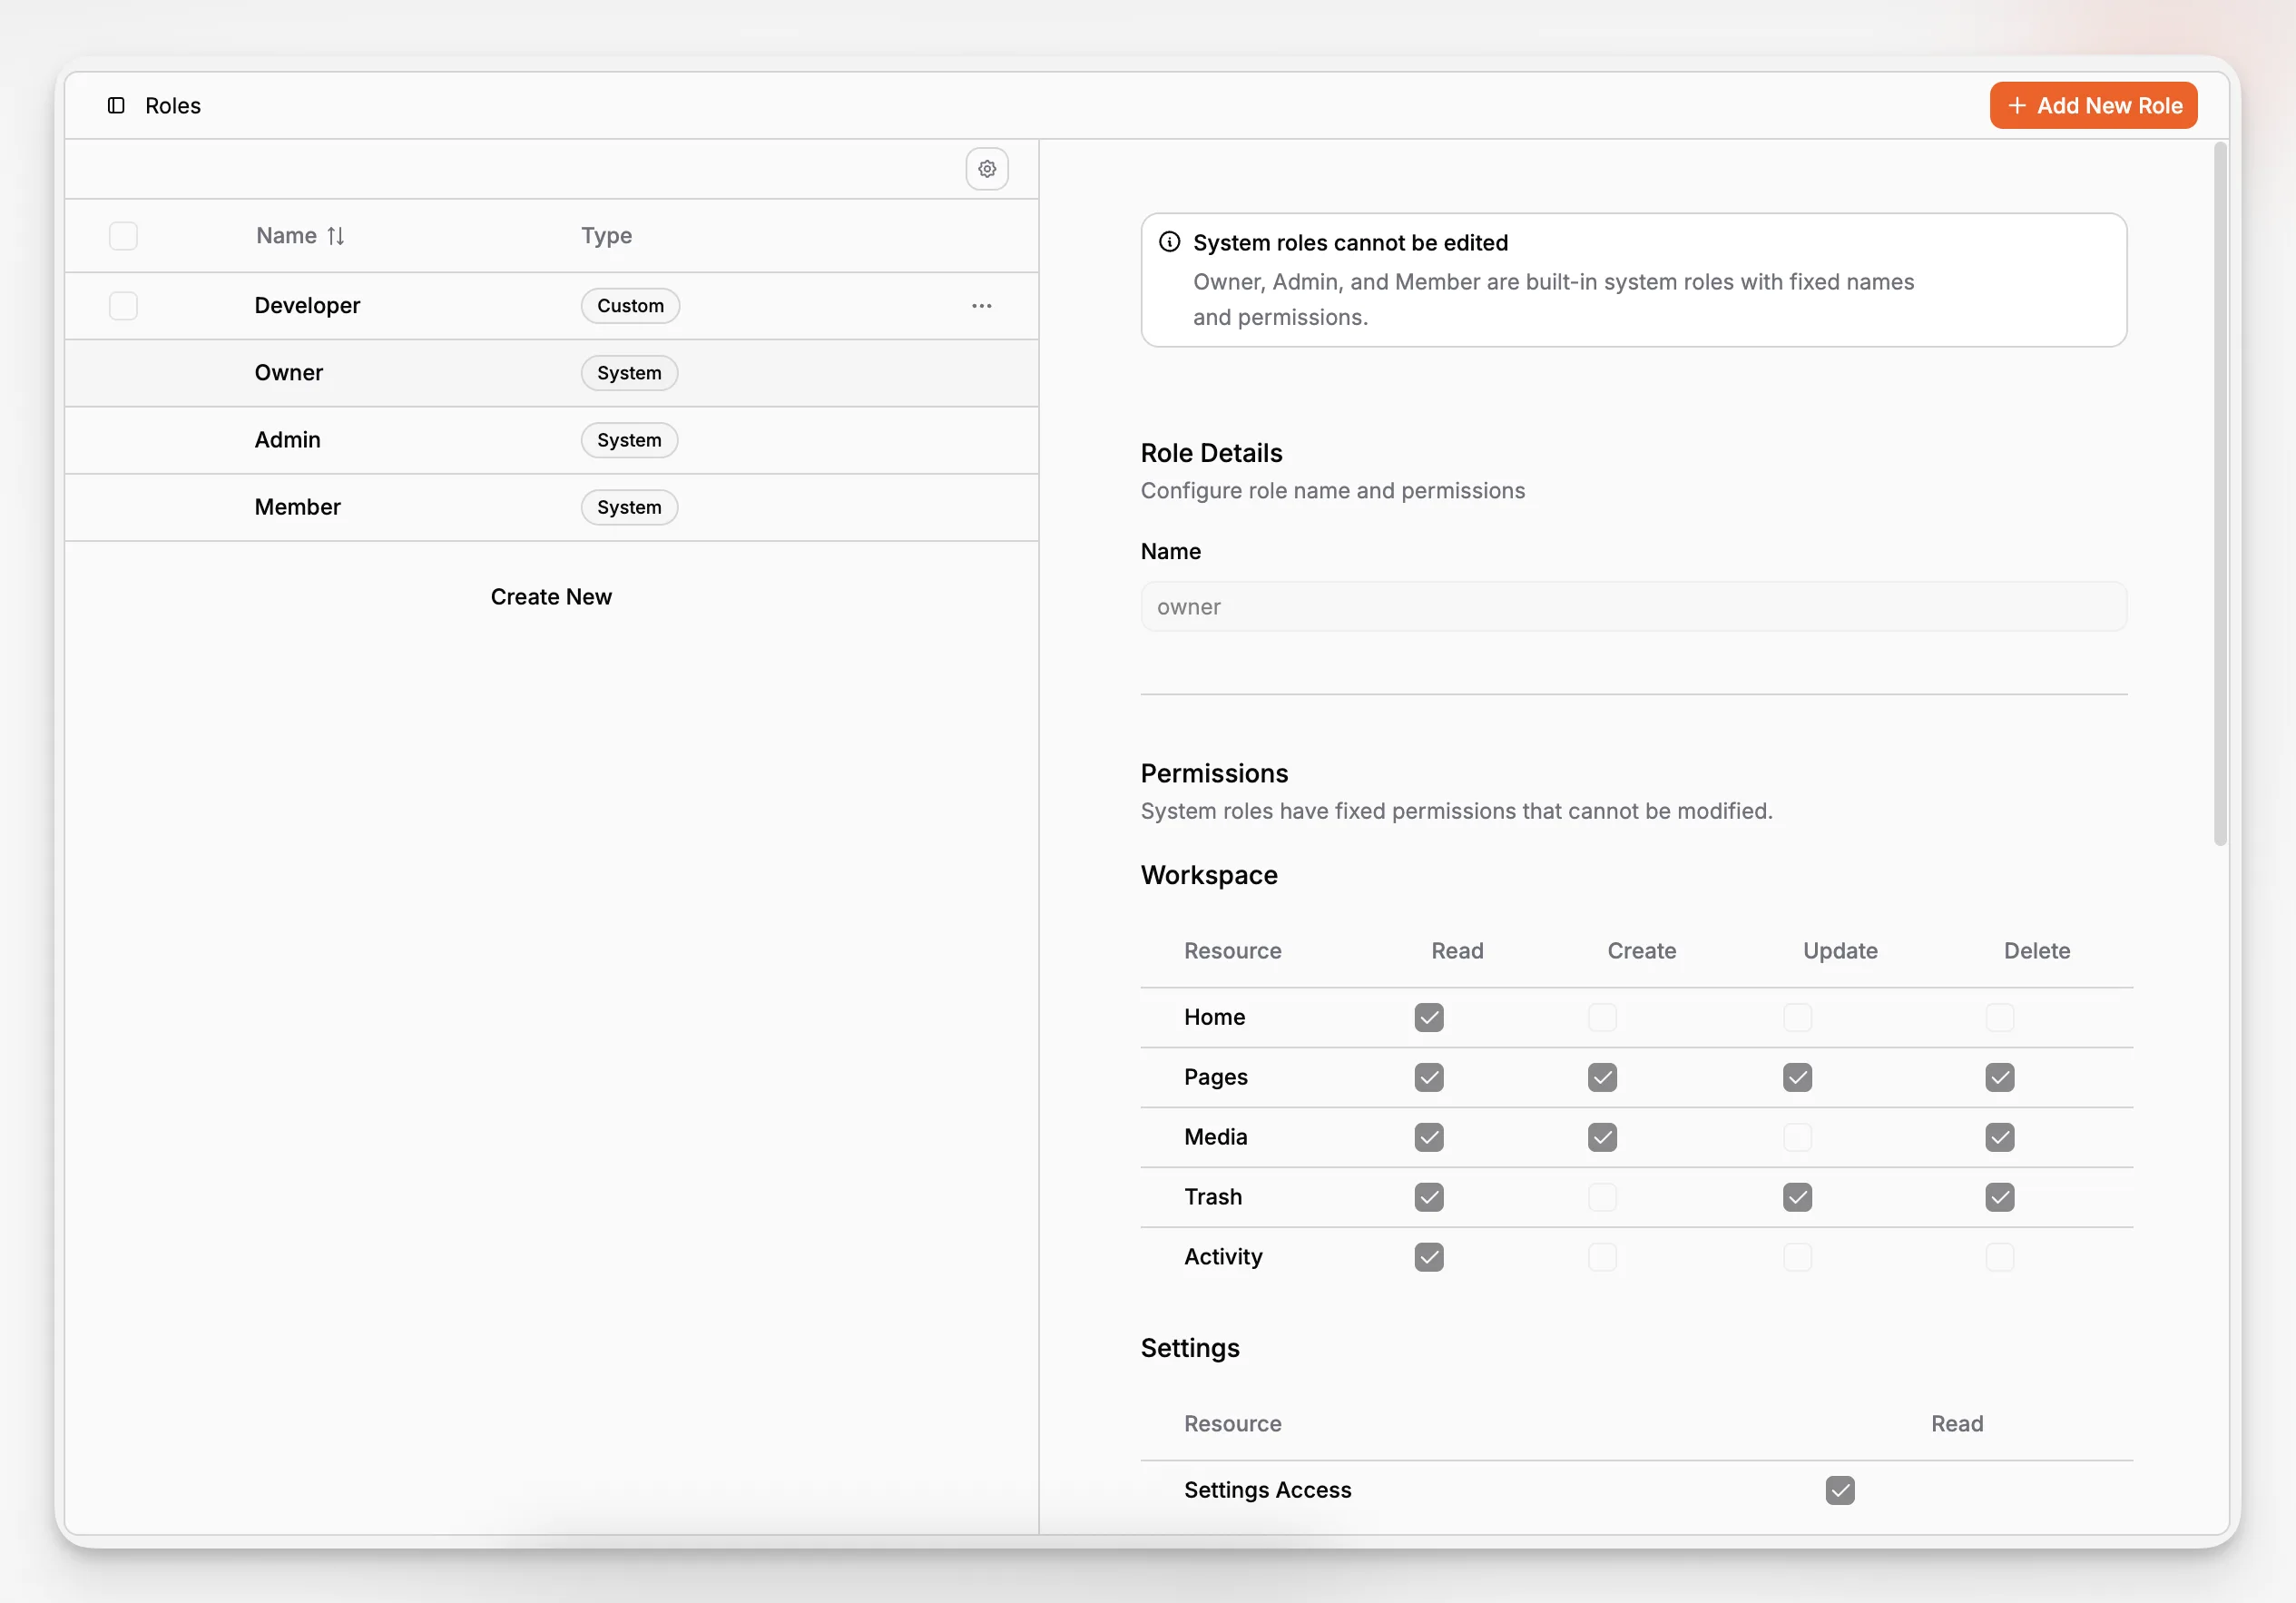
Le CMS doit prendre en charge les deux côtés en rendant la structure du contenu explicite et les autorisations claires. Paragraph CMS inclut publiquement des fonctionnalités de rôles, d’équipes et d’autorisations, ce qui est utile parce que les problèmes de gouvernance ont tendance à apparaître précisément lorsque le volume de contenu commence à croître.
Quels problèmes de SEO technique restent en dehors du CMS ?
Même un CMS solide ne remplace pas l’implémentation du SEO technique. C’est là que certains discours marketing du secteur deviennent flous. Un CMS headless peut faciliter la prise en charge du SEO technique, mais votre couche de diffusion contrôle encore de nombreux facteurs décisifs.
Vous devez encore bien gérer les points suivants :
une sortie côté serveur ou pré-rendue lorsque c’est approprié
les balises canoniques et les règles d’indexation
la logique de pagination et de navigation à facettes
les redirections et la gestion du cycle de vie des URLs
le travail sur les Core Web Vitals et la performance
les données structurées rendues de manière à pouvoir être analysées par les moteurs de recherche
les règles d’inclusion dans le sitemap et les directives robots
Paragraph CMS mentionne publiquement un sitemap auto-généré, robots et des fichiers prêts pour les LLM, ce qui est utile sur le plan opérationnel. Mais ces fonctionnalités sont plus efficaces lorsqu’elles sont associées à une implémentation front-end solide. Les moteurs de recherche classent des pages, pas des catégories de produits.
Pour les équipes qui utilisent des piles JavaScript modernes, la valeur d’un CMS réside dans le fait de donner aux développeurs une API de contenu prévisible et aux éditeurs des champs fiables à renseigner. Le résultat réel dans la recherche dépend de la façon dont ce contenu arrive au navigateur et au robot d’exploration.
Quelles sont les erreurs SEO les plus courantes avec un CMS headless ?
C’est ici que de nombreuses migrations sous-performent. L’architecture est moderne, mais le processus est désordonné.
Traiter le SEO comme un ajout après coup
Si les champs SEO et les règles de rendu sont ajoutés après le lancement, ils tendent à rester incohérents. Modélisez-les avant que le volume ne s’accumule.
Utiliser un seul champ pour tout
Un seul champ « titre » ou « description » crée des compromis qui se propagent à travers les templates, les aperçus sociaux et la sortie destinée aux SERP.
Laisser l’IA générer des affirmations non relues
L’IA peut faire gagner du temps. Elle peut aussi introduire du remplissage, des répétitions ou une dérive factuelle. Utilisez-la pour accélérer, pas pour publier à l’aveugle.
Ignorer la gouvernance de la localisation
Traduire sans workflows de mise à jour conduit à des pages internationales obsolètes. La prise en charge de la retraduction compte plus que les équipes ne l’imaginent au départ.
Ne pas planifier la stabilité des URLs et des médias
Les chemins de ressources cassés, les changements fréquents de slug et la dette de redirection sont des problèmes headless courants parce que la responsabilité est distribuée.
Se concentrer trop sur les fonctionnalités plutôt que sur les opérations
Une longue liste de fonctionnalités ne garantit pas un bon SEO. La meilleure question est de savoir si le CMS prend en charge un processus de publication répétable que les éditeurs peuvent réellement maintenir.
Comment Paragraph CMS peut-il s’intégrer dans un workflow SEO pratique ?
Le cas d’usage le plus convaincant pour Paragraph CMS n’est pas « utilisez l’IA parce que l’IA est tendance ». C’est d’utiliser un CMS headless natif pour l’IA afin de raccourcir la distance entre la stratégie de contenu et la qualité de publication.
Un workflow raisonnable dans Paragraph CMS pourrait ressembler à ceci :
Définir des modèles de page structurés pour les articles, les landing pages et les ressources evergreen.
Rédiger le contenu dans l’éditeur avec une assistance IA pour le développement du plan ou une première version.
Remplir des champs SEO dédiés pour le titre, la description, le slug, le hero et les modules de soutien.
Utiliser l’aide IA intégrée pour proposer du texte alternatif, des légendes, des résumés ou des réécritures si nécessaire.
Traduire ou retraduire les versions localisées à mesure que la page source évolue.
Vérifier les autorisations et les statuts avant publication.
Diffuser le contenu via le framework front-end de votre choix avec des standards de SEO technique appliqués dans les templates.
Ce workflow est attractif parce qu’il maintient la création éditoriale, l’hygiène des métadonnées, la gestion des médias et la localisation proches les unes des autres. Pour les équipes en croissance, cela compte généralement plus que de courir après des fonctionnalités ponctuelles isolées.
Il correspond aussi au positionnement public du produit autour de workflows centrés sur l’éditeur, du contenu structuré, des outils SEO, de la localisation, de la prise en charge des frameworks modernes et d’une diffusion évolutive.
Comment évaluer si un CMS headless est bon pour le SEO avant une migration ?
La plupart des conversations d’achat restent trop abstraites. Demandez des preuves en termes de workflow, pas seulement de catégories de fonctionnalités.
Utilisez des questions comme celles-ci :
Les éditeurs peuvent-ils gérer les champs SEO au niveau de la page sans intervention des développeurs ?
Le modèle de contenu peut-il séparer les champs destinés à la recherche de la présentation sur la page ?
La plateforme prend-elle en charge la localisation et les mises à jour de contenu efficaces entre les langues ?
Comment les médias, les légendes et le texte alternatif sont-ils gérés ?
Quelles autorisations existent pour l’édition, la relecture et la publication ?
Dans quelle mesure le CMS s’adapte-t-il au framework que vos développeurs utilisent déjà ?
Quelles responsabilités de SEO technique restent dans le front end ?
Le workflow peut-il réduire les allers-retours de copier-coller entre les outils IA, les documents et les écrans du CMS ?
Une bonne réponse n’est pas seulement oui ou non. C’est de savoir si l’expérience d’édition quotidienne du produit aide votre équipe à produire de meilleures pages avec moins d’échecs de transmission.
Si votre stack dépend déjà du contenu structuré et de frameworks front-end modernes, l’intérêt d’un CMS headless natif pour l’IA devient plus fort lorsque l’équipe éditoriale porte aussi des attentes SEO. C’est le créneau dans lequel Paragraph CMS semble particulièrement pertinent.
Le SEO d’un CMS headless vaut-il le coup pour les petites équipes ?
Parfois oui, parfois non. Les petites équipes peuvent beaucoup bénéficier de l’architecture headless lorsqu’elles ont besoin de vitesse, de flexibilité, de localisation ou de réutilisation multicanale du contenu. Mais elles peuvent aussi acheter une complexité excessive.
Le SEO d’un CMS headless vaut surtout le coup lorsque :
l’architecture de votre site change souvent
vos développeurs veulent la liberté de framework
vos types de contenu ont besoin d’une structure propre
votre équipe publie dans plusieurs langues ou sur plusieurs canaux
vos éditeurs ont besoin de contrôles SEO fiables sans prolifération de plugins
vous voulez une assistance IA dans le CMS plutôt que dans des outils déconnectés
C’est moins convaincant si votre site est simple, votre cadence de publication faible et que votre CMS monolithique actuel fonctionne déjà bien. L’idée n’est pas que headless soit universellement meilleur. L’idée est que headless plus une conception solide du workflow peut surpasser une configuration traditionnelle lorsque vos opérations de contenu ont dépassé des processus bricolés.
Le véritable avantage SEO, c’est la cohérence opérationnelle
La meilleure raison de s’intéresser au SEO d’un CMS headless n’est pas la nouveauté. C’est la cohérence. Le succès dans la recherche se cumule généralement grâce à une discipline ordinaire répétée à grande échelle : des champs propres, des pages utiles, des métadonnées sensées, des URLs stables, un bon maillage interne, une maintenance localisée et des standards de publication prévisibles.
Un CMS headless natif pour l’IA peut renforcer cette discipline lorsqu’il réduit l’effort manuel sans réduire le contrôle éditorial. Paragraph CMS se distingue parce que son ensemble de fonctionnalités publiques est particulièrement aligné sur ces besoins SEO du quotidien : édition assistée par IA, génération de pages, aide aux métadonnées, localisation, contrôles SEO de page, gestion des médias, contenu structuré, autorisations et diffusion prête pour les frameworks.
Cela n’en fait pas un raccourci. Cela en fait un meilleur environnement de fonctionnement pour les équipes qui comprennent déjà que le SEO est un système.
Qu’est-ce qui différencie le SEO d’un CMS headless du SEO d’un CMS classique ?
Les principes de classement sont en grande partie les mêmes, mais la mise en œuvre change. Dans une configuration headless, la structure du contenu, la logique de rendu, les champs de métadonnées et la collaboration avec les développeurs deviennent plus explicites. Vous gagnez en flexibilité, mais vous perdez aussi certains garde-fous intégrés que les thèmes et plugins des CMS traditionnels fournissent souvent.
Paragraph CMS est-il utile uniquement pour les grandes équipes de contenu ?
Non. Les petites équipes peuvent en bénéficier si elles ont besoin de contenu structuré, de localisation, de flexibilité front-end moderne ou de workflows assistés par l’IA. La question clé est de savoir si votre processus de publication est assez complexe pour justifier une configuration headless et si la centralisation du travail SEO dans un seul CMS ferait gagner du temps.
L’IA dans un CMS peut-elle remplacer un éditeur SEO ?
Pas de manière fiable. L’IA peut accélérer la rédaction, la réécriture, les suggestions de métadonnées, la génération de texte alternatif et la traduction. Elle doit toujours être relue par un humain capable de vérifier l’exactitude factuelle, l’intention de recherche, le ton et les affirmations spécifiques au produit. Le meilleur usage de l’IA est l’accélération avec supervision, pas la publication autonome.
Que dois-je modéliser en premier pour le SEO dans un CMS headless ?
Commencez par des champs séparés pour le titre, le titre SEO, la meta description, le slug, le média hero, la langue, les modules de corps de contenu et tout composant réutilisable de type FAQ ou auteur. Ces décisions créent des templates plus propres et réduisent les chances que les éditeurs aient à improviser plus tard des éléments critiques destinés à la recherche.
Un CMS headless gère-t-il automatiquement tout le SEO technique ?
Non. Un CMS peut prendre en charge le workflow avec des champs structurés, des contrôles de métadonnées et une automatisation d’accompagnement, mais le front end doit toujours rendre un HTML explorable, les bonnes balises canoniques, les données structurées, les codes de statut, les redirections et les autres exigences techniques. Un bon SEO vient d’un système qui fonctionne ensemble.