CMS sin interfaz con React Router: Cómo funciona
Aprende cómo React Router y un CMS sin interfaz funcionan juntos para ofrecer SSR compatible con SEO, cargadores de rutas y entrega de contenido estructurado.
 Grzegorz
Cuando la gente busca React Router headless CMS, normalmente no está buscando un solo proveedor. Quiere entender una arquitectura de frontend: React Router gestiona las rutas, los loaders, el renderizado del servidor y la composición de la UI, mientras que un headless CMS almacena y entrega contenido estructurado a través de una API o SDK. React Router documenta explícitamente ServerRouter, Scripts y la guía de seguridad para aplicaciones SSR, por eso encaja tan bien con este patrón.
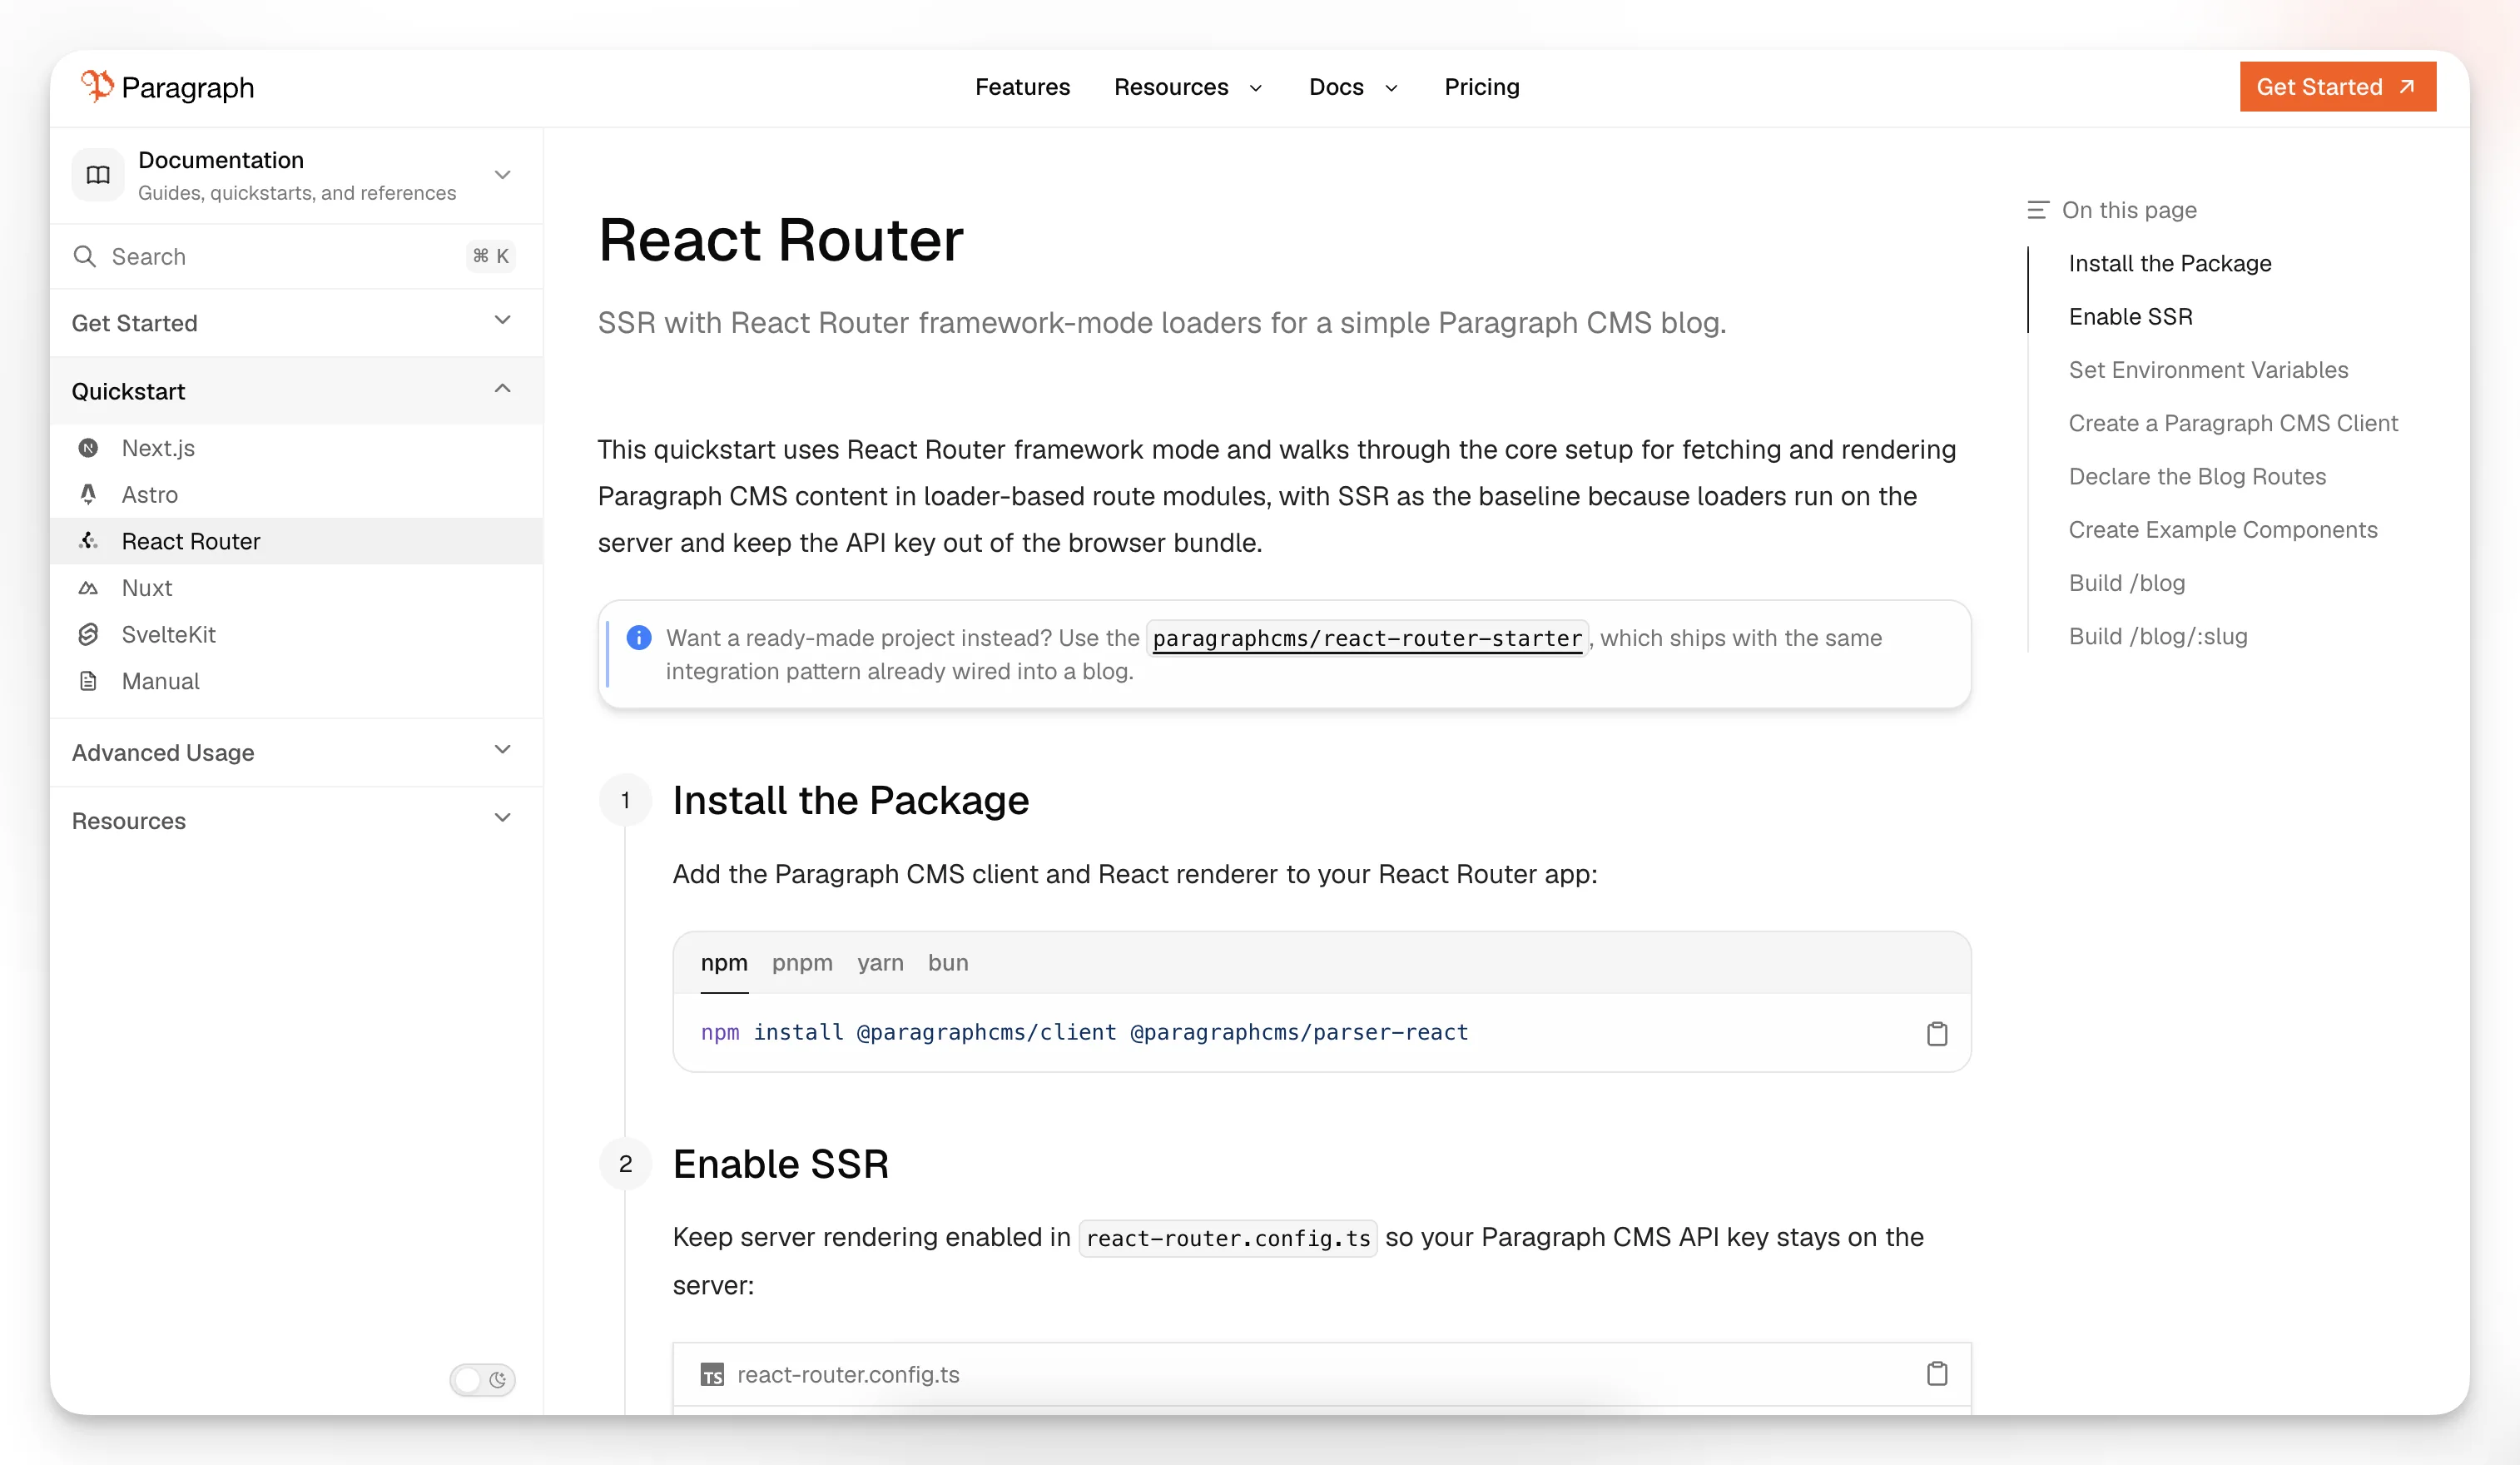
Este artículo explica ese patrón de una manera clara y agnóstica respecto al CMS. Para concretar los conceptos, usa Paragraph CMS como ejemplo porque el proveedor documenta públicamente la compatibilidad con React Router, proyectos de inicio y ejemplos más avanzados en su sitio oficial y changelog.
TL;DR: En una configuración de React Router headless CMS, React Router se encarga de la capa de aplicación y el CMS se encarga de la capa de contenido. Lo importante es la arquitectura, no la marca del CMS.
Qué significa “React Router headless CMS”
Un headless CMS gestiona el contenido sin controlar la capa de presentación de tu frontend. Tu aplicación de React Router se convierte en el sistema que decide:
qué URLs existen
qué datos carga cada ruta
cómo se renderiza el contenido
cómo funcionan los layouts, la navegación y el comportamiento de la UI
En la práctica, eso normalmente significa:
el CMS almacena páginas, entradas, slugs, metadatos y contenido enriquecido
React Router define el árbol de rutas
los loaders obtienen contenido en el servidor
los módulos de ruta devuelven datos a los componentes
los componentes de React renderizan el contenido estructurado en la UI final
Esa división de responsabilidades es la idea central detrás de la expresión React Router headless CMS.
Por qué React Router encaja tan bien en proyectos con headless CMS
React Router encaja muy bien para la entrega de contenido con headless CMS porque admite aplicaciones renderizadas en servidor en Framework Mode, incluida una entrada dedicada de ServerRouter y un manejo integrado de scripts del documento mediante Scripts. Su documentación de seguridad también cubre el manejo de nonce de CSP para aplicaciones renderizadas en servidor.
Para las aplicaciones orientadas al contenido, eso importa porque los equipos normalmente necesitan:
resolución de páginas basada en URL
carga de datos en el servidor
entrega de HTML optimizada para SEO
manejo seguro de credenciales de API
control de obtención de datos a nivel de ruta
libertad total sobre la capa de componentes
Esas necesidades encajan de forma natural con la arquitectura basada en loaders de React Router. Si estás creando un blog, un sitio de documentación, un sitio de marketing, una base de conocimiento o una plataforma editorial, el framework ya te da la mayoría de las primitivas que necesitas. También puedes revisar la guía oficial de estrategias de renderizado y la referencia de react-router.config.ts para ver en qué se diferencian los modos SSR y SPA.
La arquitectura: primero el framework, después el CMS
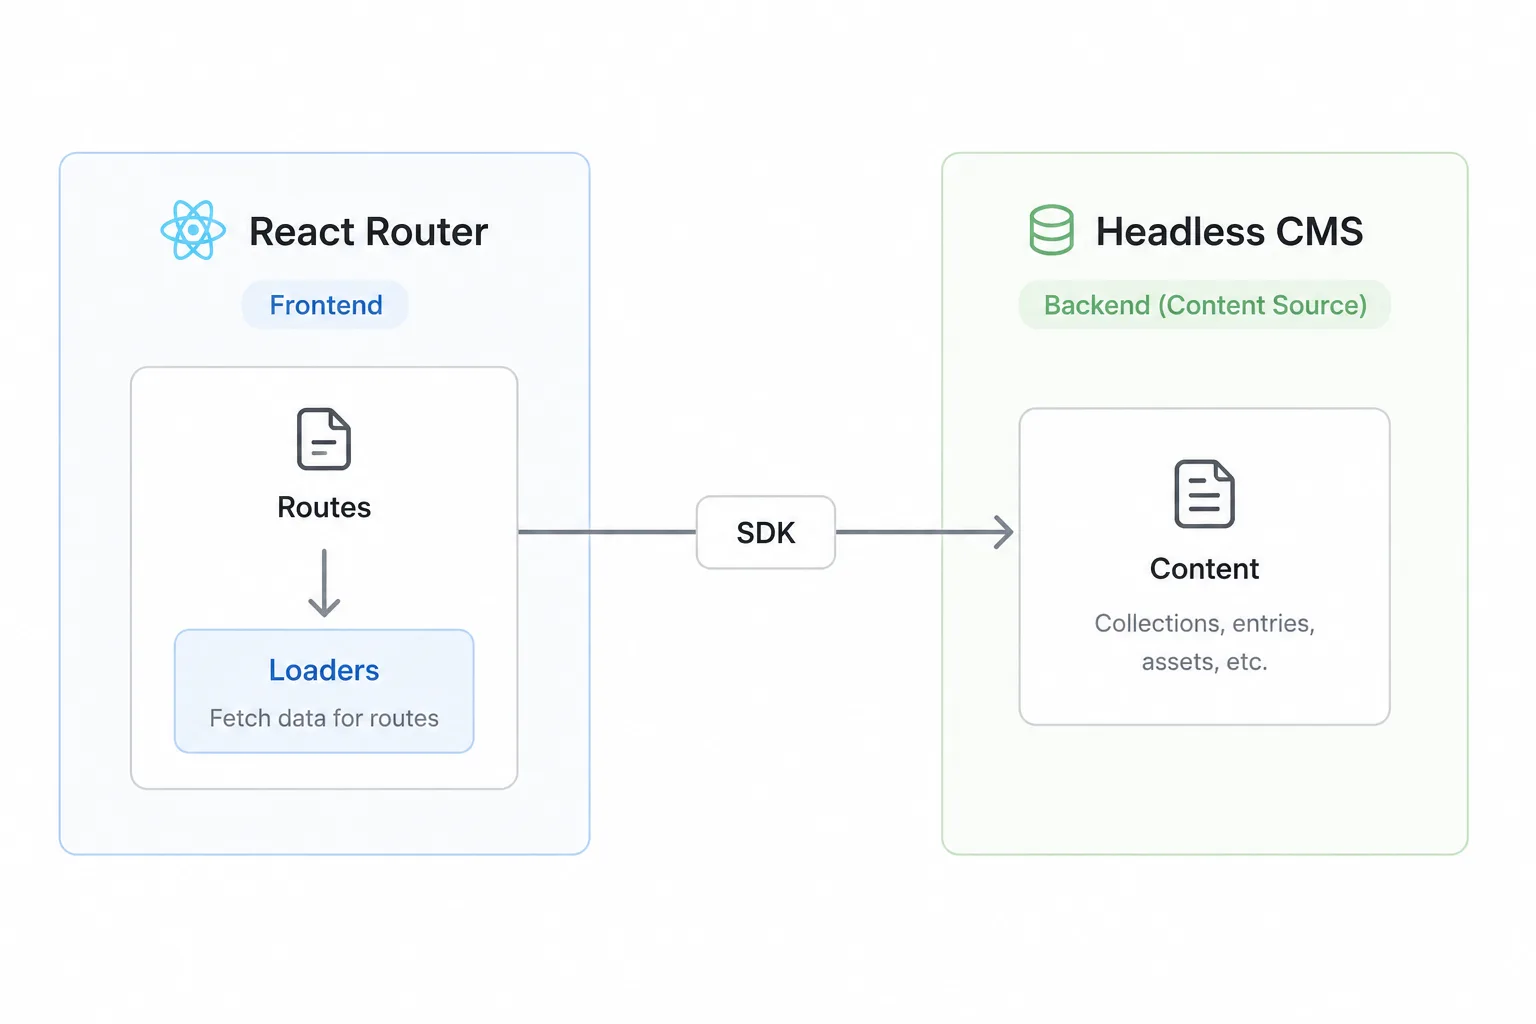
La forma más clara de pensar en esta configuración es:
React Router es el framework de la aplicación.
El headless CMS es el backend de contenido.
Un cliente de API o SDK conecta ambos.
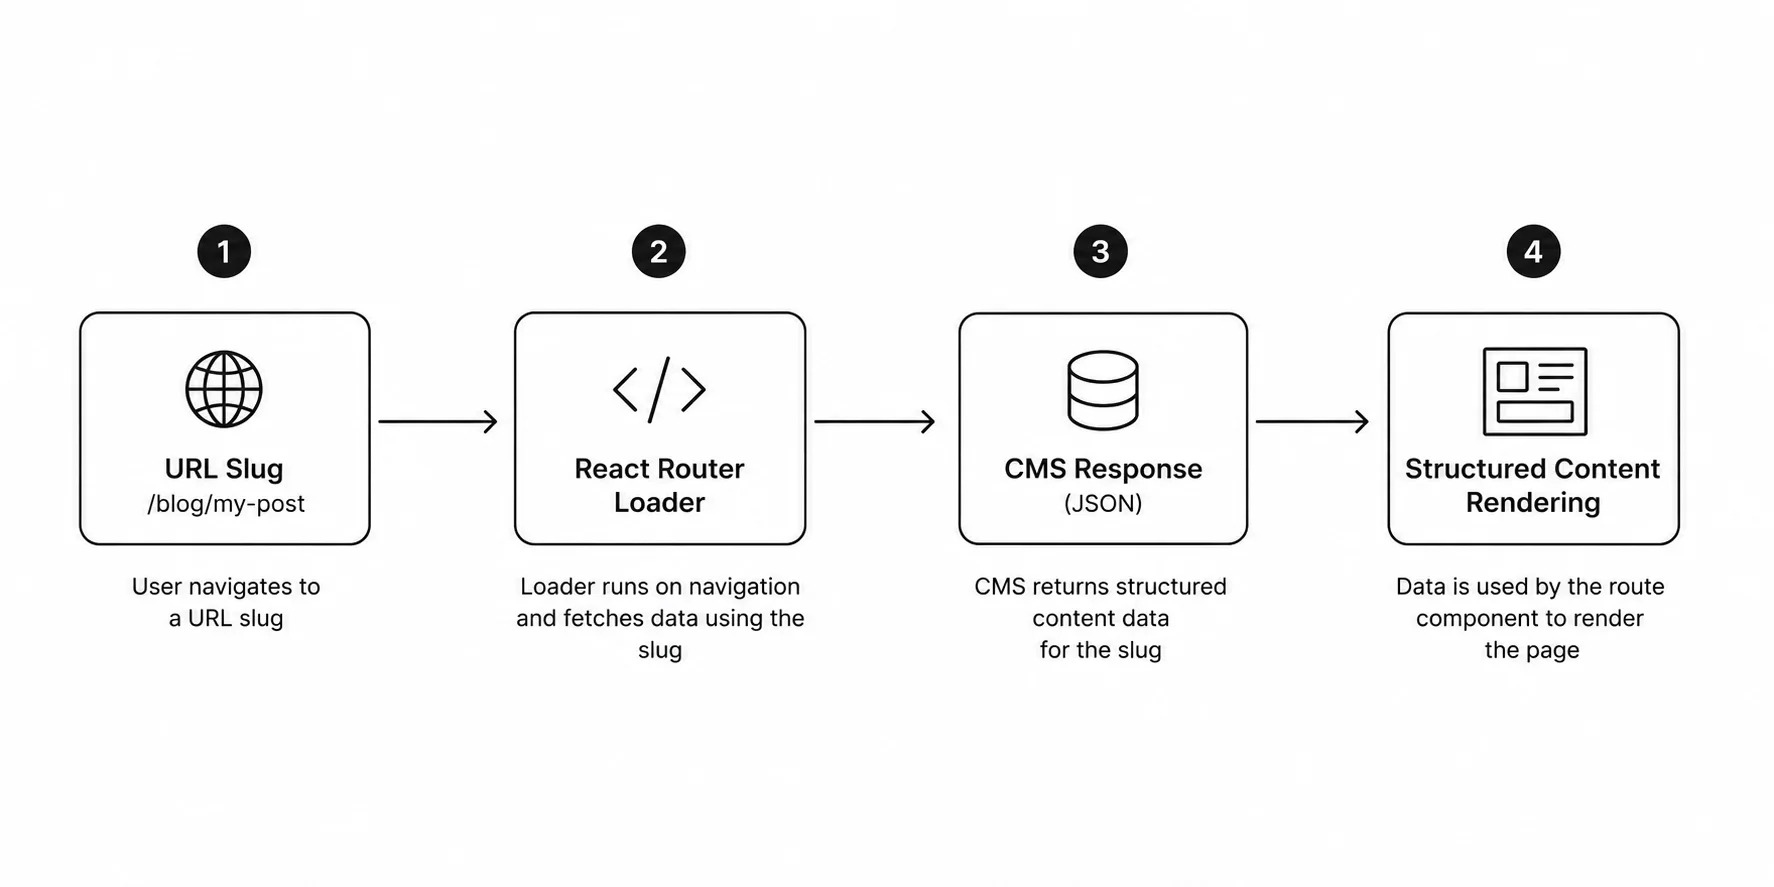
Los loaders de ruta obtienen los datos para una URL.
Los componentes de React deciden cómo se presenta el contenido.
Este enfoque importa porque mantiene clara la arquitectura del frontend. Un CMS se puede sustituir con más facilidad que tu modelo de rutas, tu modelo de renderizado y la UX de la aplicación. La integración específica del proveedor importa, pero debería ir después del patrón arquitectónico.
Cómo es una pila típica de React Router headless CMS
La mayoría de las implementaciones terminan con las mismas piezas básicas:
una aplicación de React Router ejecutándose con SSR
variables de entorno para las credenciales del CMS
un cliente de API compartido
una o más rutas de listado
una o más rutas dinámicas por slug
un renderizador para contenido estructurado
helpers opcionales de SEO para sitemap, robots, feeds y metadatos
Esa estructura va más allá de cualquier CMS en particular. Es simplemente el modelo normal de entrega para contenido headless en una aplicación de React basada en rutas.
Por qué SSR importa en este patrón
El renderizado del lado del servidor suele formar parte de la arquitectura, no solo ser un ajuste de rendimiento.
Con SSR:
los loaders pueden obtener datos del CMS en el servidor
las claves de API se mantienen fuera del bundle del navegador
las páginas pueden resolver contenido antes de enviar el HTML
el contenido basado en slug es más fácil de servir para SEO y vistas previas
el contenido estructurado puede renderizarse con los datos ya disponibles
La documentación de React Router deja explícito ese modelo centrado en el servidor. ServerRouter es el punto de entrada del servidor para Framework Mode, y la guía de seguridad explica cómo funciona el manejo de nonce para scripts inline cuando usas CSP.
Una configuración mínima suele verse así:
import type { Config } from "@react-router/dev/config";export default { ssr: true,} satisfies Config;Si no quieres renderizado en servidor para un proyecto concreto, React Router también documenta un modo SPA conssr: false. Eso puede funcionar para algunas aplicaciones de contenido, pero cambia cómo obtienes y proteges los datos, por eso SSR sigue siendo la opción más habitual para la entrega con headless CMS.
Cliente compartido: una sola puerta de acceso al contenido
Una buena integración mantiene el acceso al CMS en un solo lugar en vez de repetir la configuración de la API dentro de los archivos de rutas.
Por ejemplo:
import { Client } from "@paragraphcms/client";const apiKey = process.env.PARAGRAPH_API_KEY;if (!apiKey) { throw new Error("PARAGRAPH_API_KEY environment variable is not set");}export const client = new Client({ apiKey });Este patrón es útil independientemente del CMS que elijas. La lección importante es arquitectónica:
centralizar la configuración de la API
mantener los secretos en el servidor
hacer que los loaders dependan de un límite de integración compartido
evitar duplicar la lógica de acceso al contenido
Paragraph CMS se presenta públicamente como un headless CMS API-first con SDK oficiales y quickstarts de frameworks en su sitio web, por eso funciona como un ejemplo concreto aquí.
La estructura de rutas con la que empiezan la mayoría de los equipos
Un sitio de contenido simple suele empezar con solo dos rutas:
una ruta de listado como
/bloguna ruta dinámica de detalle como
/blog/:slug
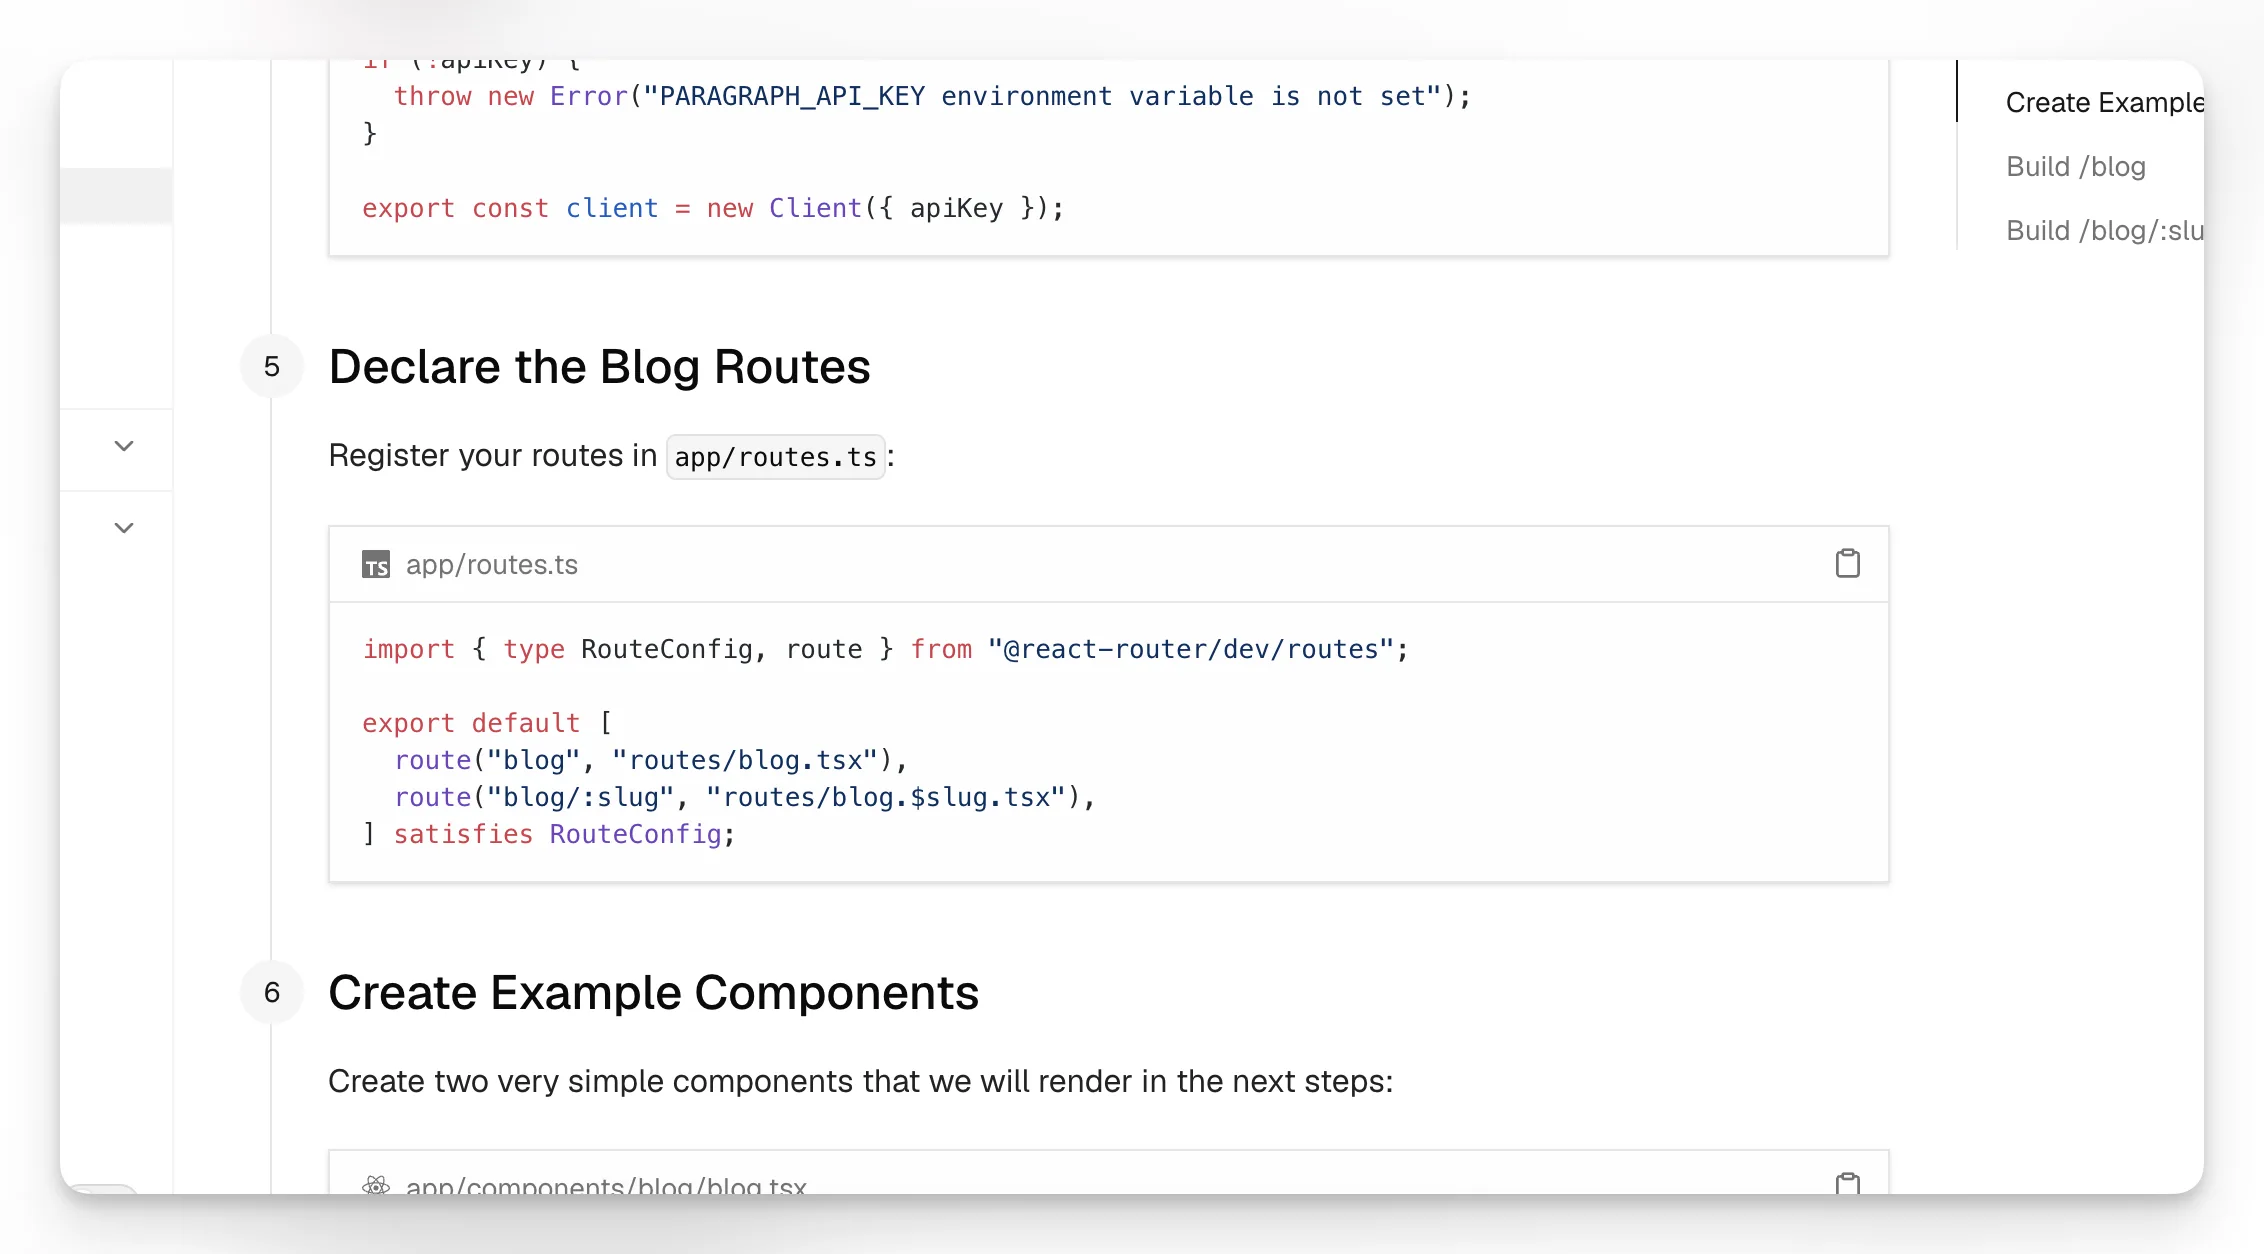
Ejemplo de configuración de rutas:
import { type RouteConfig, route } from "@react-router/dev/routes";export default [ route("blog", "routes/blog.tsx"), route("blog/:slug", "routes/blog.$slug.tsx"),] satisfies RouteConfig;Este es el patrón estándar basado en slugs para sitios de contenido. React Router controla la forma de la URL, y el loader asigna esa URL a un registro del CMS.
El changelog oficial de Paragraph CMS dice que su starter de React Router se lanzó el 5 de junio de 2026 con rutas funcionales /blog y /blog/[slug], y que su ejemplo avanzado de React Router se lanzó el 8 de junio de 2026 con enrutamiento con reconocimiento de locale y recursos generados como sitemap y RSS.
Cómo funciona la ruta de listado
La ruta de listado normalmente obtiene resúmenes de contenido y deja la presentación a la capa de componentes.
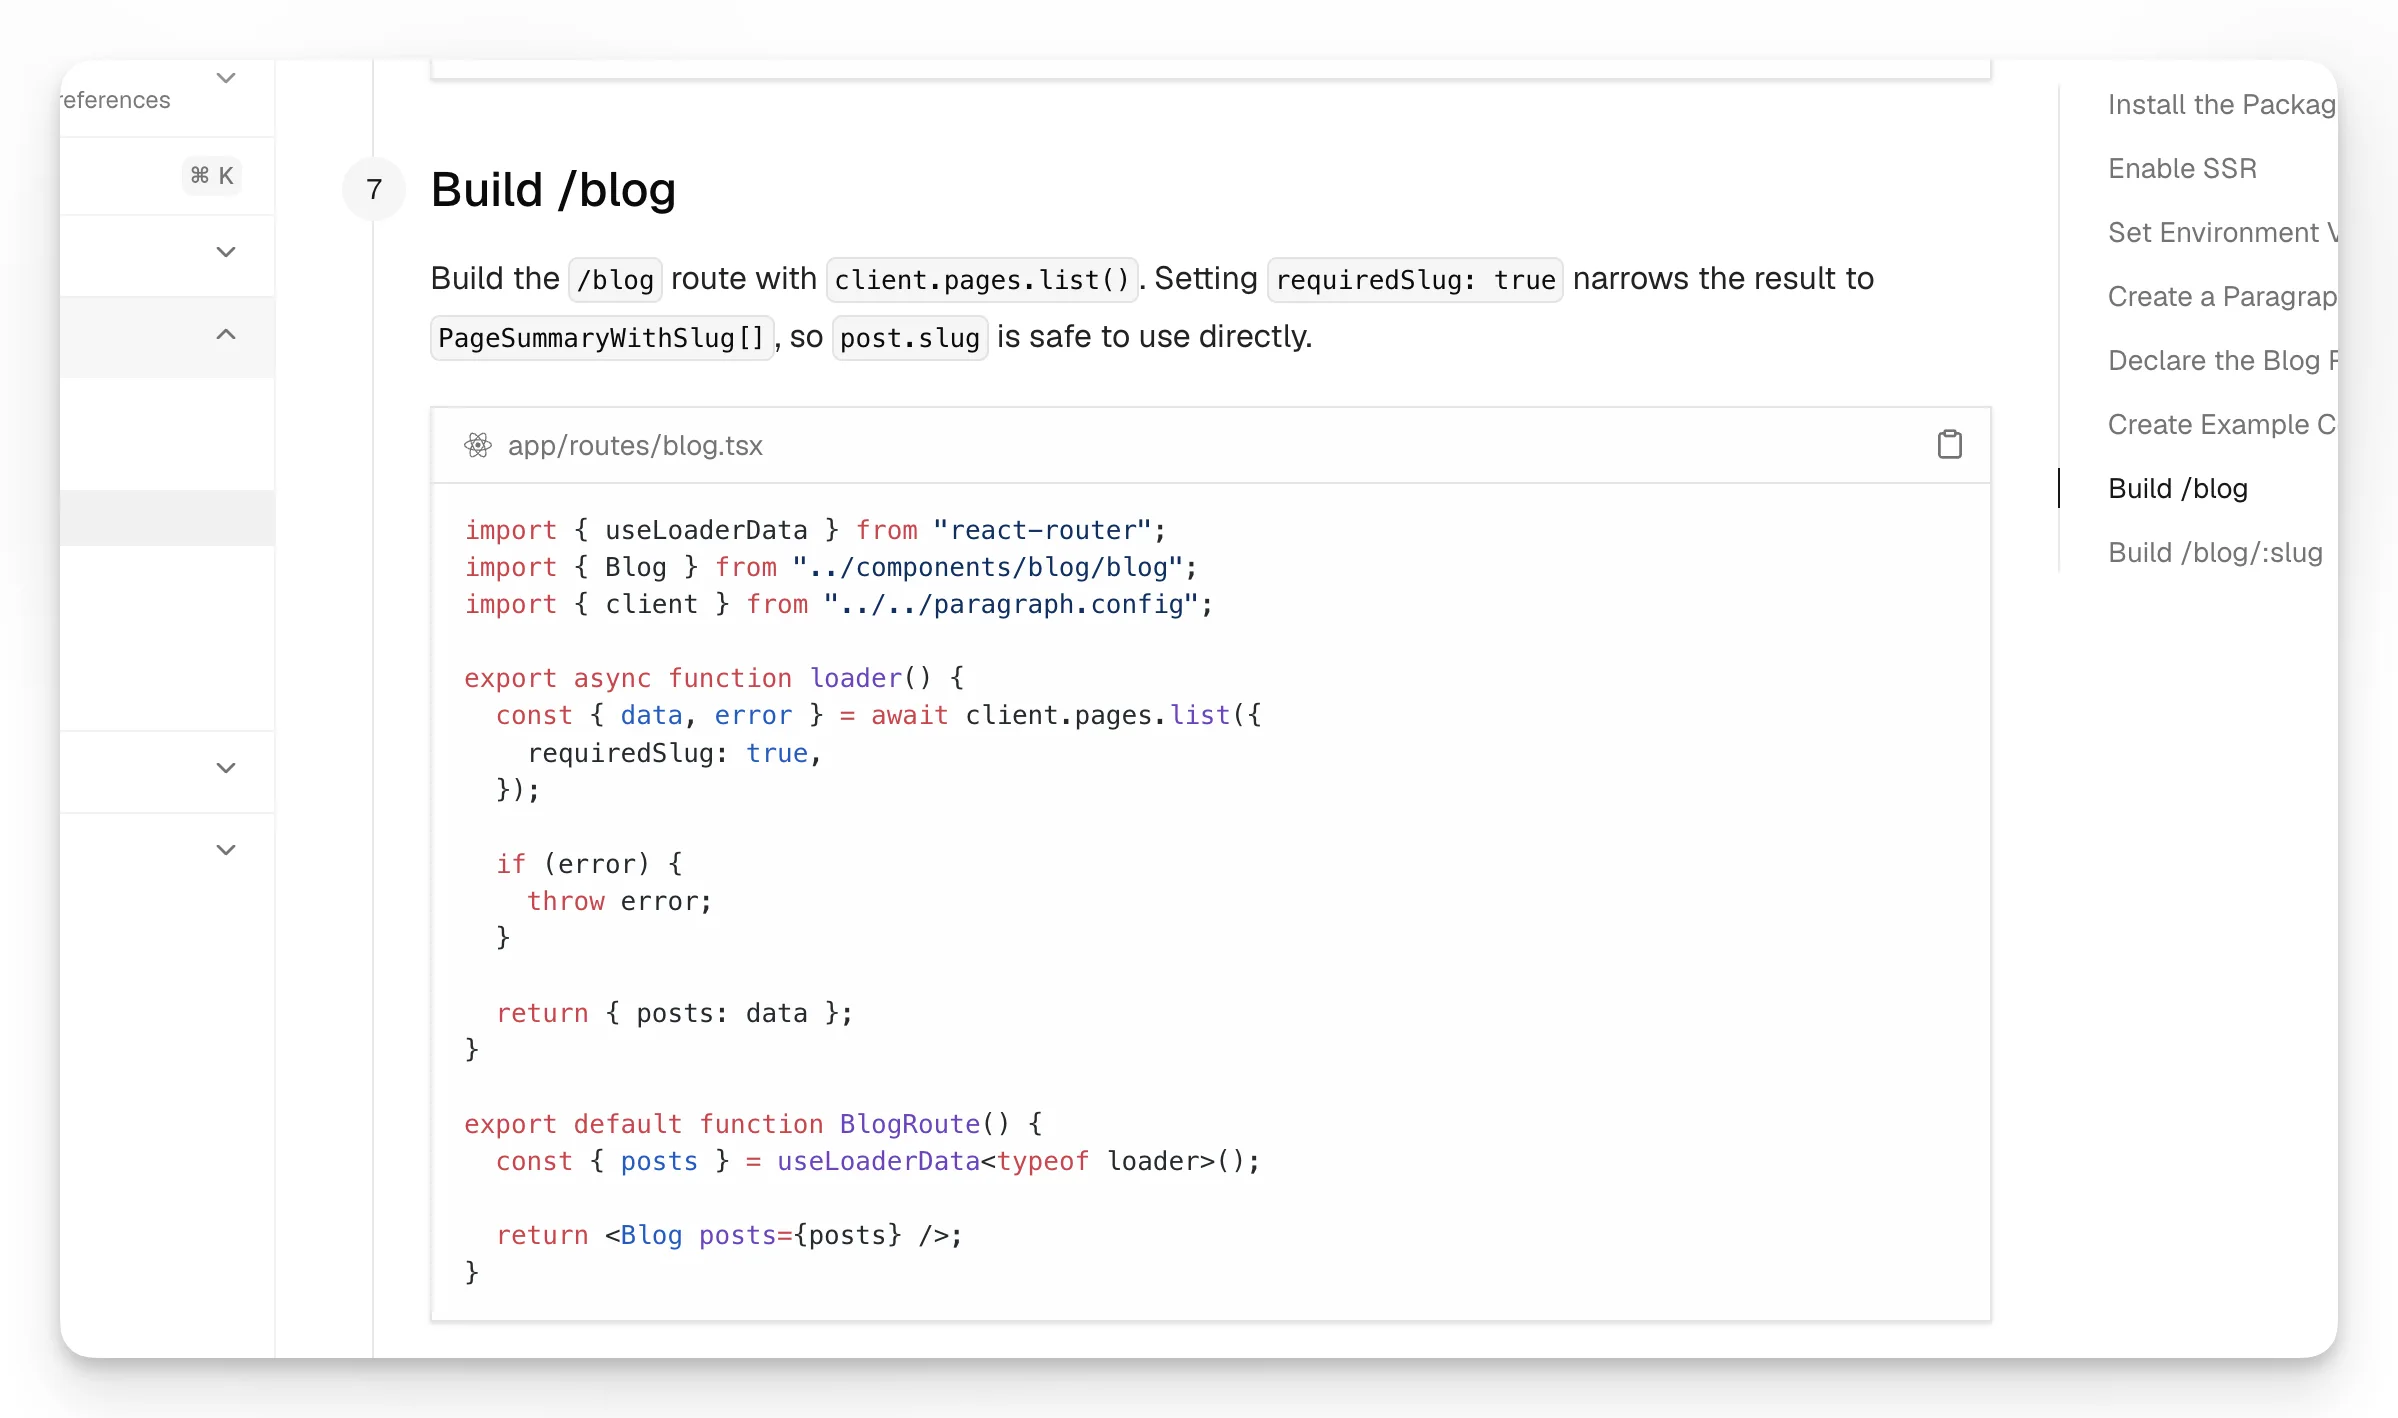
Ejemplo:
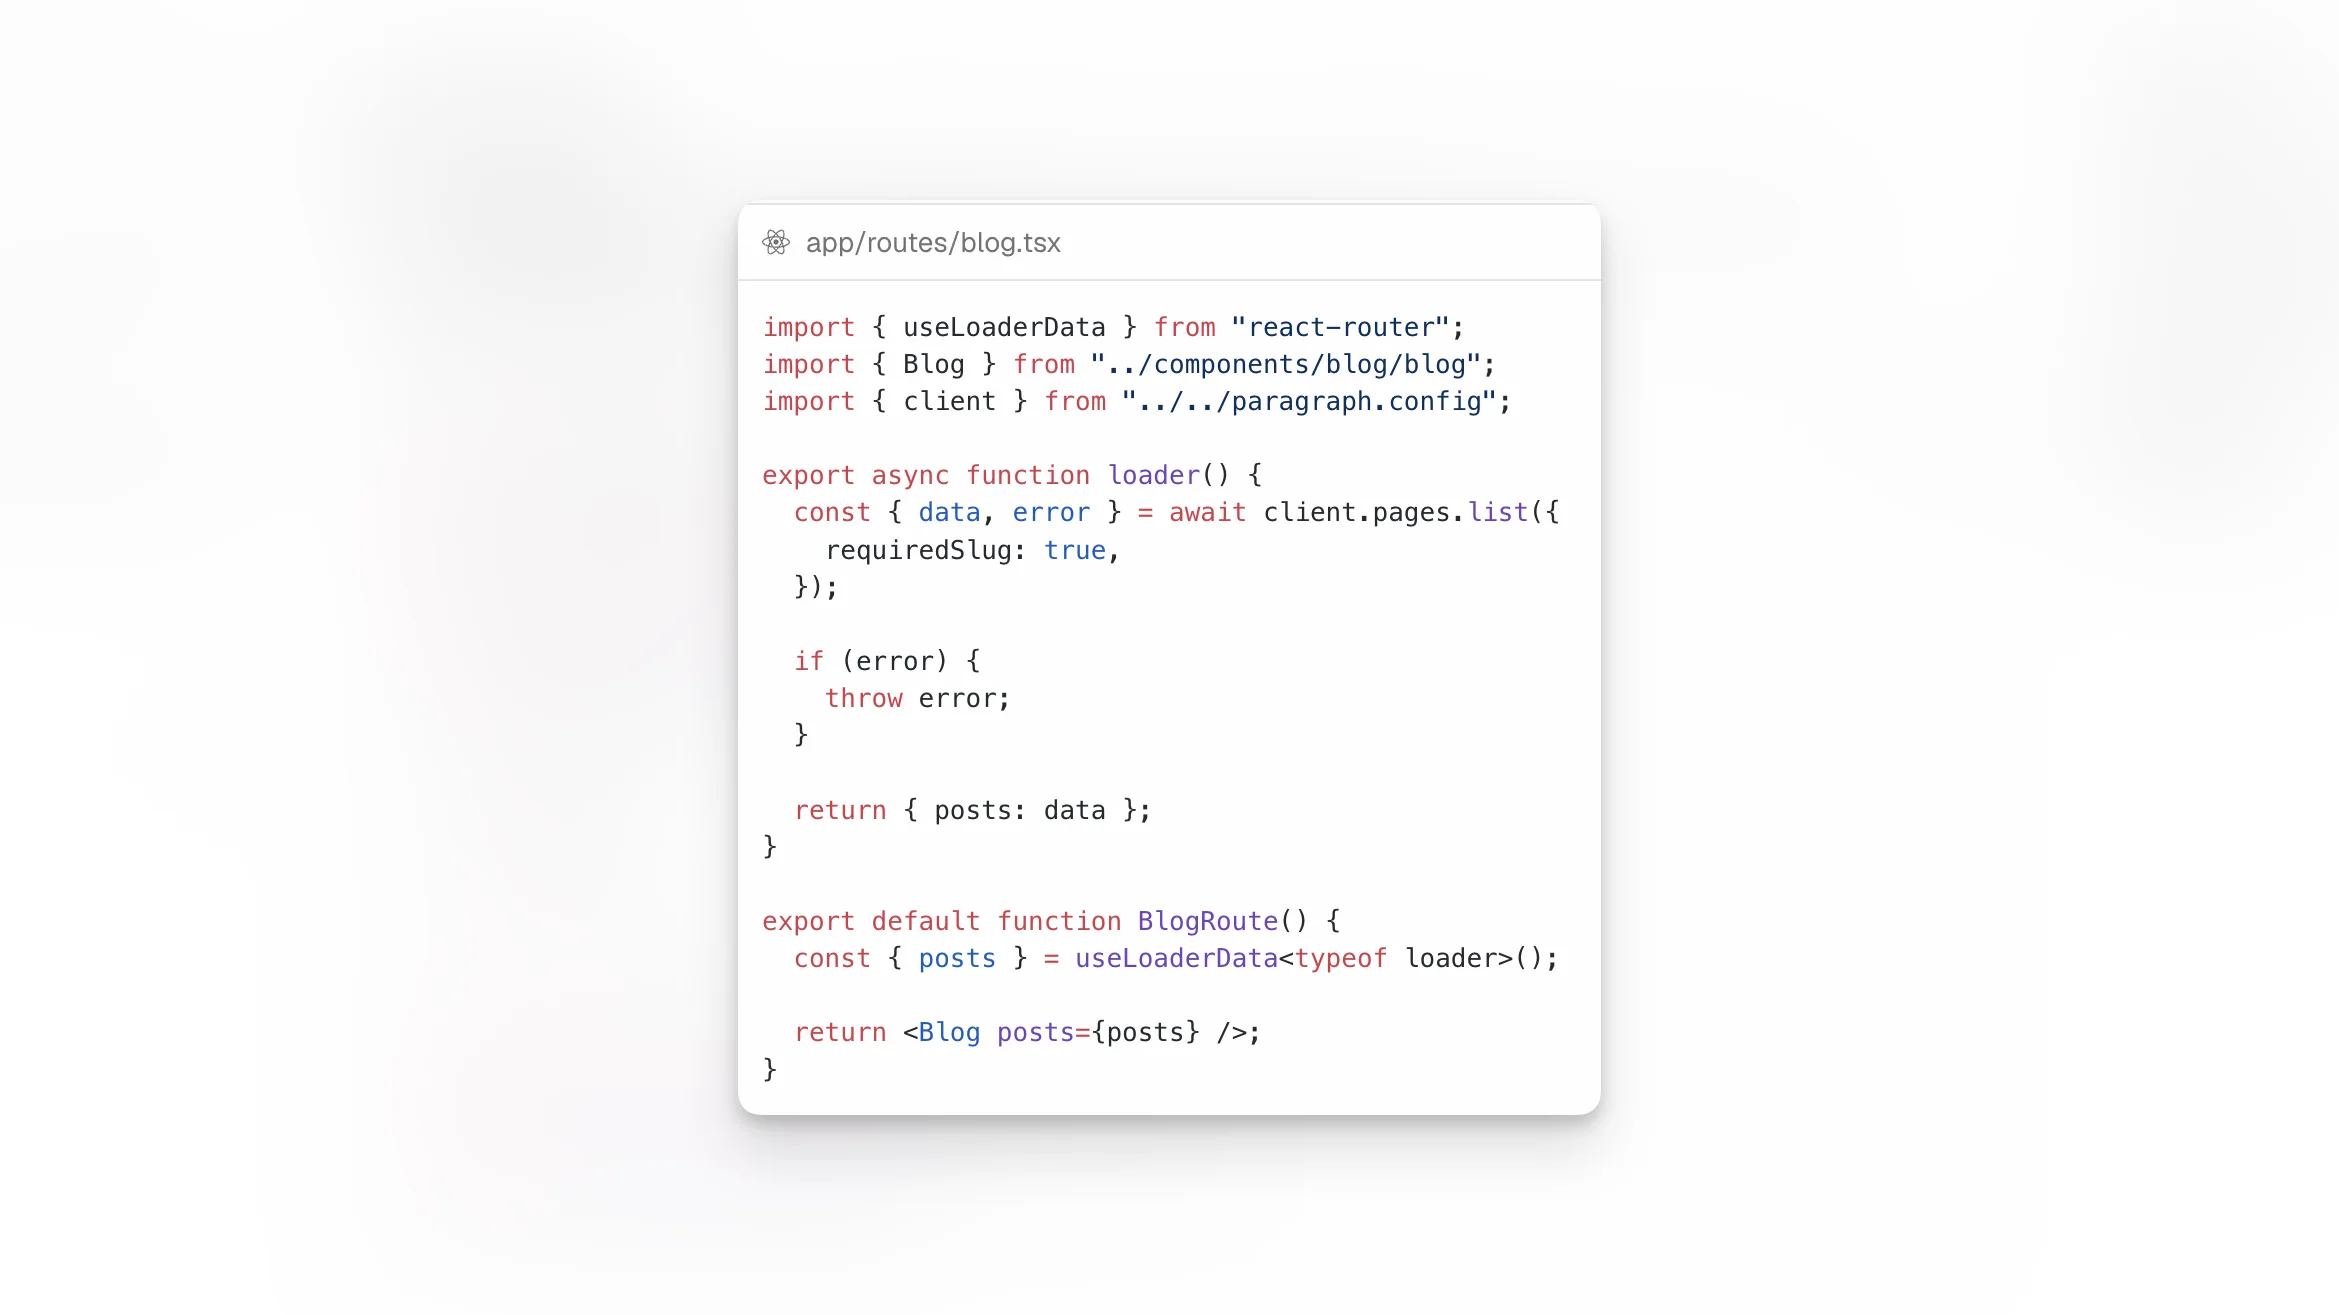
import { useLoaderData } from "react-router";import { Blog } from "../components/blog/blog";import { client } from "../../paragraph.config";export async function loader() { const { data, error } = await client.pages.list({ requiredSlug: true, }); if (error) { throw error; } return { posts: data };}export default function BlogRoute() { const { posts } = useLoaderData<typeof loader>(); return <Blog posts={posts} />;}Esa separación de responsabilidades es el punto principal:
el loader obtiene el contenido
la ruta devuelve datos específicos de la ruta
el componente de UI lo renderiza
El changelog de Paragraph CMS indica que el 2 de junio de 2026, client.pages.list() se simplificó para respuestas no paginadas, de modo que los desarrolladores pueden leer los resultados directamente desde data.
Cómo funciona la ruta por slug
La ruta de detalle es el flujo clásico de un headless CMS: leer el slug de la URL, obtener el registro correspondiente y renderizarlo.
Ejemplo:
import { useLoaderData } from "react-router";import type { Route } from "./+types/blog.$slug";import { Post } from "../components/blog/post";import { client } from "../../paragraph.config";export async function loader({ params }: Route.LoaderArgs) { const { data, error } = await client.page.getBySlug(params.slug!); if (error) { throw error; } return { data };}export default function BlogPostRoute() { const { data } = useLoaderData<typeof loader>(); return <Post page={data} />;}Este patrón se generaliza bien para:
publicaciones de blog
landing pages
páginas de documentación
entradas de changelog
artículos de base de conocimiento
casos de estudio
contenido localizado
El proveedor puede cambiar, pero el patrón de ruta normalmente no.
React Router también documenta la seguridad de tipos en módulos de ruta, algo útil cuando tus rutas por slug se vuelven más complejas y necesitan tipado predecible para loaders y params.
Renderizado de contenido estructurado en React
Un headless CMS real normalmente devuelve contenido estructurado, no solo cadenas de texto sin formato. Ese contenido debería renderizarse mediante un renderizador confiable que entienda el modelo de datos del CMS.
Ejemplo:
import type { PageWithSlug } from "@paragraphcms/client";import { ParagraphContent } from "@paragraphcms/parser-react";export function Post({ page }: { page: PageWithSlug }) { return ( <main> <h1>{page.title}</h1> <ParagraphContent content={page.content} /> </main> );}La lección transferible es:
almacenar contenido estructurado en el CMS
obtener contenido estructurado en los loaders
renderizarlo mediante componentes de React o un renderizador oficial
evitar convertirlo todo en HTML inseguro cuando no lo necesitas
La capa de UI se mantiene simple
Una de las mejores cosas de una integración limpia con headless CMS es que la UI a menudo se vuelve muy aburrida en el buen sentido.
Ejemplo de componente de lista:
import type { PageSummaryWithSlug } from "@paragraphcms/client";import { Link } from "react-router";export function Blog({ posts }: { posts: PageSummaryWithSlug[] }) { return ( <main> <h1>Blog</h1> <ul> {posts.map((post) => ( <li key={post.id}> <Link to={`/blog/${post.slug}`}>{post.title}</Link> </li> ))} </ul> </main> );}Eso muestra claramente la división:
el CMS proporciona datos de contenido estructurado
React Router proporciona navegación y límites de datos de ruta
tu aplicación decide el diseño, layout, estados y UX
Qué hace que esto sea un flujo de trabajo real con headless CMS
Un proyecto no es realmente “headless” solo porque llame a una API una vez. Se convierte en un flujo de trabajo con headless CMS cuando la separación es consistente:
los editores trabajan en el CMS
los desarrolladores son dueños de la base de código del frontend
la aplicación define las rutas
el contenido se entrega a través de una API o SDK
el renderizado se maneja en la aplicación React
los cambios editoriales y los cambios del frontend pueden avanzar de forma independiente
Paragraph CMS se presenta públicamente como un headless CMS con claves de API, SDK, contenido multilingüe, gestión de medios, SEO de páginas y compatibilidad con React Router en su sitio, lo que encaja bien con este modelo como ejemplo.
Lo que esta configuración no resuelve por sí sola
Una integración simple para blog es un buen punto de partida, pero no resuelve automáticamente todo.
Aún necesitas diseñar:
estrategia de URL multilingüe
flujos de vista previa y borradores
taxonomía y filtrado
invalidación de caché
indexación de búsqueda
estrategia de metadatos
control de acceso
gobernanza empresarial
El changelog de Paragraph CMS muestra cómo un starter puede ampliarse hacia una configuración más completa. El 8 de junio de 2026, el proveedor publicó ejemplos avanzados con enrutamiento de blog con reconocimiento de locale más generación de sitemap.xml, robots.txt, llms.txt y feeds RSS. El 25 de mayo de 2026, también anunció un paquete de SEO para generar este tipo de recursos.
Cómo evaluar cualquier headless CMS para React Router
Si estás comparando opciones de CMS para una aplicación de React Router, haz preguntas prácticas en lugar de preguntas sobre marcas.
Modelado de contenido
¿Puede representar claramente tus tipos de contenido?
¿Admite contenido estructurado, no solo rich text plano?
¿Son fáciles de gestionar los slugs, metadatos y relaciones?
Entrega
¿Proporciona una API limpia o un SDK oficial?
¿Puedes resolver contenido por slug de forma eficiente?
¿La forma de la respuesta es lo bastante predecible para los loaders de ruta?
Compatibilidad con React Router
¿Funciona bien con SSR?
¿Pueden mantenerse los secretos del lado del servidor?
¿Es simple la integración en loaders de ruta y módulos de ruta?
Necesidades de escalado
¿Admite localización?
¿Gestiona bien los medios?
¿Ayuda con metadatos SEO y recursos de indexación?
¿Puede crecer de un blog simple a un sistema de contenido más grande?
Esas son las preguntas correctas uses Paragraph CMS u otro headless CMS.
Consideraciones de seguridad
Cualquier integración con headless CMS debería tratar la seguridad como parte de la arquitectura.
Las prácticas recomendadas básicas incluyen:
mantener las claves de API en variables de entorno
obtener contenido protegido en el servidor cuando sea posible
evitar exponer credenciales privilegiadas al navegador
usar enfoques de renderizado confiables para contenido estructurado
configurar correctamente CSP si tu aplicación lo usa
La guía oficial de seguridad de React Router explica específicamente el manejo de nonce para scripts inline en aplicaciones basadas en CSP, y ServerRouter permite pasar un nonce para cumplir con CSP. Si quieres protección adicional contra el empaquetado accidental en cliente de código solo de servidor, React Router también documenta los módulos .server.
Implicaciones de SEO del patrón
Un headless CMS no crea SEO por sí solo. Lo que ayuda al SEO es la combinación de:
arquitectura de URL estable
HTML renderizado en servidor
buena gestión de metadatos
enlazado interno
modelado de contenido estructurado
recursos de rastreo generados cuando se necesiten
Esa es otra razón por la que React Router funciona bien aquí: el frontend controla las URLs, el renderizado y la estrategia de metadatos, mientras que el CMS controla el contenido fuente.
Un mejor enfoque para este tema
El mejor enfoque editorial es simple:
Este es un artículo sobre el patrón React Router headless CMS, usando un CMS como ejemplo de implementación.
Eso es mejor que convertir la página en un discurso de ventas, porque los desarrolladores que buscan este término normalmente quieren entender:
cómo funcionan los loaders
cómo encaja SSR
cómo las rutas basadas en slug obtienen contenido
cómo se renderiza el contenido estructurado
cómo separar la gestión de contenido de la lógica de la aplicación frontend
Conclusión práctica
Si quieres el resumen preciso más corto, es este:
React Router funciona bien con un headless CMS porque te da carga en servidor a nivel de ruta, compatibilidad con SSR, primitivas de seguridad para aplicaciones reales y control total sobre cómo se renderiza el contenido. Un CMS se convierte entonces en el backend de contenido detrás de esa capa de aplicación.
Ese es el núcleo del patrón.
¿Qué significa en la práctica “React Router headless CMS”?
Significa que React Router gestiona las rutas, los loaders, SSR y el renderizado de la UI, mientras que un headless CMS almacena y entrega contenido a través de una API o SDK.
¿Por qué React Router encaja bien con un headless CMS?
Porque te da carga de datos basada en rutas, compatibilidad con renderizado en servidor, control sobre la estructura de URL y un límite claro entre la obtención de contenido y el renderizado de la UI.
¿Necesito SSR para una configuración de React Router headless CMS?
No siempre, pero SSR suele ser la mejor opción porque mantiene las credenciales en el servidor, resuelve el contenido antes de enviar el HTML y admite de forma más natural los casos de uso de SEO con mucho contenido.
¿Cuál es el patrón de rutas habitual para contenido de CMS?
El punto de partida más común es una ruta de listado como /blog y una ruta de detalle como /blog/:slug. El loader lee el slug y obtiene la entrada correspondiente del CMS.
¿Puede este patrón funcionar con plataformas CMS distintas de Paragraph CMS?
Sí. La arquitectura es agnóstica respecto al proveedor. Cualquier CMS con una API o SDK útil, compatibilidad con slugs y entrega de contenido estructurado normalmente puede encajar en el mismo patrón de React Router.
¿Qué debería evaluar al elegir un CMS para React Router?
Céntrate en la calidad de la API, la compatibilidad con SSR, el soporte de contenido estructurado, la resolución por slug, la gestión de medios, la localización, el soporte de metadatos y qué tan limpiamente se ajusta el modelo de contenido a tu estructura de rutas.