Headless CMS React Router: jak to działa
Dowiedz się, jak React Router i headless CMS współpracują ze sobą, aby zapewnić przyjazne dla SEO SSR, loadery tras i uporządkowane dostarczanie treści.
 Grzegorz
Gdy ludzie szukają React Router headless CMS, zazwyczaj nie szukają jednego dostawcy. Chcą zrozumieć architekturę frontendu: React Router obsługuje trasy, loadery, renderowanie po stronie serwera i kompozycję UI, podczas gdy headless CMS przechowuje i dostarcza ustrukturyzowaną treść przez API lub SDK. React Router wprost dokumentuje ServerRouter, Scripts oraz wskazówki dotyczące bezpieczeństwa dla aplikacji SSR, dlatego dobrze pasuje do tego wzorca.
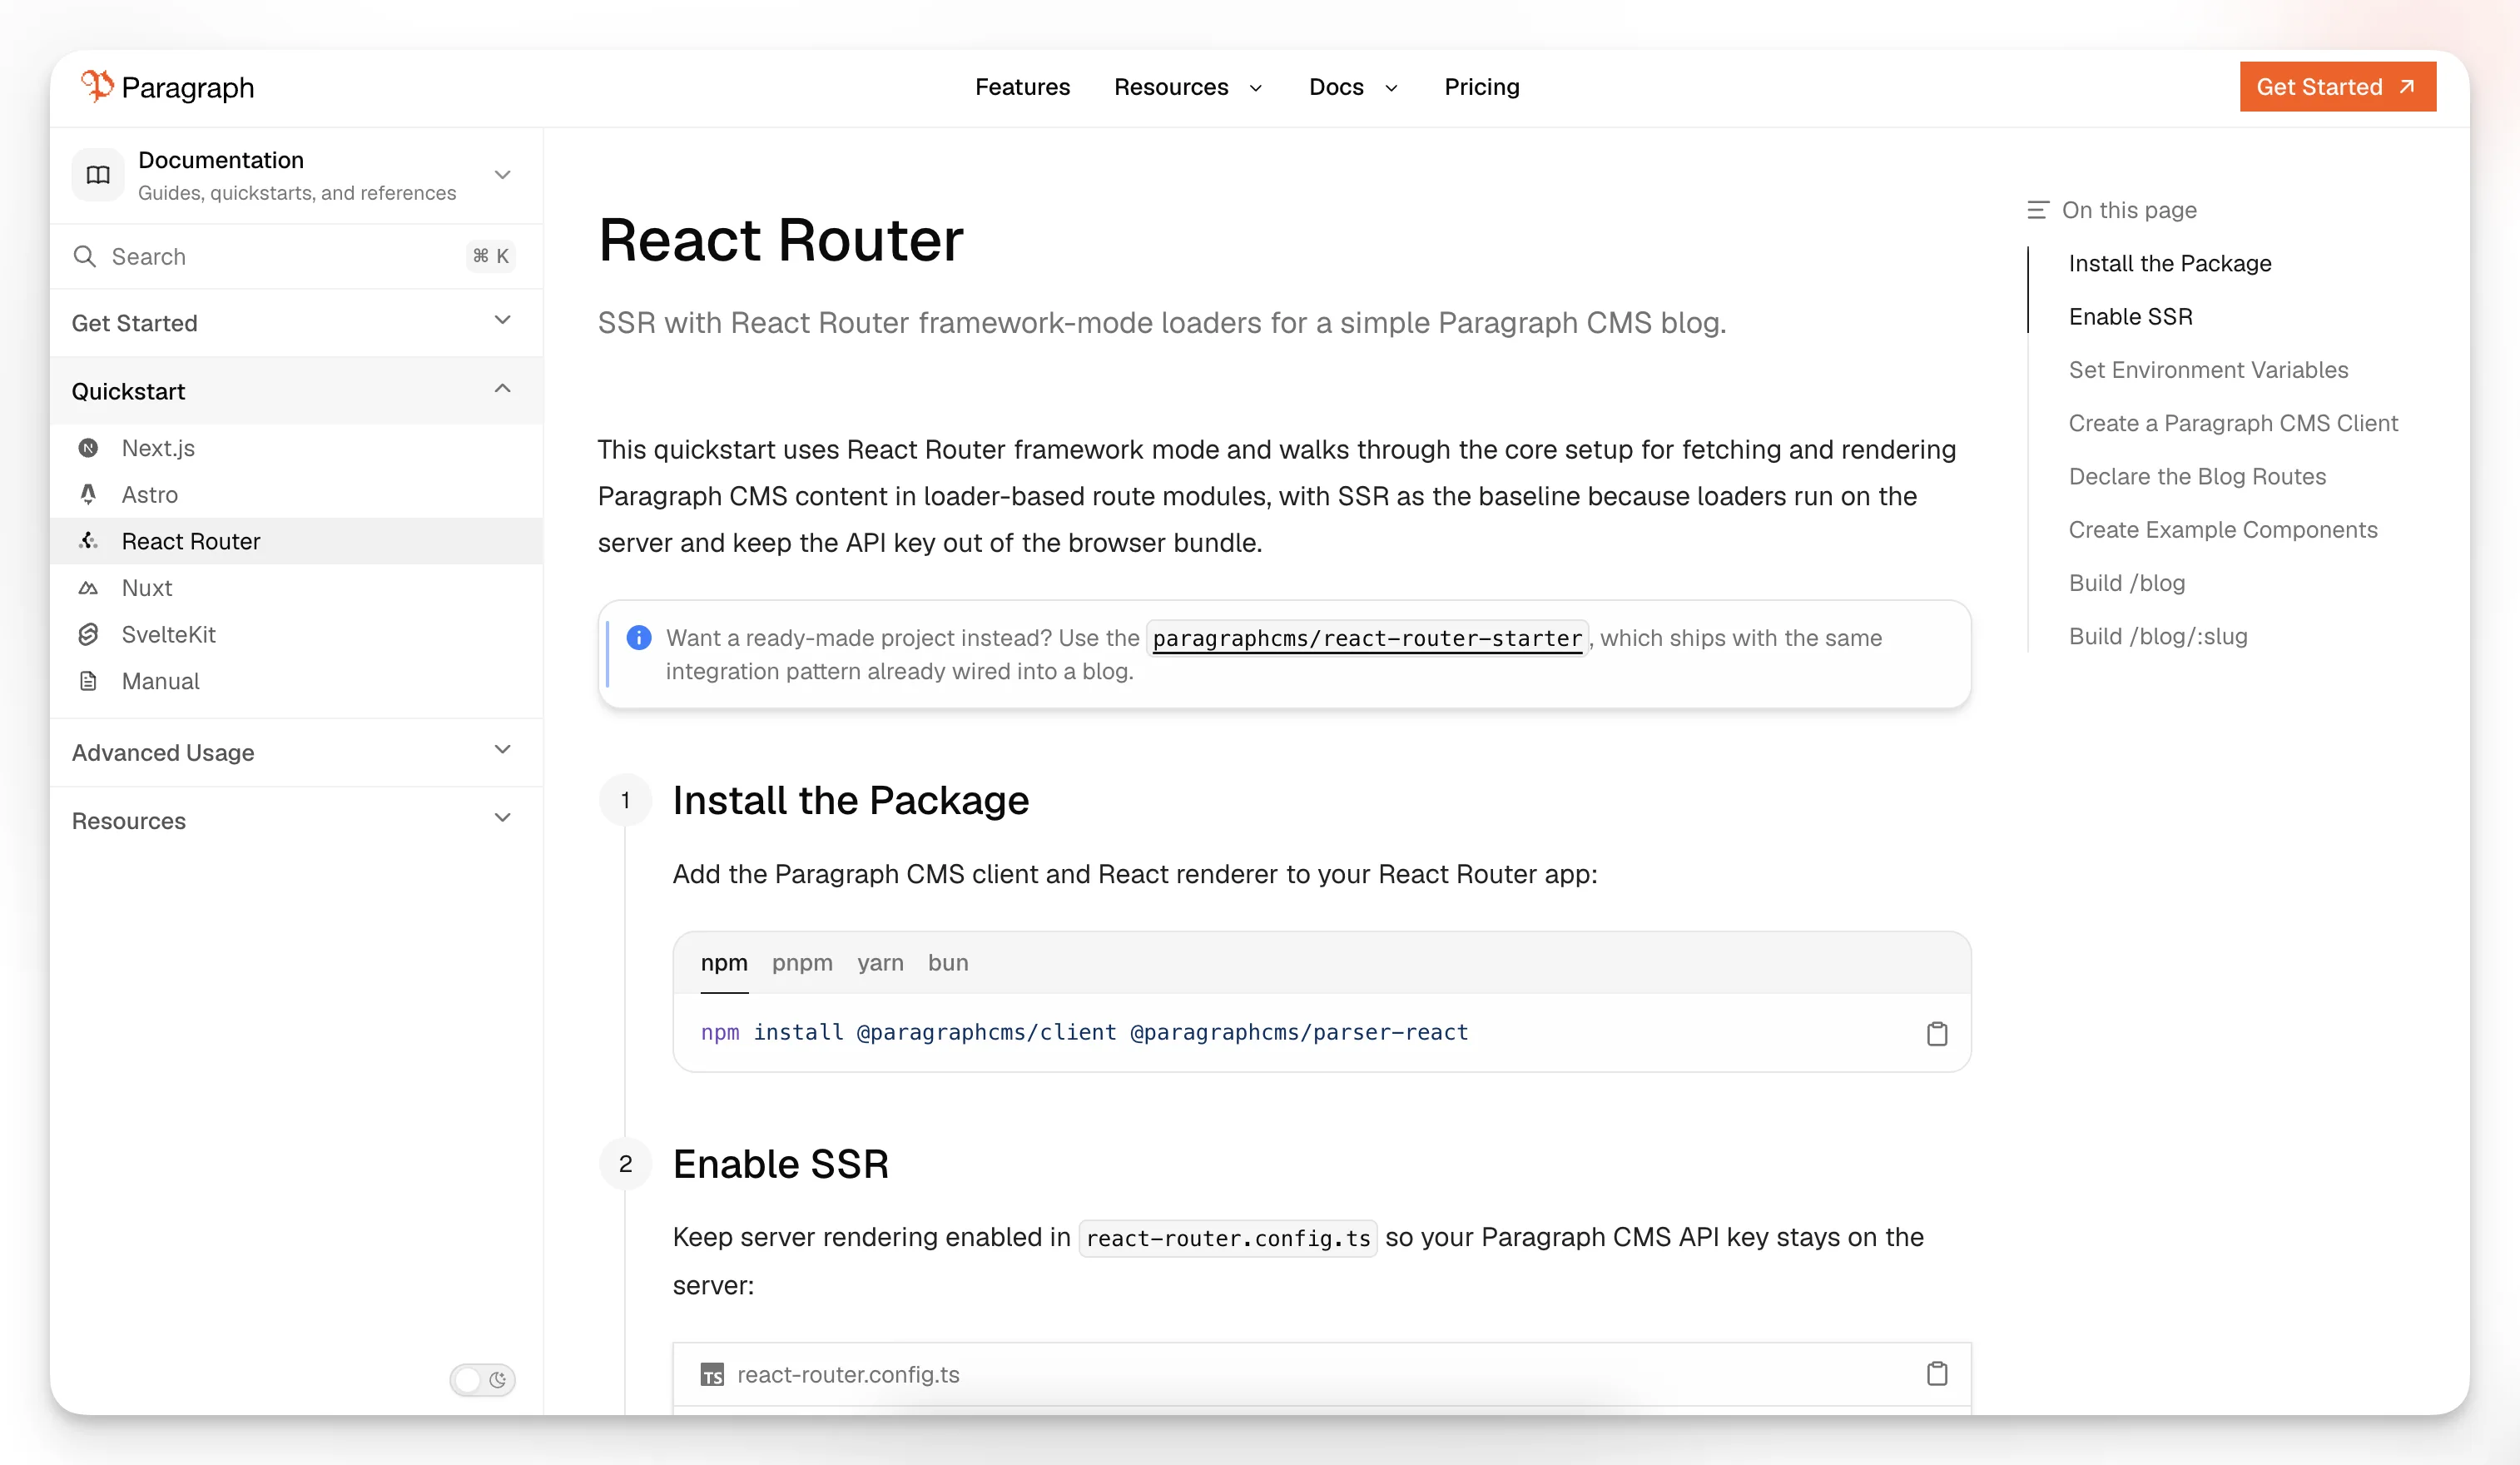
Ten artykuł wyjaśnia ten wzorzec w przejrzysty, niezależny od CMS-a sposób. Aby uczynić pojęcia bardziej konkretnymi, używa Paragraph CMS jako przykładu, ponieważ dostawca publicznie dokumentuje wsparcie dla React Router, projekty startowe i bardziej zaawansowane przykłady na swojej oficjalnej stronie i w changelogu.
TL;DR: W konfiguracji React Router headless CMS React Router odpowiada za warstwę aplikacji, a CMS za warstwę treści. Najważniejsza jest architektura, a nie marka CMS-a.
Co oznacza „React Router headless CMS”
Headless CMS zarządza treścią bez kontrolowania warstwy prezentacji frontendu. Twoja aplikacja React Router staje się systemem, który decyduje:
jakie adresy URL istnieją
jakie dane ładuje każda trasa
jak renderowana jest treść
jak działają układy, nawigacja i zachowanie UI
W praktyce zwykle oznacza to, że:
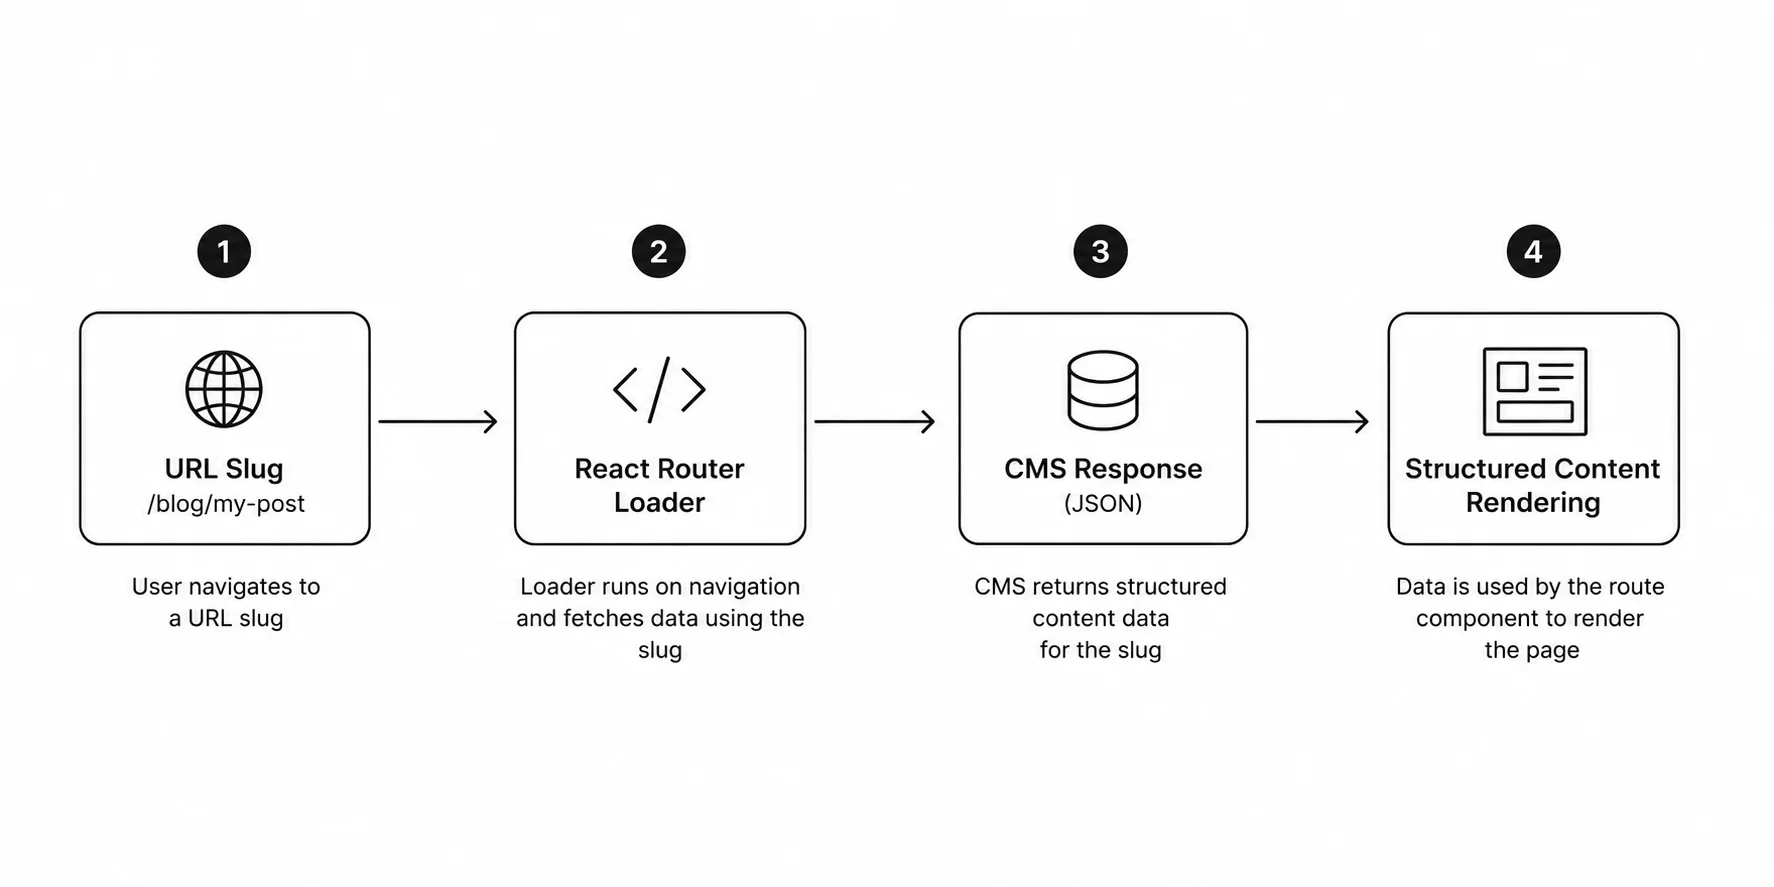
CMS przechowuje strony, wpisy, slugi, metadane i rozbudowaną treść
React Router definiuje drzewo tras
loadery pobierają treść na serwerze
moduły tras zwracają dane do komponentów
komponenty React renderują ustrukturyzowaną treść do finalnego UI
Ten podział odpowiedzialności jest kluczową ideą stojącą za wyrażeniem React Router headless CMS.
Dlaczego React Router dobrze nadaje się do projektów z headless CMS
React Router dobrze nadaje się do dostarczania treści z headless CMS, ponieważ obsługuje aplikacje renderowane po stronie serwera w Framework Mode, w tym dedykowany punkt wejścia ServerRouter oraz wbudowaną obsługę skryptów dokumentu przez Scripts. Jego dokumentacja bezpieczeństwa obejmuje również obsługę nonce CSP dla aplikacji renderowanych po stronie serwera.
W przypadku aplikacji opartych na treści ma to znaczenie, ponieważ zespoły zwykle potrzebują:
rozwiązywania stron na podstawie URL-i
ładowania danych po stronie serwera
dostarczania HTML przyjaznego SEO
bezpiecznej obsługi poświadczeń API
kontroli pobierania na poziomie trasy
pełnej swobody w warstwie komponentów
Te potrzeby naturalnie pasują do architektury React Router opartej na loaderach. Jeśli tworzysz blog, serwis dokumentacyjny, stronę marketingową, bazę wiedzy lub platformę redakcyjną, framework daje już większość potrzebnych prymitywów. Możesz też przejrzeć oficjalny przewodnik po strategiach renderowania oraz referencję react-router.config.ts, aby zobaczyć, czym różnią się tryby SSR i SPA.
Architektura: najpierw framework, potem CMS
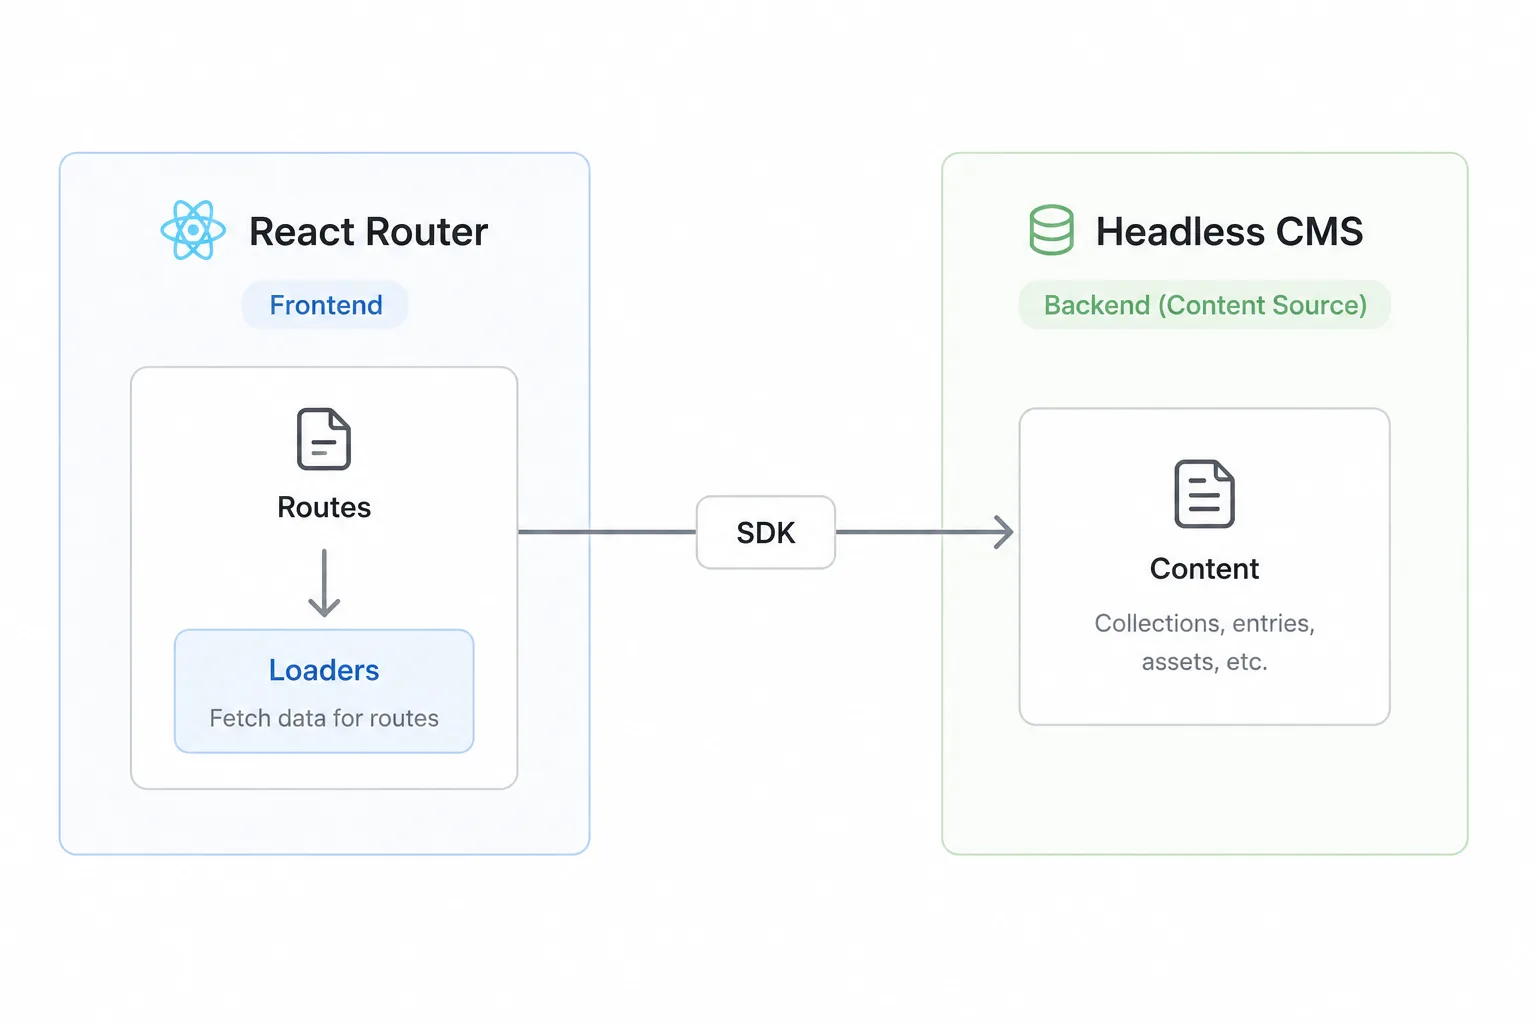
Najprościej myśleć o tym układzie tak:
React Router jest frameworkiem aplikacji.
Headless CMS jest backendem treści.
Klient API lub SDK łączy jedno z drugim.
Loadery tras pobierają dane dla danego URL-a.
Komponenty React decydują, jak prezentowana jest treść.
Takie ujęcie ma znaczenie, ponieważ utrzymuje przejrzystą architekturę frontendu. CMS można zwykle wymienić łatwiej niż model routingu, model renderowania i UX aplikacji. Integracja specyficzna dla dostawcy ma znaczenie, ale powinna być wtórna wobec wzorca architektonicznego.
Jak wygląda typowy stos React Router headless CMS
Większość wdrożeń kończy się tym samym zestawem podstawowych elementów:
aplikacja React Router działająca z SSR
zmienne środowiskowe dla poświadczeń CMS
współdzielony klient API
jedna lub więcej tras listujących
jedna lub więcej dynamicznych tras opartych na slugu
renderer dla ustrukturyzowanej treści
opcjonalne pomocniki SEO dla sitemap, robots, feedów i metadanych
Ta struktura wykracza poza jeden konkretny CMS. To po prostu standardowy model dostarczania treści headless w aplikacji React opartej na trasach.
Dlaczego SSR ma znaczenie w tym wzorcu
Renderowanie po stronie serwera jest zwykle częścią architektury, a nie tylko poprawką wydajności.
Przy SSR:
loadery mogą pobierać dane CMS na serwerze
klucze API nie trafiają do bundla przeglądarki
strony mogą rozwiązywać treść przed wysłaniem HTML
treść oparta na slugach jest łatwiejsza do serwowania pod SEO i podglądy
ustrukturyzowana treść może być renderowana z już dostępnymi danymi
Dokumentacja React Router jasno wskazuje ten model server-first. ServerRouter jest punktem wejścia serwera dla Framework Mode, a przewodnik bezpieczeństwa wyjaśnia, jak działa obsługa nonce dla skryptów inline przy użyciu CSP.
Minimalna konfiguracja często wygląda tak:
import type { Config } from "@react-router/dev/config";export default { ssr: true,} satisfies Config;Jeśli nie chcesz renderowania po stronie serwera w danym projekcie, React Router dokumentuje też tryb SPA zssr: false. To może działać w niektórych aplikacjach opartych na treści, ale zmienia sposób pobierania i ochrony danych, dlatego SSR nadal częściej lepiej pasuje do dostarczania treści z headless CMS.
Współdzielony klient: jedna brama do treści
Dobra integracja utrzymuje dostęp do CMS w jednym miejscu zamiast powielać konfigurację API w plikach tras.
Na przykład:
import { Client } from "@paragraphcms/client";const apiKey = process.env.PARAGRAPH_API_KEY;if (!apiKey) { throw new Error("PARAGRAPH_API_KEY environment variable is not set");}export const client = new Client({ apiKey });Ten wzorzec jest przydatny niezależnie od tego, który CMS wybierzesz. Najważniejsza lekcja jest architektoniczna:
centralizuj konfigurację API
przechowuj sekrety po stronie serwera
spraw, by loadery zależały od wspólnej granicy integracji
unikaj duplikowania logiki dostępu do treści
Paragraph CMS publicznie pozycjonuje się jako API-first headless CMS z oficjalnymi SDK i szybkimi startami dla frameworków na swojej stronie, dlatego sprawdza się tu jako konkretny przykład.
Struktura tras, od której zaczyna większość zespołów
Prosty serwis z treścią często zaczyna się od zaledwie dwóch tras:
trasy listującej, takiej jak
/blogdynamicznej trasy szczegółów, takiej jak
/blog/:slug
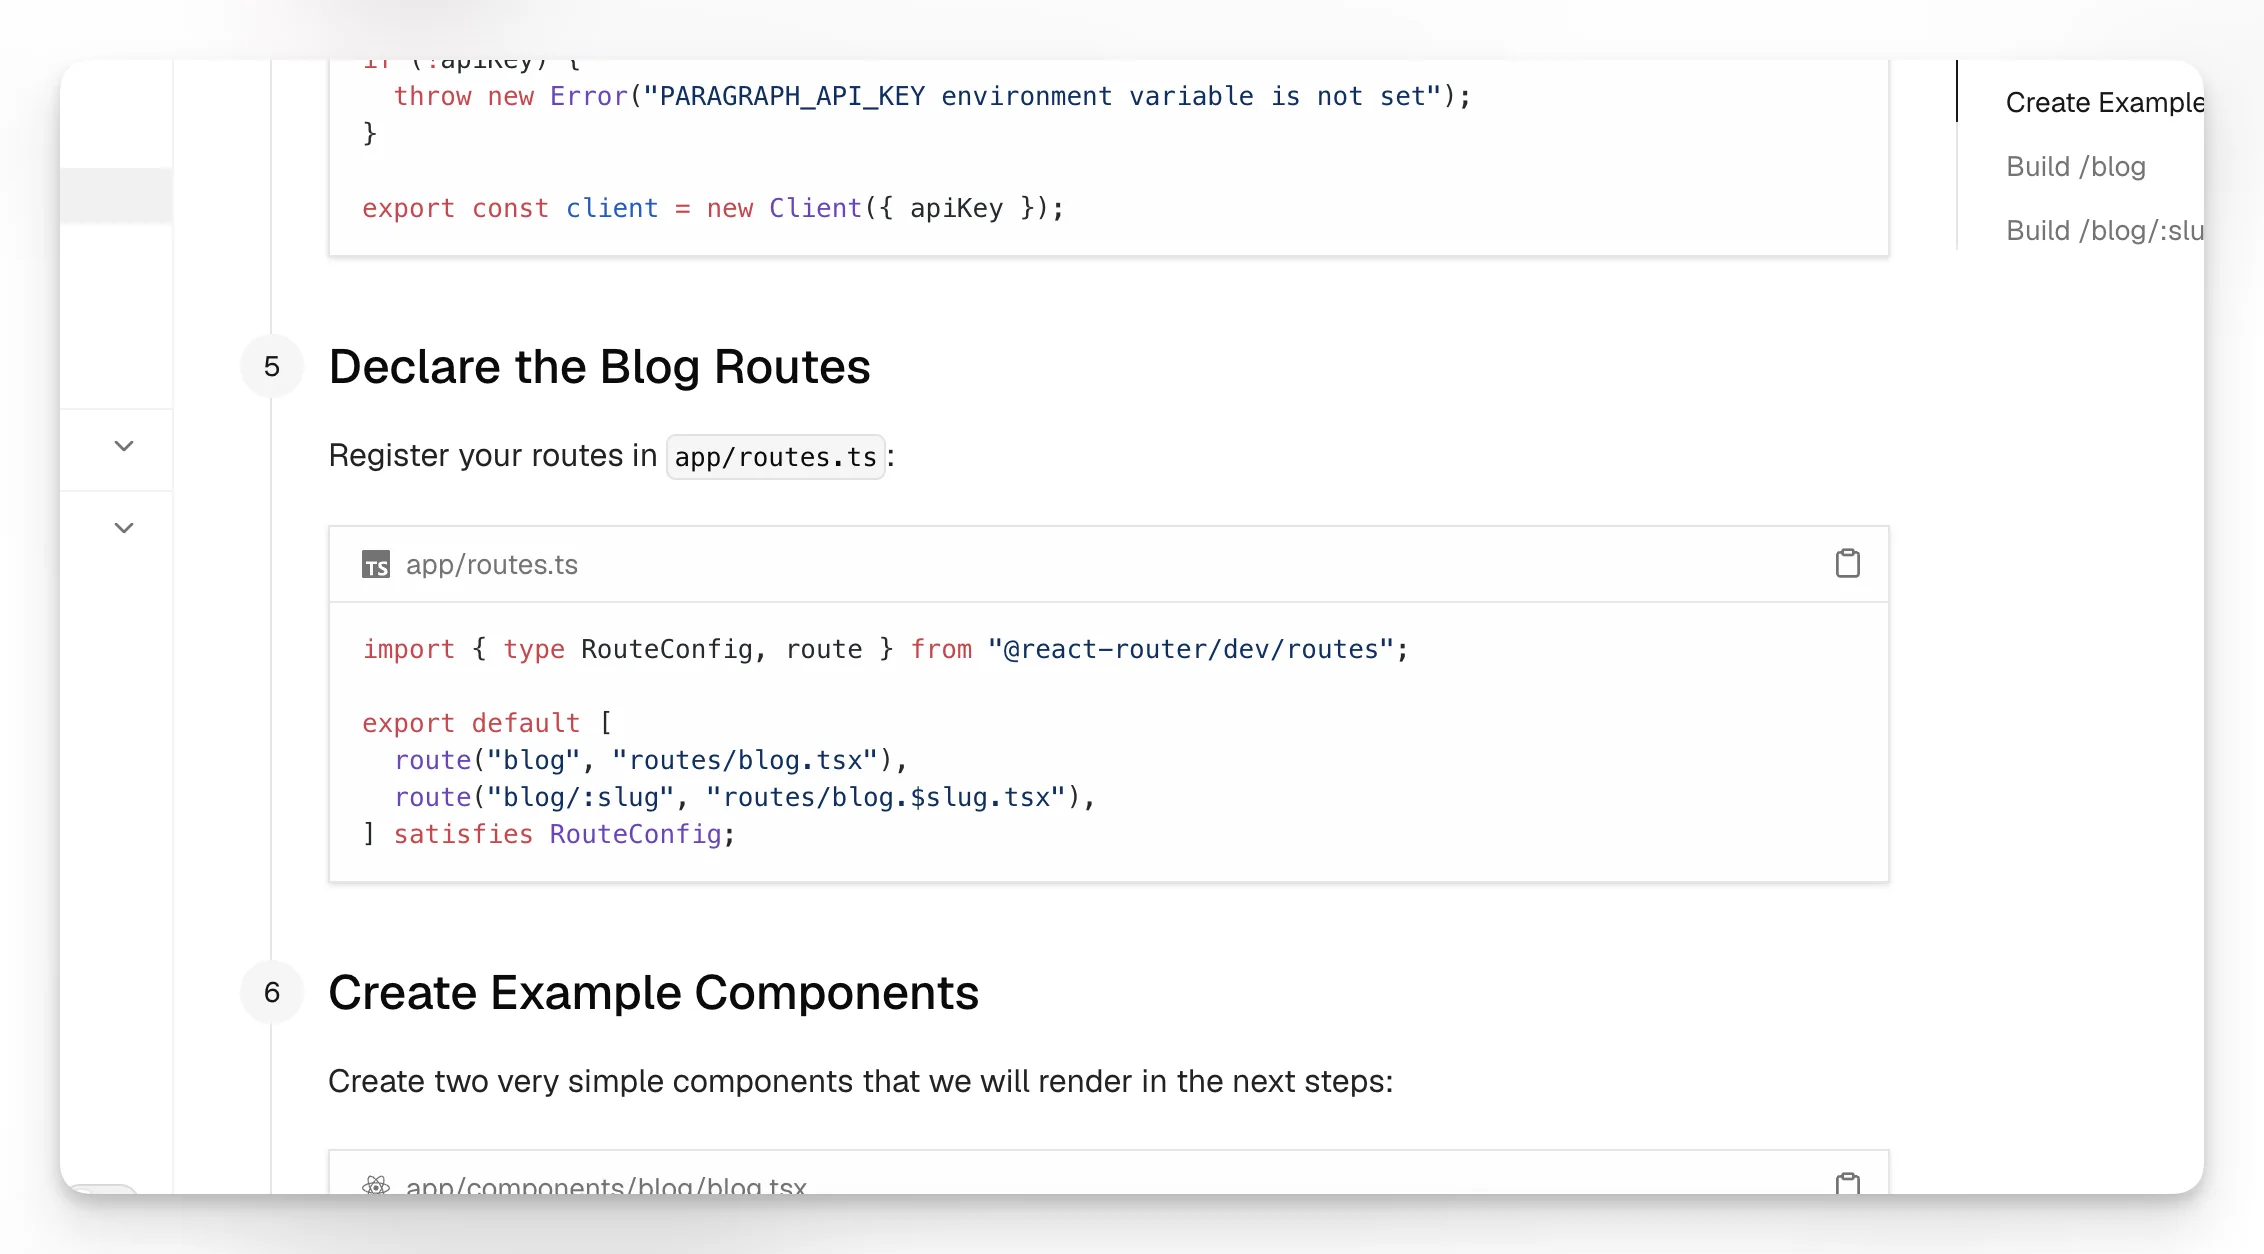
Przykładowa konfiguracja tras:
import { type RouteConfig, route } from "@react-router/dev/routes";export default [ route("blog", "routes/blog.tsx"), route("blog/:slug", "routes/blog.$slug.tsx"),] satisfies RouteConfig;To standardowy wzorzec oparty na slugach dla serwisów contentowych. React Router odpowiada za kształt URL-i, a loader mapuje ten URL na rekord w CMS.
Oficjalny changelog Paragraph CMS podaje, że jego starter dla React Router został wydany 5 czerwca 2026 z działającymi trasami /blog i /blog/[slug], a zaawansowany przykład React Router wydano 8 czerwca 2026 z routingiem uwzględniającym locale oraz generowanymi zasobami takimi jak sitemap i RSS.
Jak działa trasa listująca
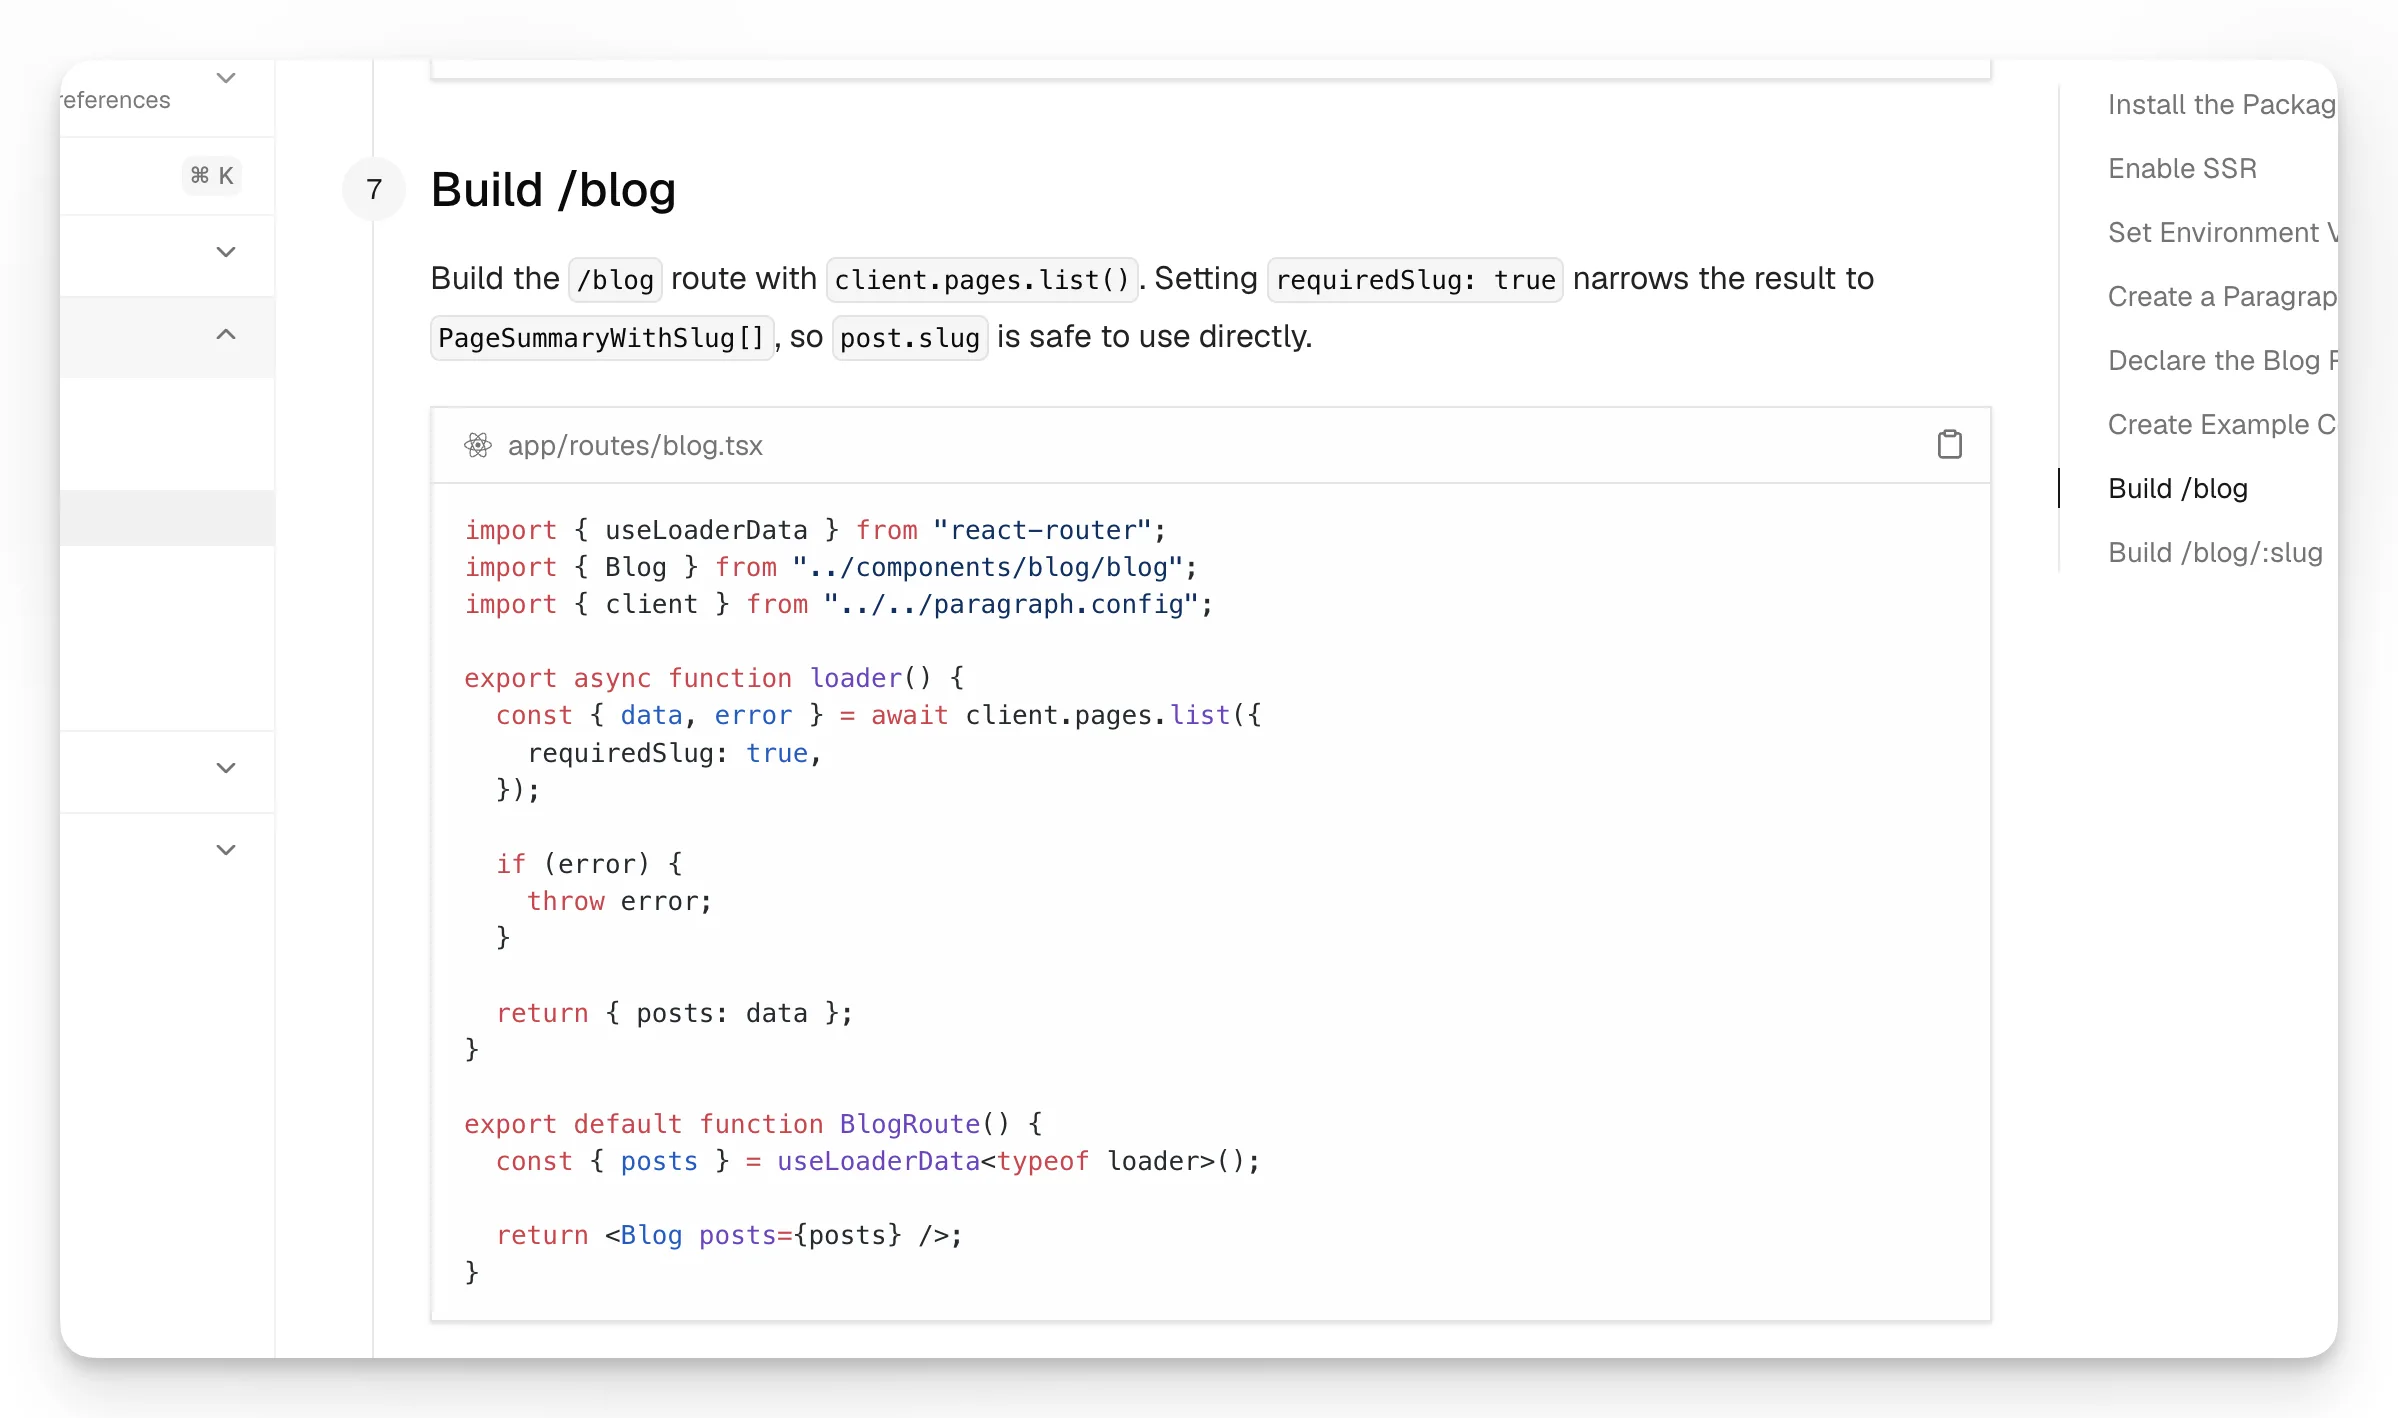
Trasa listująca zwykle pobiera podsumowania treści i pozostawia prezentację warstwie komponentów.
Przykład:
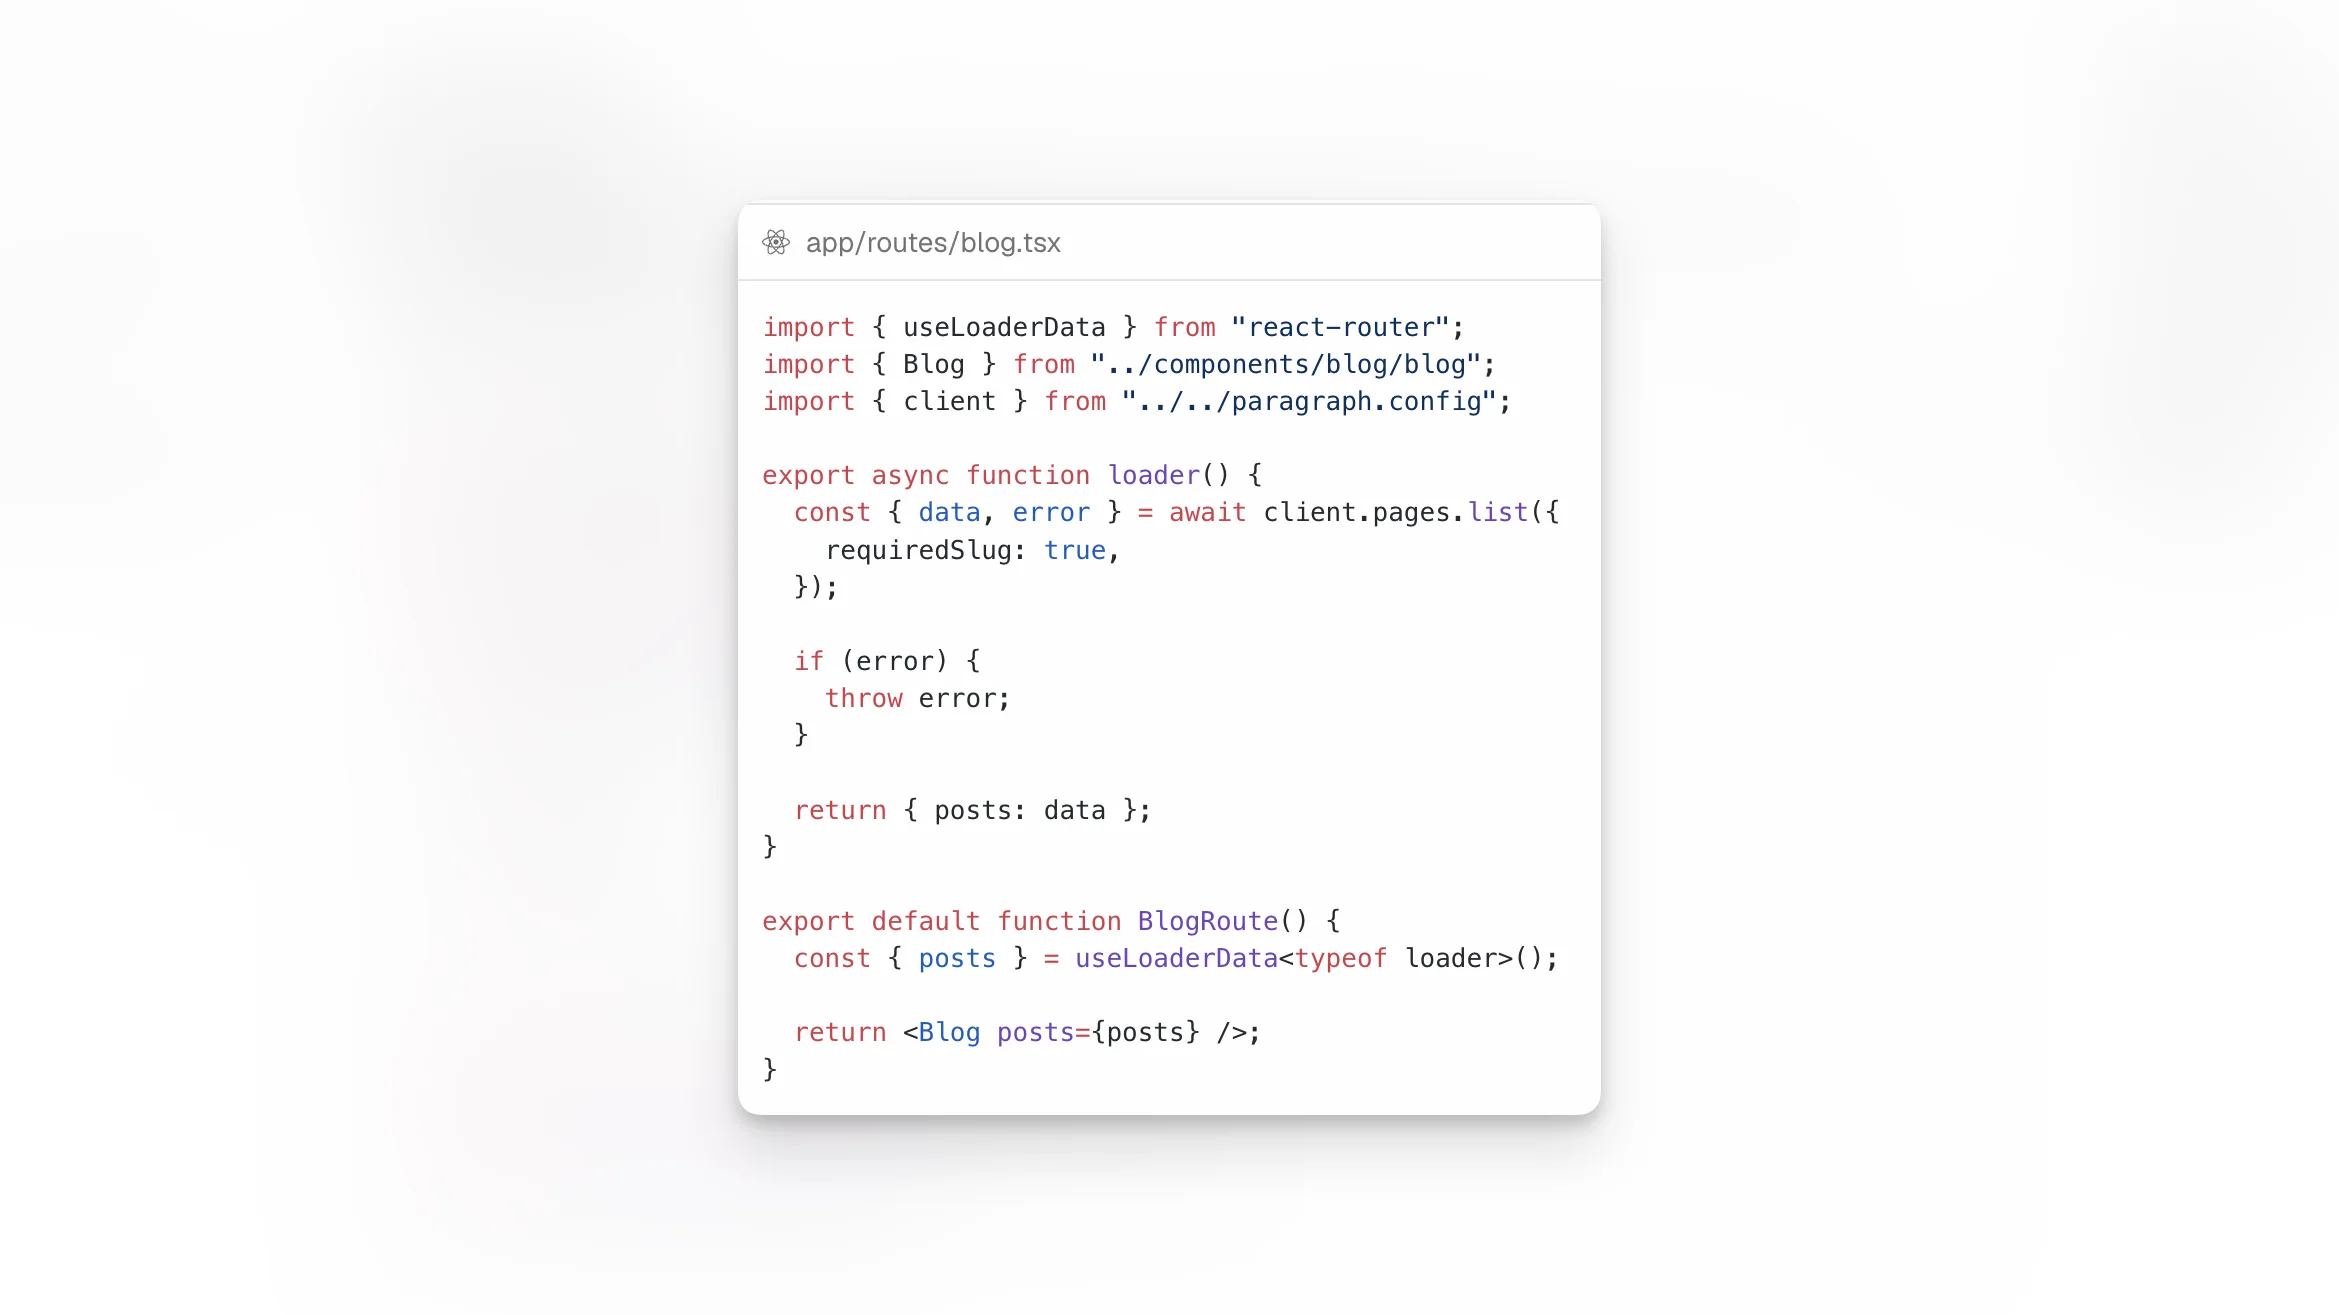
import { useLoaderData } from "react-router";import { Blog } from "../components/blog/blog";import { client } from "../../paragraph.config";export async function loader() { const { data, error } = await client.pages.list({ requiredSlug: true, }); if (error) { throw error; } return { posts: data };}export default function BlogRoute() { const { posts } = useLoaderData<typeof loader>(); return <Blog posts={posts} />;}Ten podział odpowiedzialności jest najważniejszy:
loader pobiera treść
trasa zwraca dane specyficzne dla trasy
komponent UI je renderuje
Changelog Paragraph CMS odnotowuje, że 2 czerwca 2026 client.pages.list() zostało uproszczone dla odpowiedzi bez paginacji, dzięki czemu deweloperzy mogą odczytywać wyniki bezpośrednio z data.
Jak działa trasa oparta na slugu
Trasa szczegółów to klasyczny przepływ headless CMS: odczyt slug z URL-a, pobranie pasującego rekordu i jego renderowanie.
Przykład:
import { useLoaderData } from "react-router";import type { Route } from "./+types/blog.$slug";import { Post } from "../components/blog/post";import { client } from "../../paragraph.config";export async function loader({ params }: Route.LoaderArgs) { const { data, error } = await client.page.getBySlug(params.slug!); if (error) { throw error; } return { data };}export default function BlogPostRoute() { const { data } = useLoaderData<typeof loader>(); return <Post page={data} />;}Ten wzorzec dobrze uogólnia się na:
wpisy blogowe
landing page’e
strony dokumentacji
wpisy changeloga
artykuły bazy wiedzy
case studies
treści zlokalizowane
Dostawca może się zmienić, ale wzorzec trasy zwykle nie.
React Router dokumentuje także type safety modułów tras, co jest przydatne, gdy trasy oparte na slugach stają się bardziej złożone i wymagają przewidywalnego typowania loaderów oraz params.
Renderowanie ustrukturyzowanej treści w React
Prawdziwy headless CMS zwykle zwraca ustrukturyzowaną treść, a nie tylko surowe stringi. Taka treść powinna być renderowana przez zaufany renderer, który rozumie model danych CMS.
Przykład:
import type { PageWithSlug } from "@paragraphcms/client";import { ParagraphContent } from "@paragraphcms/parser-react";export function Post({ page }: { page: PageWithSlug }) { return ( <main> <h1>{page.title}</h1> <ParagraphContent content={page.content} /> </main> );}Lekcja, którą można przenieść gdzie indziej, jest taka:
przechowuj ustrukturyzowaną treść w CMS
pobieraj ustrukturyzowaną treść w loaderach
renderuj ją przez komponenty React lub oficjalny renderer
unikaj spłaszczania wszystkiego do niebezpiecznego HTML, jeśli nie musisz
Warstwa UI pozostaje prosta
Jedną z najlepszych rzeczy w dobrze zaprojektowanej integracji headless CMS jest to, że warstwa UI często staje się bardzo nudna — w pozytywnym sensie.
Przykładowy komponent listy:
import type { PageSummaryWithSlug } from "@paragraphcms/client";import { Link } from "react-router";export function Blog({ posts }: { posts: PageSummaryWithSlug[] }) { return ( <main> <h1>Blog</h1> <ul> {posts.map((post) => ( <li key={post.id}> <Link to={`/blog/${post.slug}`}>{post.title}</Link> </li> ))} </ul> </main> );}To wyraźnie pokazuje podział:
CMS dostarcza ustrukturyzowane dane treści
React Router zapewnia nawigację i granice danych tras
Twoja aplikacja decyduje o designie, układzie, stanach i UX
Co sprawia, że to jest prawdziwy workflow headless CMS
Projekt nie staje się naprawdę „headless” tylko dlatego, że raz wywoła API. Staje się workflow headless CMS wtedy, gdy ten podział jest konsekwentny:
redaktorzy pracują w CMS
deweloperzy odpowiadają za kod frontendowy
aplikacja definiuje trasy
treść jest dostarczana przez API lub SDK
renderowanie jest obsługiwane w aplikacji React
zmiany redakcyjne i zmiany frontendowe mogą postępować niezależnie
Paragraph CMS publicznie przedstawia się jako headless CMS z kluczami API, SDK, treściami wielojęzycznymi, zarządzaniem mediami, SEO stron i wsparciem dla React Router na swojej stronie, co dobrze pasuje do tego modelu jako przykład.
Czego ten układ sam z siebie nie rozwiązuje
Prosta integracja bloga to dobry punkt wyjścia, ale nie rozwiązuje automatycznie wszystkiego.
Nadal musisz zaprojektować:
strategię wielojęzycznych URL-i
workflow podglądów i wersji roboczych
taksonomię i filtrowanie
unieważnianie cache
indeksowanie wyszukiwania
strategię metadanych
kontrolę dostępu
governance na poziomie enterprise
Changelog Paragraph CMS pokazuje, jak starter może rozwinąć się w pełniejszą konfigurację. 8 czerwca 2026 dostawca opublikował zaawansowane przykłady z routingiem bloga uwzględniającym locale oraz generowanymi sitemap.xml, robots.txt, llms.txt i feedami RSS. 25 maja 2026 ogłosił też pakiet SEO do generowania tego typu zasobów.
Jak ocenić dowolny headless CMS dla React Router
Jeśli porównujesz opcje CMS dla aplikacji React Router, zadawaj praktyczne pytania zamiast pytań o markę.
Modelowanie treści
Czy potrafi jasno odwzorować Twoje typy treści?
Czy obsługuje ustrukturyzowaną treść, a nie tylko płaski rich text?
Czy slugi, metadane i relacje są łatwe w zarządzaniu?
Dostarczanie
Czy zapewnia przejrzyste API lub oficjalne SDK?
Czy potrafisz efektywnie rozwiązywać treść po slugu?
Czy kształt odpowiedzi jest wystarczająco przewidywalny dla loaderów tras?
Dopasowanie do React Router
Czy dobrze współpracuje z SSR?
Czy sekrety mogą pozostać po stronie serwera?
Czy integracja jest prosta w loaderach tras i modułach tras?
Potrzeby skalowania
Czy obsługuje lokalizację?
Czy dobrze radzi sobie z mediami?
Czy pomaga przy metadanych SEO i zasobach do indeksowania?
Czy może rozwinąć się od prostego bloga do większego systemu treści?
To są właściwe pytania niezależnie od tego, czy używasz Paragraph CMS, czy innego headless CMS.
Kwestie bezpieczeństwa
Każda integracja z headless CMS powinna traktować bezpieczeństwo jako część architektury.
Podstawowe dobre praktyki obejmują:
przechowywanie kluczy API w zmiennych środowiskowych
pobieranie chronionej treści na serwerze, gdy to możliwe
unikanie ujawniania uprzywilejowanych poświadczeń w przeglądarce
używanie zaufanych metod renderowania ustrukturyzowanej treści
poprawną konfigurację CSP, jeśli aplikacja z niego korzysta
Oficjalny przewodnik bezpieczeństwa React Router wyjaśnia konkretnie obsługę nonce dla skryptów inline w aplikacjach opartych na CSP, a ServerRouter wspiera przekazywanie nonce dla zgodności z CSP. Jeśli chcesz dodatkowej ochrony przed przypadkowym dołączeniem kodu tylko-serwerowego do bundla klienta, React Router dokumentuje także moduły .server.
Konsekwencje wzorca dla SEO
Headless CMS sam z siebie nie tworzy SEO. To, co pomaga SEO, to połączenie:
stabilnej architektury URL-i
HTML renderowanego po stronie serwera
dobrej obsługi metadanych
linkowania wewnętrznego
ustrukturyzowanego modelowania treści
generowanych zasobów dla crawlerów tam, gdzie są potrzebne
To kolejny powód, dla którego React Router dobrze się tu sprawdza: frontend odpowiada za URL-e, renderowanie i strategię metadanych, podczas gdy CMS odpowiada za treść źródłową.
Lepsze ujęcie tego tematu
Najlepsze ujęcie redakcyjne jest proste:
To artykuł o wzorcu React Router headless CMS, wykorzystujący jeden CMS jako przykład implementacji.
To lepsze niż zamienianie strony w prezentację produktu, ponieważ deweloperzy szukający tego terminu zwykle chcą zrozumieć:
jak działają loadery
jak wpisuje się w to SSR
jak trasy oparte na slugach pobierają treść
jak renderowana jest ustrukturyzowana treść
jak oddzielić zarządzanie treścią od logiki aplikacji frontendowej
Praktyczny wniosek
Jeśli chcesz najkrótszego trafnego podsumowania, brzmi ono tak:
React Router dobrze współpracuje z headless CMS, ponieważ daje ładowanie po stronie serwera na poziomie tras, wsparcie dla SSR, prymitywy bezpieczeństwa dla prawdziwych aplikacji i pełną kontrolę nad tym, jak renderowana jest treść. CMS staje się wtedy backendem treści stojącym za tą warstwą aplikacji.
To jest sedno tego wzorca.
Co w praktyce oznacza „React Router headless CMS”?
Oznacza to, że React Router obsługuje trasy, loadery, SSR i renderowanie UI, podczas gdy headless CMS przechowuje i dostarcza treść przez API lub SDK.
Dlaczego React Router dobrze nadaje się do headless CMS?
Ponieważ zapewnia ładowanie danych oparte na trasach, wsparcie dla renderowania po stronie serwera, kontrolę nad strukturą URL-i oraz wyraźną granicę między pobieraniem treści a renderowaniem UI.
Czy potrzebuję SSR w konfiguracji React Router headless CMS?
Nie zawsze, ale SSR często jest najlepszym wyborem, ponieważ utrzymuje poświadczenia na serwerze, rozwiązuje treść przed wysłaniem HTML i bardziej naturalnie wspiera scenariusze SEO oparte na dużej ilości treści.
Jaki jest typowy wzorzec tras dla treści z CMS?
Najczęstszym punktem wyjścia jest jedna trasa listująca, taka jak /blog, oraz jedna trasa szczegółów, taka jak /blog/:slug. Loader odczytuje slug i pobiera pasujący wpis z CMS.
Czy ten wzorzec może działać z innymi platformami CMS niż Paragraph CMS?
Tak. Ta architektura jest niezależna od dostawcy. Każdy CMS z użytecznym API lub SDK, obsługą slugów i dostarczaniem ustrukturyzowanej treści zwykle może pasować do tego samego wzorca React Router.
Co powinienem ocenić przy wyborze CMS dla React Router?
Skup się na jakości API, zgodności z SSR, obsłudze ustrukturyzowanej treści, rozwiązywaniu slugów, obsłudze mediów, lokalizacji, wsparciu dla metadanych i tym, jak czysto model treści mapuje się na strukturę Twoich tras.