React Router Headless CMS: Hoe het werkt
Leer hoe React Router en een headless CMS samenwerken voor SEO-vriendelijke SSR, route-loaders en gestructureerde contentlevering.
 Grzegorz
Wanneer mensen zoeken naar React Router headless CMS, zijn ze meestal niet op zoek naar één leverancier. Ze willen een frontendarchitectuur begrijpen: React Router verwerkt routes, loaders, serverrendering en UI-compositie, terwijl een headless CMS gestructureerde content opslaat en levert via een API of SDK. React Router documenteert expliciet ServerRouter, Scripts en beveiligingsrichtlijnen voor SSR-applicaties, en daarom past het goed bij dit patroon.
Dit artikel legt dat patroon op een heldere, CMS-agnostische manier uit. Om de concepten concreet te maken, gebruikt het Paragraph CMS als voorbeeld omdat de leverancier publiekelijk React Router-ondersteuning, starterprojecten en meer geavanceerde voorbeelden documenteert op de officiële site en in de changelog.
TL;DR: In een React Router headless CMS-opzet beheert React Router de applicatielaag en beheert het CMS de contentlaag. Het belangrijkste is de architectuur, niet het CMS-merk.
Wat “React Router headless CMS” betekent
Een headless CMS beheert content zonder je frontend-presentatielaag te controleren. Je React Router-app wordt het systeem dat bepaalt:
welke URL's bestaan
welke data elke route laadt
hoe content wordt gerenderd
hoe layouts, navigatie en UI-gedrag werken
In de praktijk betekent dat meestal:
het CMS slaat pagina's, items, slugs, metadata en rich content op
React Router definieert de routeboom
loaders halen content op de server op
routemodules geven data door aan componenten
React-componenten renderen gestructureerde content naar de uiteindelijke UI
Die verantwoordelijkheidsverdeling is het kernidee achter de term React Router headless CMS.
Waarom React Router goed past bij headless CMS-projecten
React Router past goed bij headless CMS-delivery omdat het server-gerenderde applicaties ondersteunt in Framework Mode, inclusief een specifiek ServerRouter-entrypoint en ingebouwde afhandeling van documentscripts via Scripts. De beveiligingsdocumentatie behandelt ook CSP nonce-afhandeling voor server-gerenderde apps.
Voor contentgedreven applicaties is dat belangrijk omdat teams meestal nodig hebben:
paginabepaling op basis van URL's
server-side dataladen
SEO-vriendelijke HTML-output
veilige afhandeling van API-credentials
controle op route-niveau over ophalen
volledige vrijheid over de componentlaag
Die behoeften sluiten van nature aan op de loader-gedreven architectuur van React Router. Als je een blog, documentatiesite, marketingsite, knowledge base of redactioneel platform bouwt, geeft het framework je al de meeste bouwstenen die je nodig hebt. Je kunt ook de officiële gids over renderingstrategieën en de react-router.config.tsreferentie bekijken om te zien hoe SSR- en SPA-modi verschillen.
De architectuur: eerst het framework, daarna het CMS
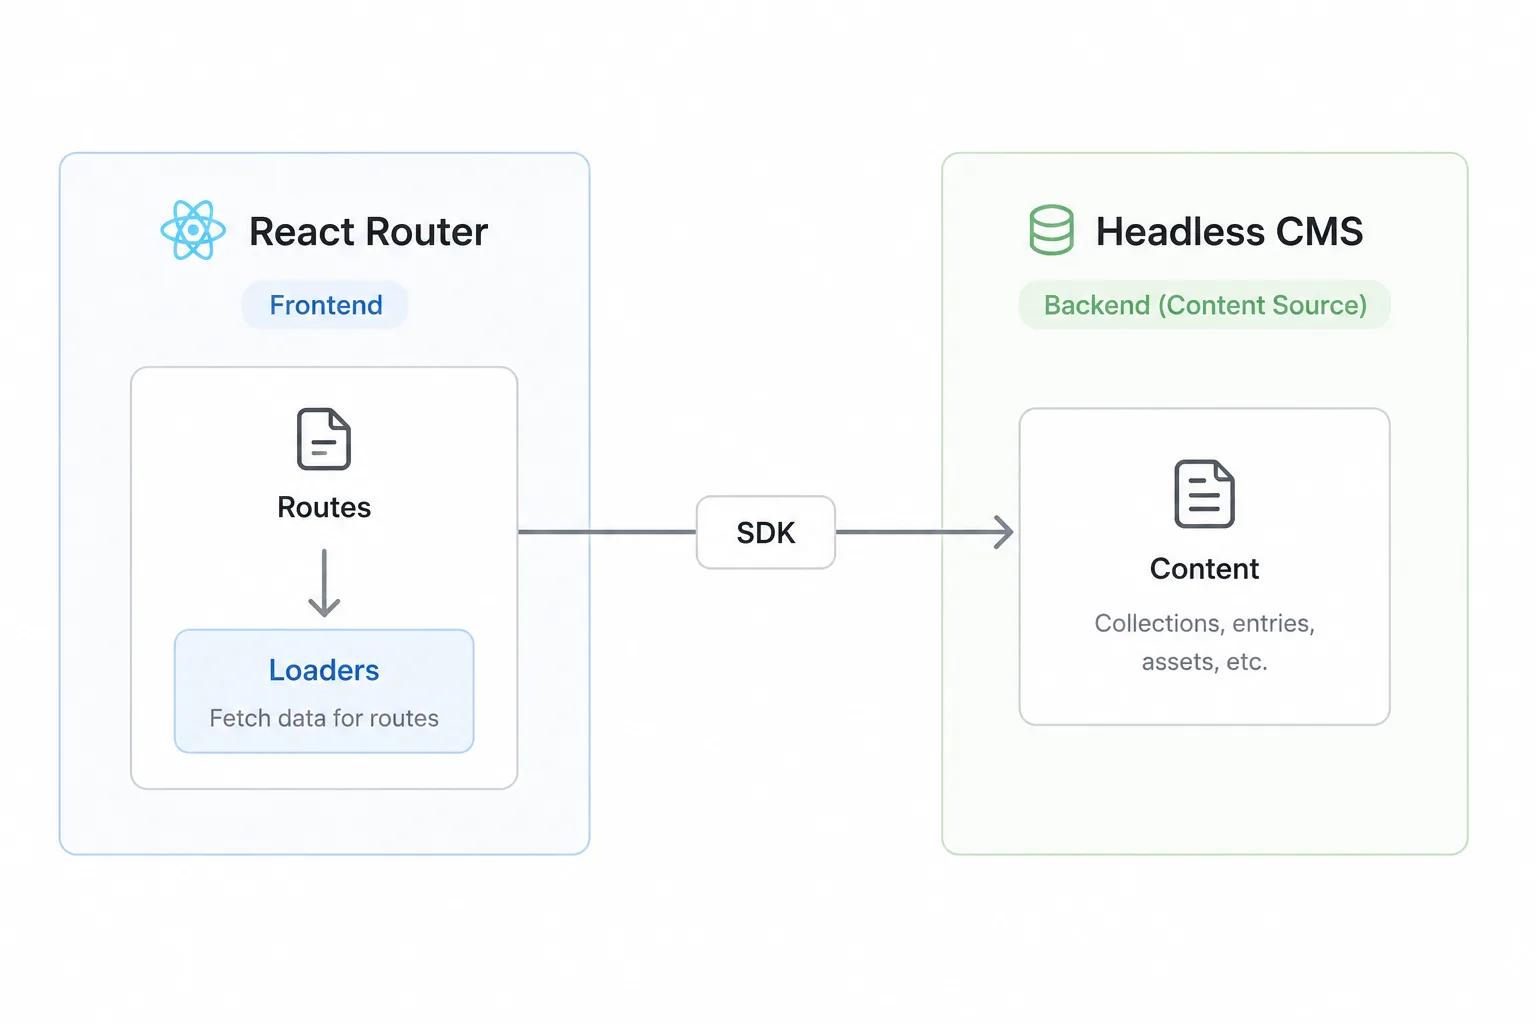
De duidelijkste manier om over deze opzet na te denken is:
React Router is het applicatieframework.
Het headless CMS is de contentbackend.
Een API-client of SDK verbindt die twee.
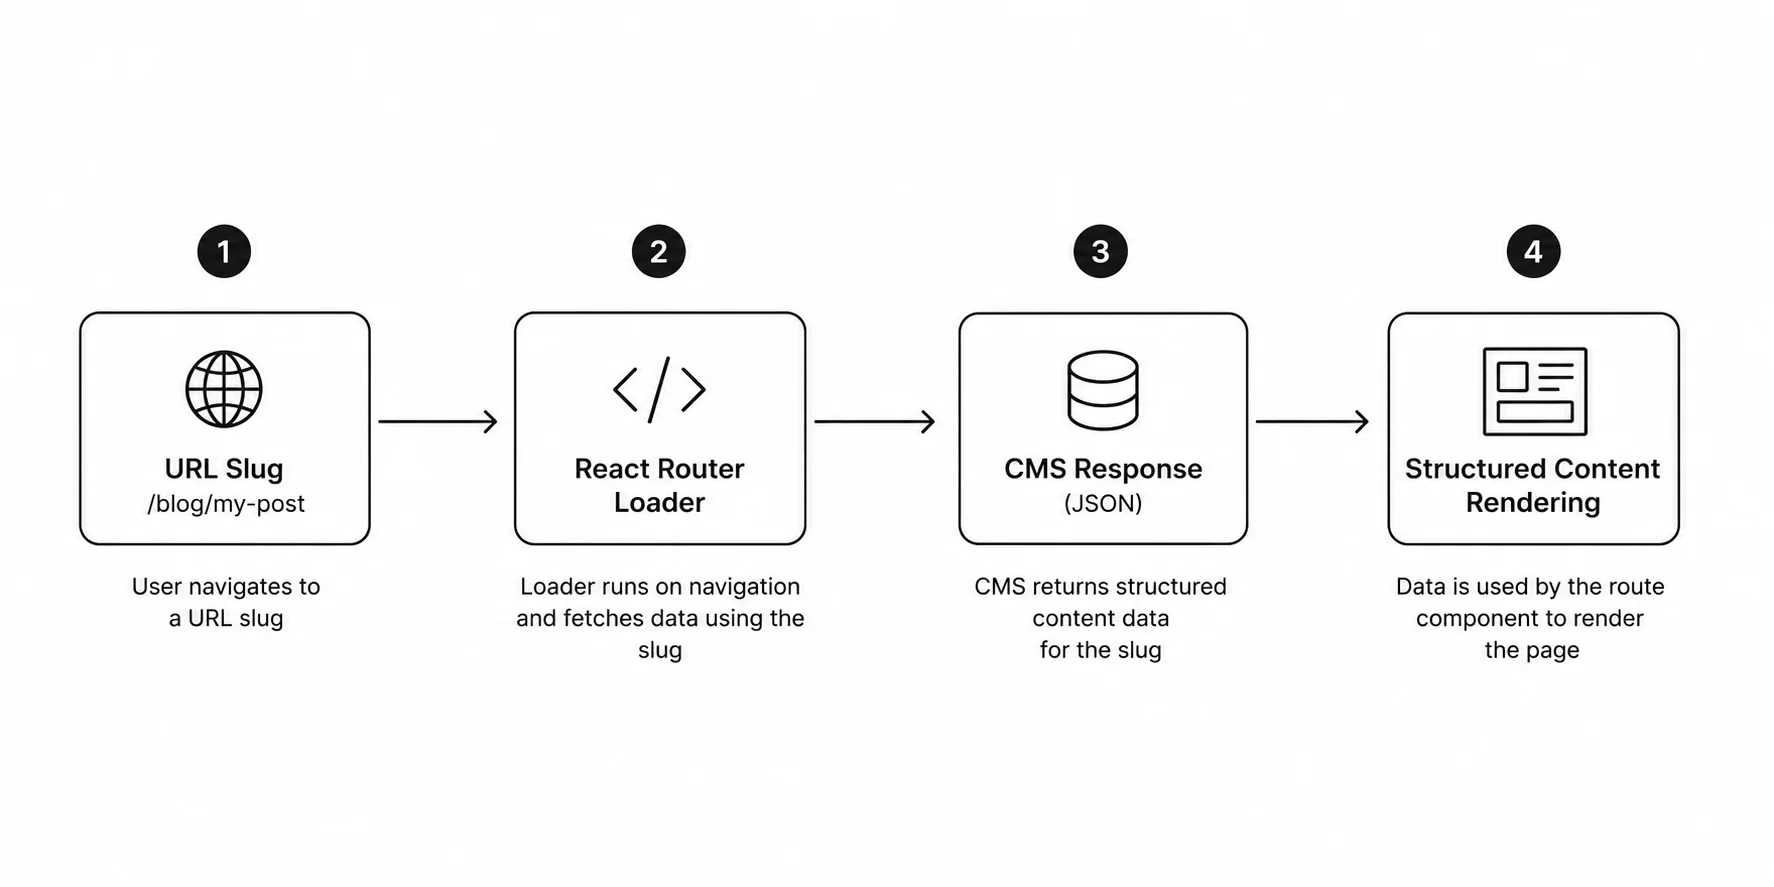
Route-loaders halen de data voor een URL op.
React-componenten bepalen hoe de content wordt gepresenteerd.
Die benadering is belangrijk omdat ze de frontendarchitectuur helder houdt. Een CMS kan makkelijker worden vervangen dan je routingmodel, renderingmodel en applicatie-UX. De leveranciersspecifieke integratie is belangrijk, maar die zou pas na het architectuurpatroon moeten komen.
Hoe een typische React Router headless CMS-stack eruitziet
De meeste implementaties komen uit op dezelfde basisonderdelen:
een React Router-app die met SSR draait
omgevingsvariabelen voor CMS-credentials
een gedeelde API-client
één of meer lijst-routes
één of meer dynamische slug-routes
een renderer voor gestructureerde content
optionele SEO-helpers voor sitemap, robots, feeds en metadata
Die structuur is breder dan welk CMS dan ook. Het is simpelweg het normale deliverymodel voor headless content in een routegebaseerde React-app.
Waarom SSR belangrijk is in dit patroon
Server-side rendering maakt meestal deel uit van de architectuur, niet alleen van een prestatie-optimalisatie.
Met SSR:
loaders kunnen CMS-data op de server ophalen
API-sleutels blijven buiten de browserbundle
pagina's kunnen content bepalen voordat HTML wordt verstuurd
slug-gebaseerde content is makkelijker te serveren voor SEO en previews
gestructureerde content kan worden gerenderd met data die al beschikbaar is
De documentatie van React Router maakt dat server-first model expliciet. ServerRouter is het server-entrypoint voor Framework Mode, en de beveiligingsgids legt uit hoe nonce-afhandeling werkt voor inline scripts wanneer je CSP gebruikt.
Een minimale configuratie ziet er vaak zo uit:
import type { Config } from "@react-router/dev/config";export default { ssr: true,} satisfies Config;Als je geen serverrendering wilt voor een bepaald project, documenteert React Router ook een SPA-modus metssr: false. Dat kan werken voor sommige contentapplicaties, maar het verandert hoe je data ophaalt en beschermt, en daarom blijft SSR vaker de meest geschikte keuze voor headless CMS-delivery.
Gedeelde client: één contentgateway
Een goede integratie houdt CMS-toegang op één plek in plaats van API-configuratie te herhalen in routebestanden.
Bijvoorbeeld:
import { Client } from "@paragraphcms/client";const apiKey = process.env.PARAGRAPH_API_KEY;if (!apiKey) { throw new Error("PARAGRAPH_API_KEY environment variable is not set");}export const client = new Client({ apiKey });Dit patroon is nuttig ongeacht welk CMS je kiest. De belangrijkste les is architectonisch:
centraliseer API-configuratie
houd geheimen op de server
laat loaders afhangen van een gedeelde integratiegrens
vermijd dubbele logica voor contenttoegang
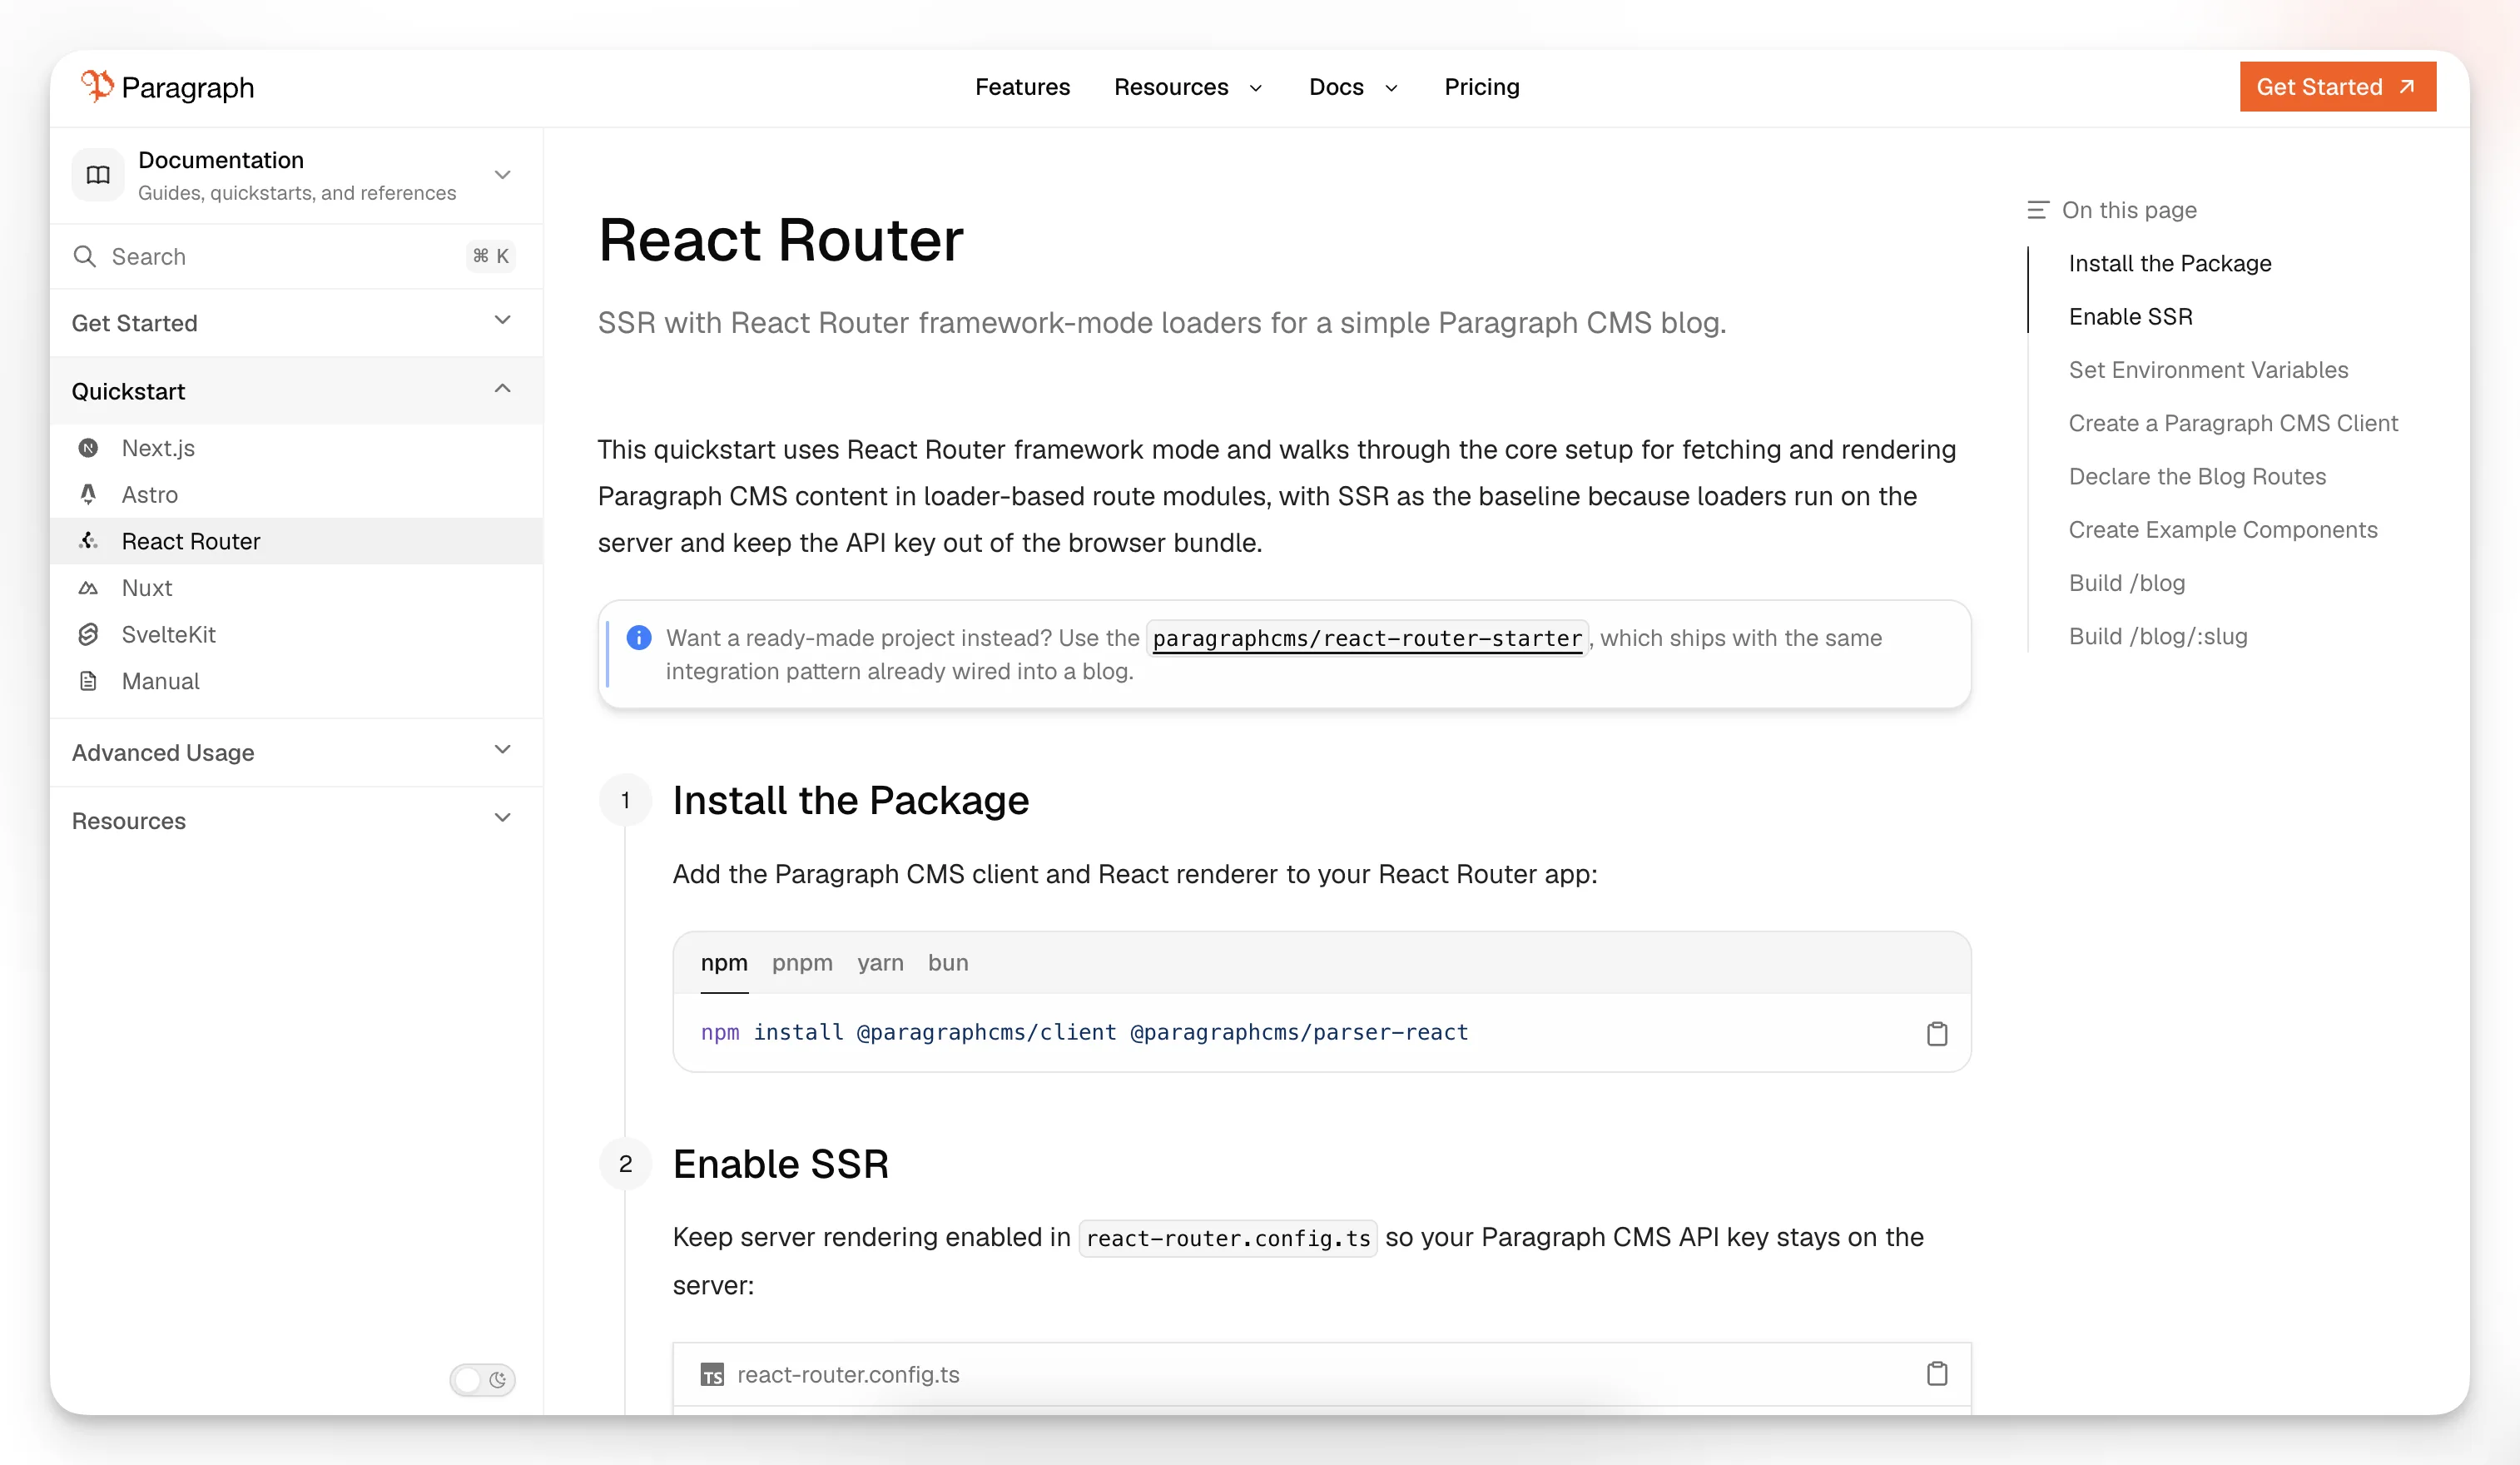
Paragraph CMS positioneert zichzelf publiekelijk als een API-first headless CMS met officiële SDK's en framework-quickstarts op de website, en daarom werkt het hier goed als concreet voorbeeld.
De routestructuur waar de meeste teams mee beginnen
Een eenvoudige contentsite begint vaak met slechts twee routes:
een overzichtsroute zoals
/blogeen dynamische detailroute zoals
/blog/:slug
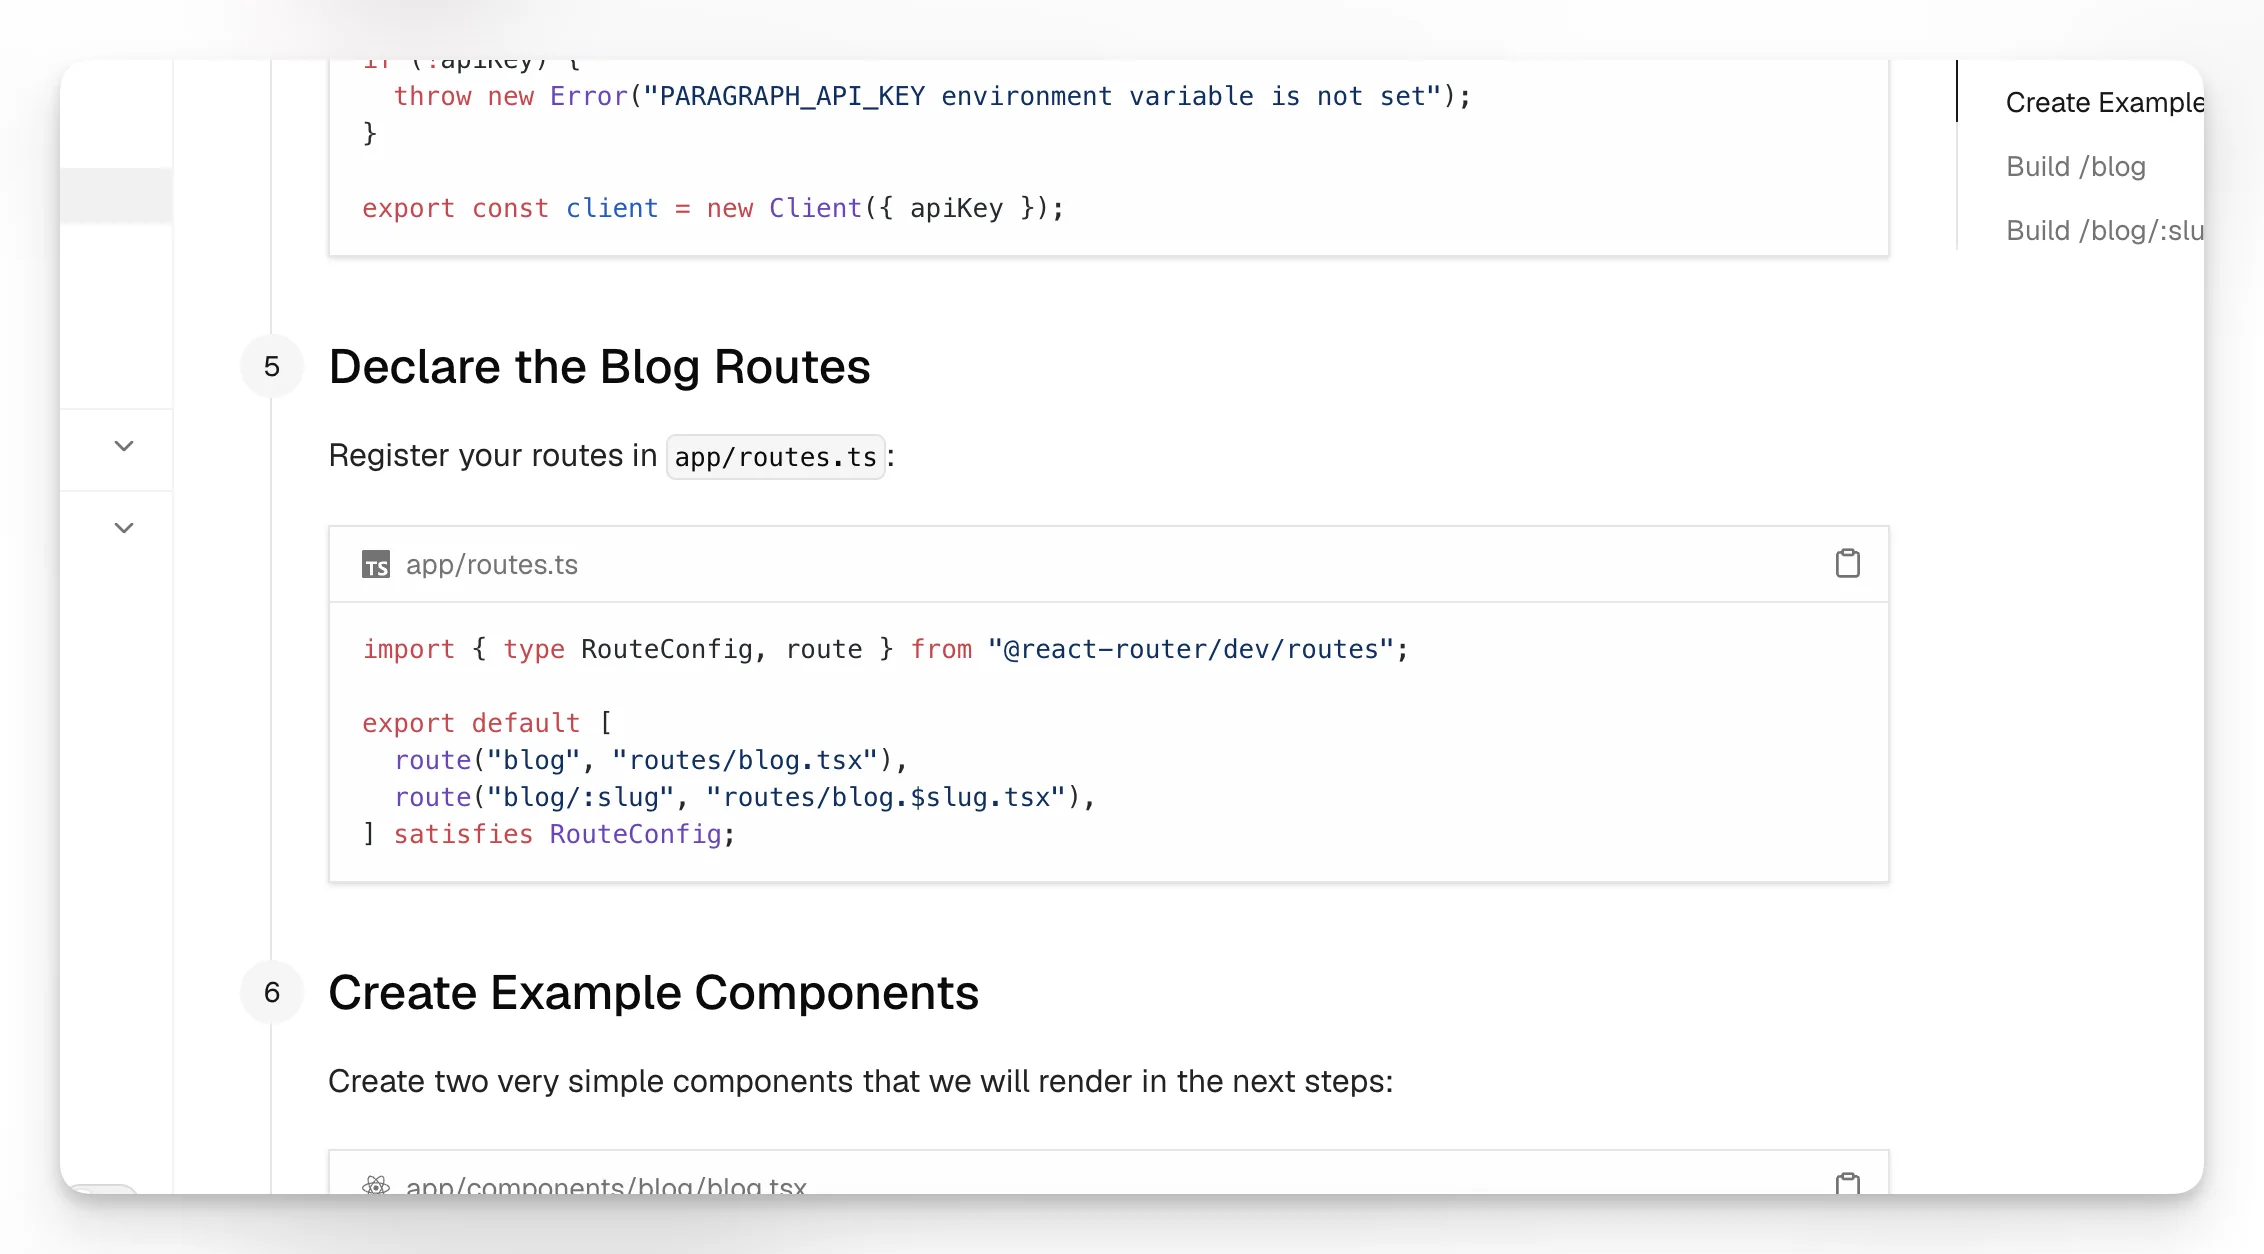
Voorbeeld van routeconfiguratie:
import { type RouteConfig, route } from "@react-router/dev/routes";export default [ route("blog", "routes/blog.tsx"), route("blog/:slug", "routes/blog.$slug.tsx"),] satisfies RouteConfig;Dit is het standaard slug-gedreven patroon voor contentsites. React Router beheert de URL-structuur, en de loader koppelt die URL aan een CMS-record.
De officiële changelog van Paragraph CMS vermeldt dat de React Router-starter op June 5, 2026 is uitgebracht met werkende /blog- en /blog/[slug]-routes, en dat het geavanceerde React Router-voorbeeld op June 8, 2026 is uitgebracht met locale-aware routing en gegenereerde resources zoals sitemap en RSS.
Hoe de overzichtsroute werkt
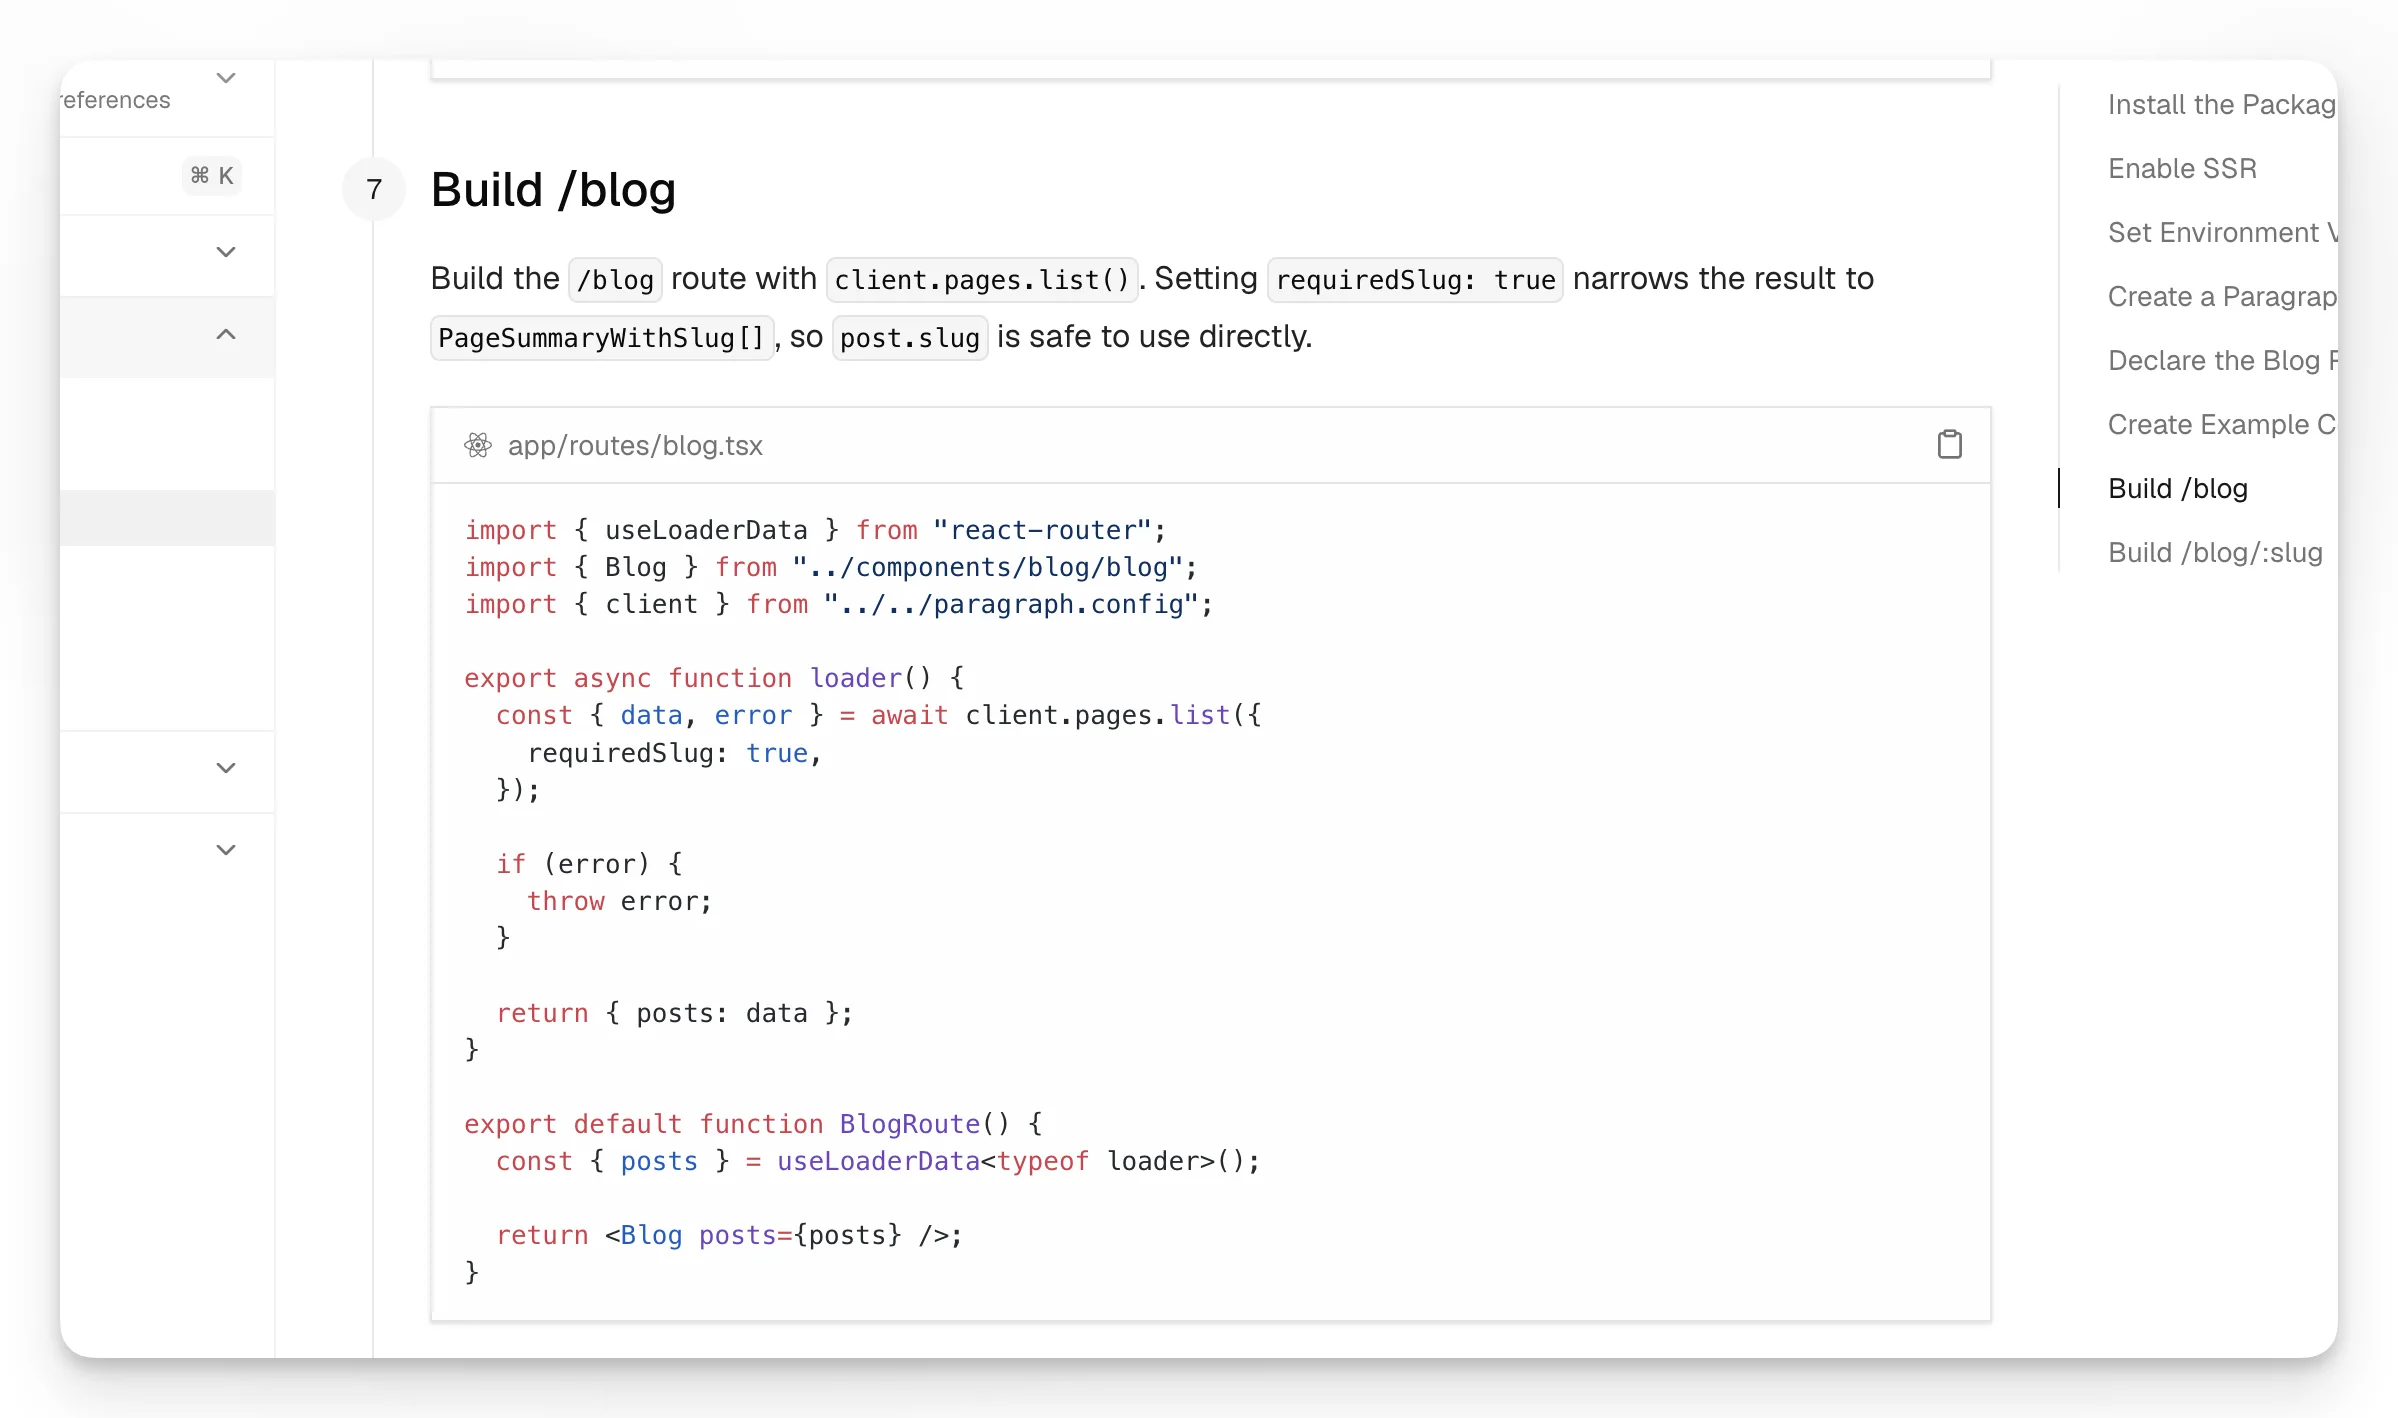
De overzichtsroute haalt meestal contentsamenvattingen op en laat de presentatie over aan de componentlaag.
Bijvoorbeeld:
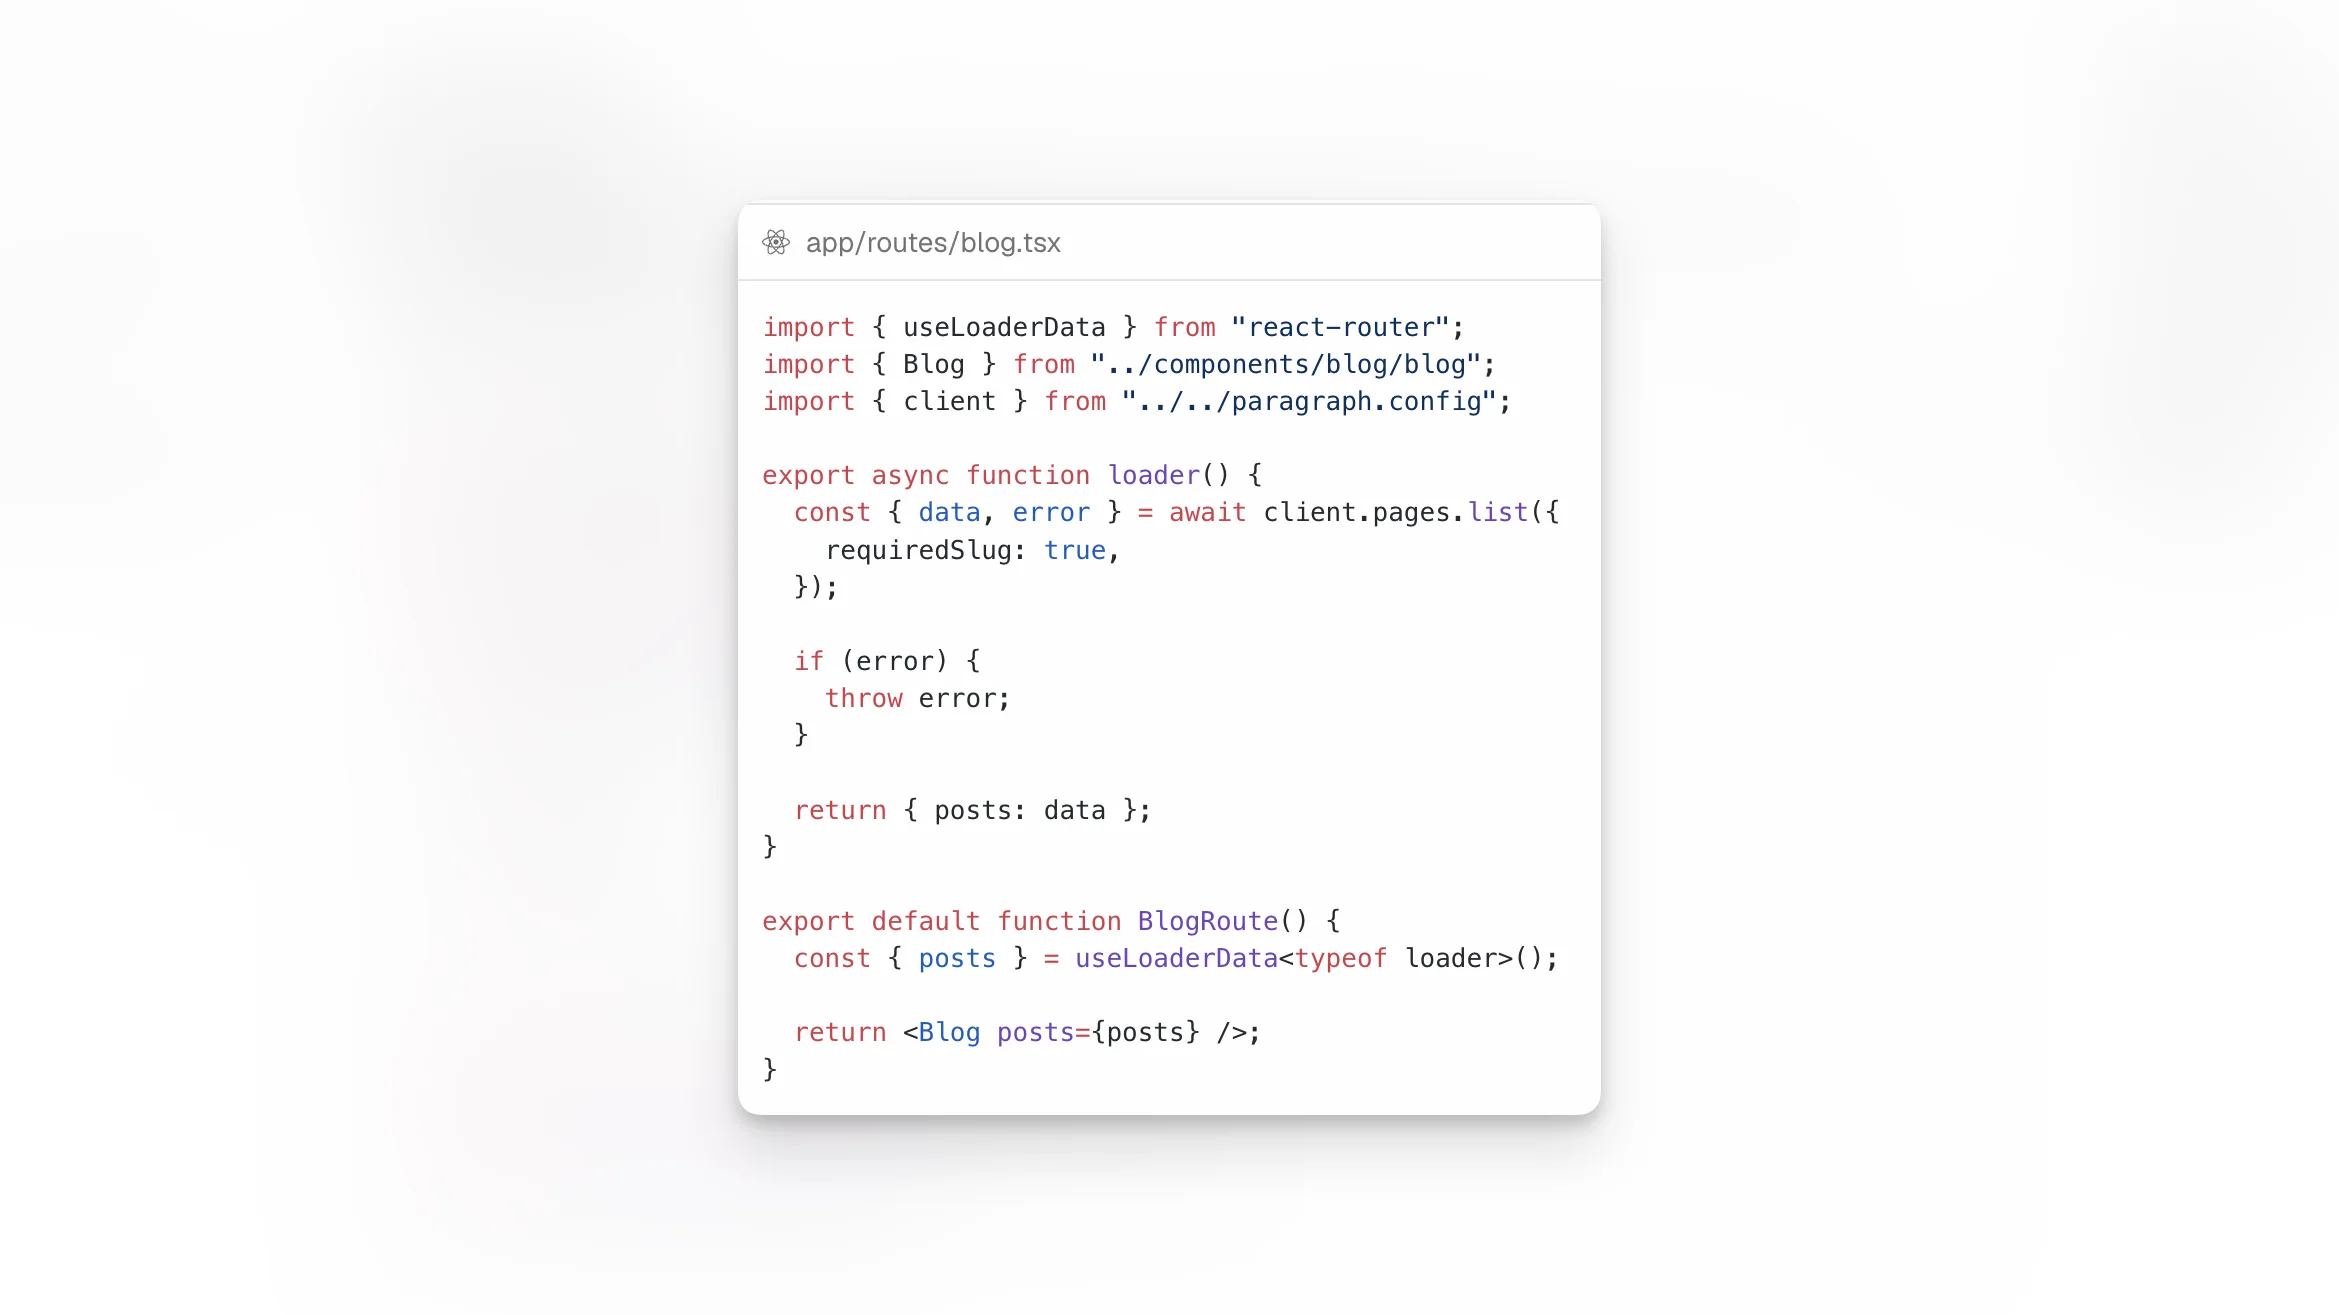
import { useLoaderData } from "react-router";import { Blog } from "../components/blog/blog";import { client } from "../../paragraph.config";export async function loader() { const { data, error } = await client.pages.list({ requiredSlug: true, }); if (error) { throw error; } return { posts: data };}export default function BlogRoute() { const { posts } = useLoaderData<typeof loader>(); return <Blog posts={posts} />;}Die scheiding van verantwoordelijkheden is het belangrijkste punt:
de loader haalt content op
de route retourneert routespecifieke data
de UI-component rendert die
De changelog van Paragraph CMS vermeldt dat op June 2, 2026 client.pages.list() is vereenvoudigd voor niet-gepagineerde responses, zodat ontwikkelaars resultaten direct uit data kunnen lezen.
Hoe de slug-route werkt
De detailroute is de klassieke headless CMS-flow: lees de URL-slug, haal het bijpassende record op en render het.
Bijvoorbeeld:
import { useLoaderData } from "react-router";import type { Route } from "./+types/blog.$slug";import { Post } from "../components/blog/post";import { client } from "../../paragraph.config";export async function loader({ params }: Route.LoaderArgs) { const { data, error } = await client.page.getBySlug(params.slug!); if (error) { throw error; } return { data };}export default function BlogPostRoute() { const { data } = useLoaderData<typeof loader>(); return <Post page={data} />;}Dit patroon is goed te generaliseren naar:
blogposts
landingspagina's
documentatiepagina's
changelog-items
knowledge base-artikelen
case studies
gelokaliseerde content
De leverancier kan veranderen, maar het routepatroon meestal niet.
React Router documenteert ook typeveiligheid voor routemodules, wat nuttig is wanneer je slug-routes complexer worden en voorspelbare typing voor loaders en params nodig hebben.
Gestructureerde content renderen in React
Een echt headless CMS retourneert meestal gestructureerde content, niet alleen ruwe strings. Die content moet worden gerenderd via een vertrouwde renderer die het CMS-datamodel begrijpt.
Bijvoorbeeld:
import type { PageWithSlug } from "@paragraphcms/client";import { ParagraphContent } from "@paragraphcms/parser-react";export function Post({ page }: { page: PageWithSlug }) { return ( <main> <h1>{page.title}</h1> <ParagraphContent content={page.content} /> </main> );}De overdraagbare les is:
sla gestructureerde content op in het CMS
haal gestructureerde content op in loaders
render die via React-componenten of een officiële renderer
voorkom dat je alles plat slaat tot onveilige HTML als dat niet nodig is
De UI-laag blijft eenvoudig
Een van de beste dingen aan een nette headless CMS-integratie is dat de UI vaak op een goede manier heel saai wordt.
Voorbeeld van een lijstcomponent:
import type { PageSummaryWithSlug } from "@paragraphcms/client";import { Link } from "react-router";export function Blog({ posts }: { posts: PageSummaryWithSlug[] }) { return ( <main> <h1>Blog</h1> <ul> {posts.map((post) => ( <li key={post.id}> <Link to={`/blog/${post.slug}`}>{post.title}</Link> </li> ))} </ul> </main> );}Dat laat de verdeling duidelijk zien:
het CMS levert gestructureerde contentdata
React Router levert navigatie en route-datagrensvlakken
jouw app bepaalt design, layout, states en UX
Wat dit tot een echte headless CMS-workflow maakt
Een project is niet echt “headless” alleen omdat het één keer een API aanroept. Het wordt een headless CMS-workflow wanneer de scheiding consequent is:
editors werken in het CMS
ontwikkelaars beheren de frontend-codebase
de app definieert routes
content wordt geleverd via een API of SDK
rendering wordt afgehandeld in de React-app
redactionele wijzigingen en frontendwijzigingen kunnen onafhankelijk van elkaar bewegen
Paragraph CMS presenteert zichzelf publiekelijk als een headless CMS met API-sleutels, SDK's, meertalige content, mediabeheer, pagina-SEO en React Router-ondersteuning op de site, wat goed aansluit bij dat model als voorbeeld.
Wat deze opzet niet vanzelf oplost
Een eenvoudige blogintegratie is een goed startpunt, maar lost niet automatisch alles op.
Je moet nog steeds ontwerpen:
meertalige URL-strategie
preview- en draft-workflows
taxonomie en filtering
cache-invalidatie
zoekindexering
metadatastrategie
toegangscontrole
enterprise-governance
De changelog van Paragraph CMS laat zien hoe een starter kan uitgroeien tot een completere opzet. Op June 8, 2026 publiceerde de leverancier geavanceerde voorbeelden met locale-aware blogrouting plus gegenereerde sitemap.xml, robots.txt, llms.txt en RSS-feeds. Op May 25, 2026 kondigde het ook een SEO-pakket aan voor het genereren van dit soort resources.
Hoe je elk headless CMS voor React Router beoordeelt
Als je CMS-opties voor een React Router-app vergelijkt, stel dan praktische vragen in plaats van merkvragen.
Contentmodellering
Kan het je contenttypes duidelijk weergeven?
Ondersteunt het gestructureerde content, niet alleen platte rich text?
Zijn slugs, metadata en relaties eenvoudig te beheren?
Delivery
Biedt het een nette API of officiële SDK?
Kun je content efficiënt op slug bepalen?
Is de response-structuur voorspelbaar genoeg voor route-loaders?
React Router-fit
Werkt het goed met SSR?
Kunnen geheimen server-side blijven?
Is de integratie eenvoudig in route-loaders en routemodules?
Behoeften voor opschaling
Ondersteunt het lokalisatie?
Verwerkt het media netjes?
Helpt het met SEO-metadata en indexeringsresources?
Kan het meegroeien van een eenvoudige blog naar een groter contentsysteem?
Dat zijn de juiste vragen, of je nu Paragraph CMS of een ander headless CMS gebruikt.
Beveiligingsoverwegingen
Elke headless CMS-integratie moet beveiliging beschouwen als onderdeel van de architectuur.
Basis best practices zijn onder andere:
houd API-sleutels in omgevingsvariabelen
haal beschermde content waar mogelijk op de server op
voorkom dat geprivilegieerde credentials aan de browser worden blootgesteld
gebruik vertrouwde renderingaanpakken voor gestructureerde content
configureer CSP correct als je app dat gebruikt
De officiële beveiligingsgids van React Router legt specifiek nonce-afhandeling uit voor inline scripts in CSP-gebaseerde applicaties, en ServerRouter ondersteunt het doorgeven van een nonce voor CSP-compliance. Als je extra bescherming wilt tegen het per ongeluk client-bundelen van alleen-servercode, documenteert React Router ook .servermodules.
SEO-implicaties van het patroon
Een headless CMS creëert niet vanzelf SEO. Wat SEO helpt, is de combinatie van:
stabiele URL-architectuur
server-gerenderde HTML
goede metadata-afhandeling
interne linking
gestructureerde contentmodellering
gegenereerde crawl-resources waar nodig
Dat is nog een reden waarom React Router hier goed werkt: de frontend beheert URL's, rendering en metadatastrategie, terwijl het CMS de broncontent beheert.
Een betere benadering voor dit onderwerp
De beste redactionele benadering is eenvoudig:
Dit is een artikel over het React Router headless CMS-patroon, met één CMS als implementatievoorbeeld.
Dat is beter dan van de pagina een productpitch maken, omdat ontwikkelaars die op deze term zoeken meestal willen begrijpen:
hoe loaders werken
hoe SSR past in het geheel
hoe slug-gebaseerde routes content ophalen
hoe gestructureerde content wordt gerenderd
hoe je contentbeheer scheidt van frontend-applicatielogica
Praktische conclusie
Als je de kortste juiste samenvatting wilt, is het dit:
React Router werkt goed met een headless CMS omdat het route-niveau serverloading, SSR-ondersteuning, beveiligingsprimitieven voor echte applicaties en volledige controle over hoe content wordt gerenderd biedt. Een CMS wordt vervolgens de contentbackend achter die applicatielaag.
Dat is de kern van het patroon.
Wat betekent “React Router headless CMS” in de praktijk?
Het betekent dat React Router routes, loaders, SSR en UI-rendering afhandelt, terwijl een headless CMS content opslaat en levert via een API of SDK.
Waarom past React Router goed bij een headless CMS?
Omdat het routegebaseerd dataladen, ondersteuning voor serverrendering, controle over URL-structuur en een heldere grens tussen content ophalen en UI-rendering biedt.
Heb ik SSR nodig voor een React Router headless CMS-opzet?
Niet altijd, maar SSR is vaak de beste keuze omdat credentials op de server blijven, content wordt bepaald voordat HTML wordt verzonden en SEO-use-cases met veel content natuurlijker worden ondersteund.
Wat is het gebruikelijke routepatroon voor CMS-content?
Het meest voorkomende startpunt is één overzichtsroute zoals /blog en één detailroute zoals /blog/:slug. De loader leest de slug en haalt het bijpassende CMS-item op.
Kan dit patroon werken met andere CMS-platforms dan Paragraph CMS?
Ja. De architectuur is leveranciersagnostisch. Elk CMS met een bruikbare API of SDK, slug-ondersteuning en levering van gestructureerde content past meestal in hetzelfde React Router-patroon.
Wat moet ik beoordelen bij het kiezen van een CMS voor React Router?
Richt je op API-kwaliteit, SSR-compatibiliteit, ondersteuning voor gestructureerde content, slug-resolutie, mediaverwerking, lokalisatie, metadata-ondersteuning en hoe netjes het contentmodel aansluit op je routestructuur.