React Router Headless CMS : comment ça fonctionne
Découvrez comment React Router et un CMS headless fonctionnent ensemble pour un SSR favorable au SEO, des chargeurs de routes et une diffusion de contenu structurée.
 Grzegorz
Quand les gens recherchent React Router headless CMS, ils ne cherchent généralement pas un seul fournisseur. Ils veulent comprendre une architecture frontend : React Router gère les routes, les loaders, le rendu serveur et la composition de l’interface, tandis qu’un CMS headless stocke et fournit du contenu structuré via une API ou un SDK. React Router documente explicitement ServerRouter, Scripts et les consignes de sécurité pour les applications SSR, c’est pourquoi il correspond bien à ce modèle.
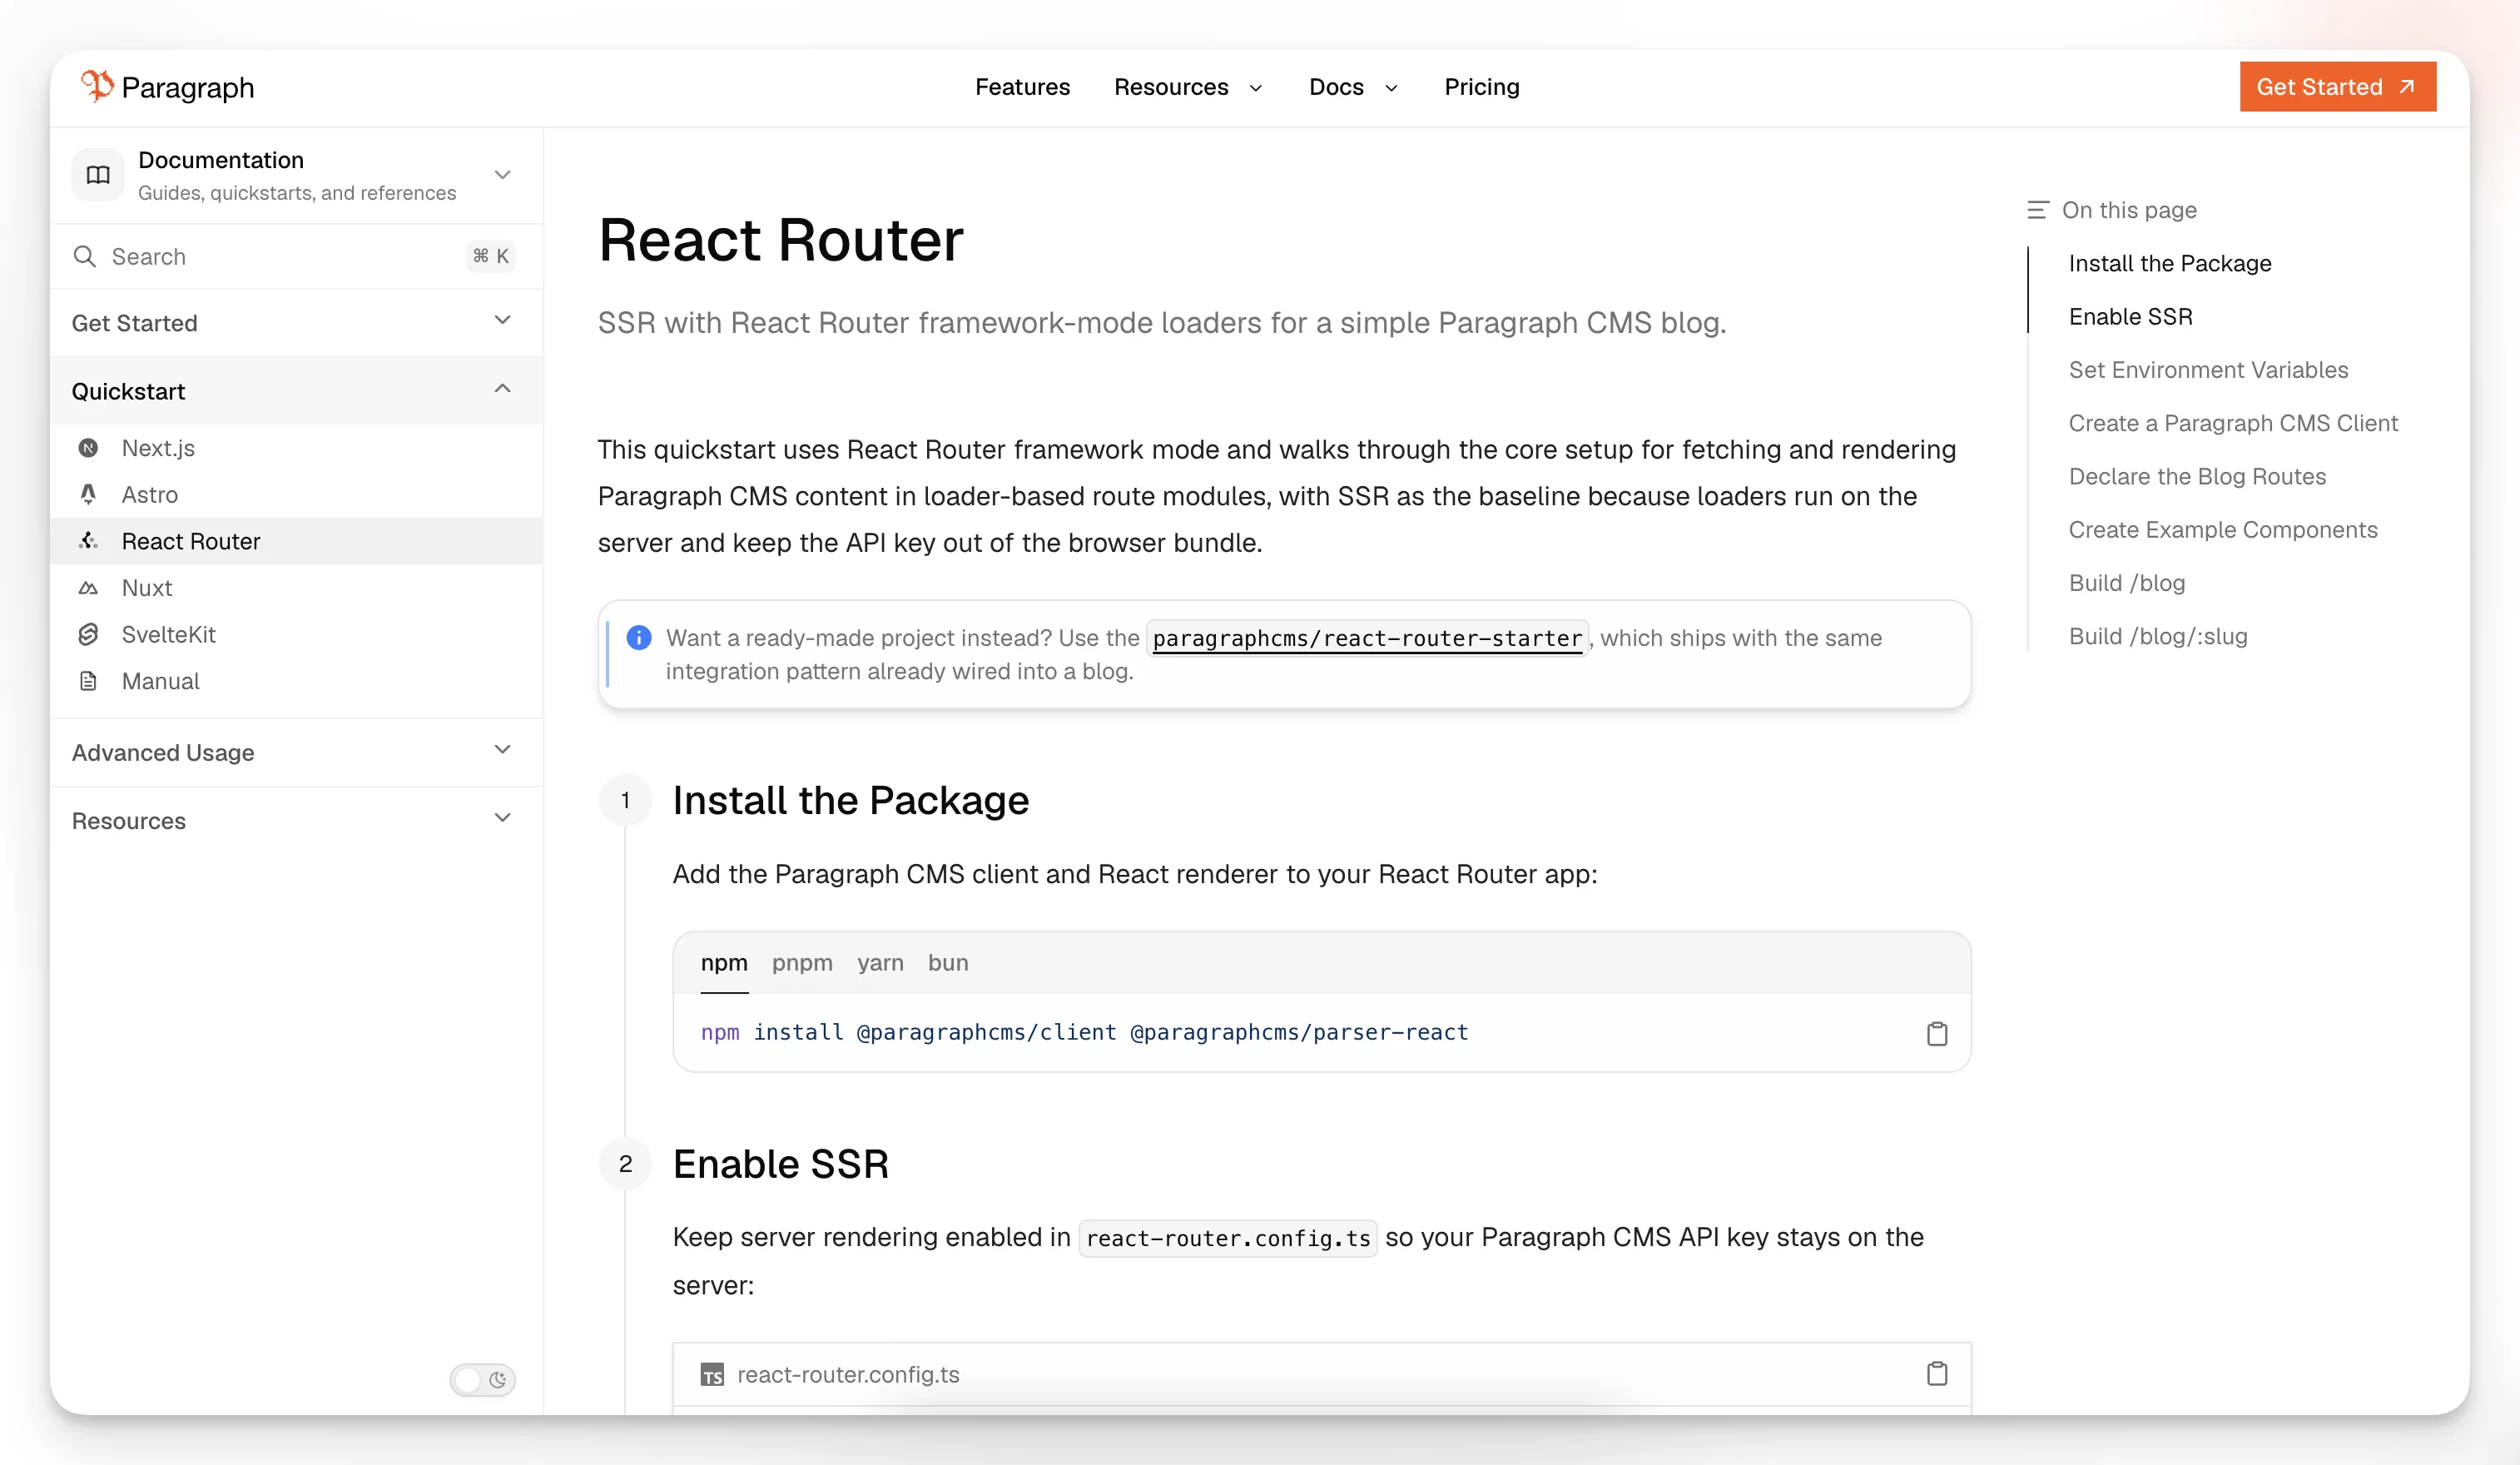
Cet article explique ce modèle de manière claire et indépendante du CMS. Pour rendre les concepts concrets, il utilise Paragraph CMS comme exemple, car le fournisseur documente publiquement la prise en charge de React Router, des projets de démarrage et des exemples plus avancés sur son site officiel et dans son journal des modifications.
TL;DR: Dans une configuration React Router headless CMS, React Router possède la couche application et le CMS possède la couche contenu. La partie importante est l’architecture, pas la marque du CMS.
Ce que signifie « React Router headless CMS »
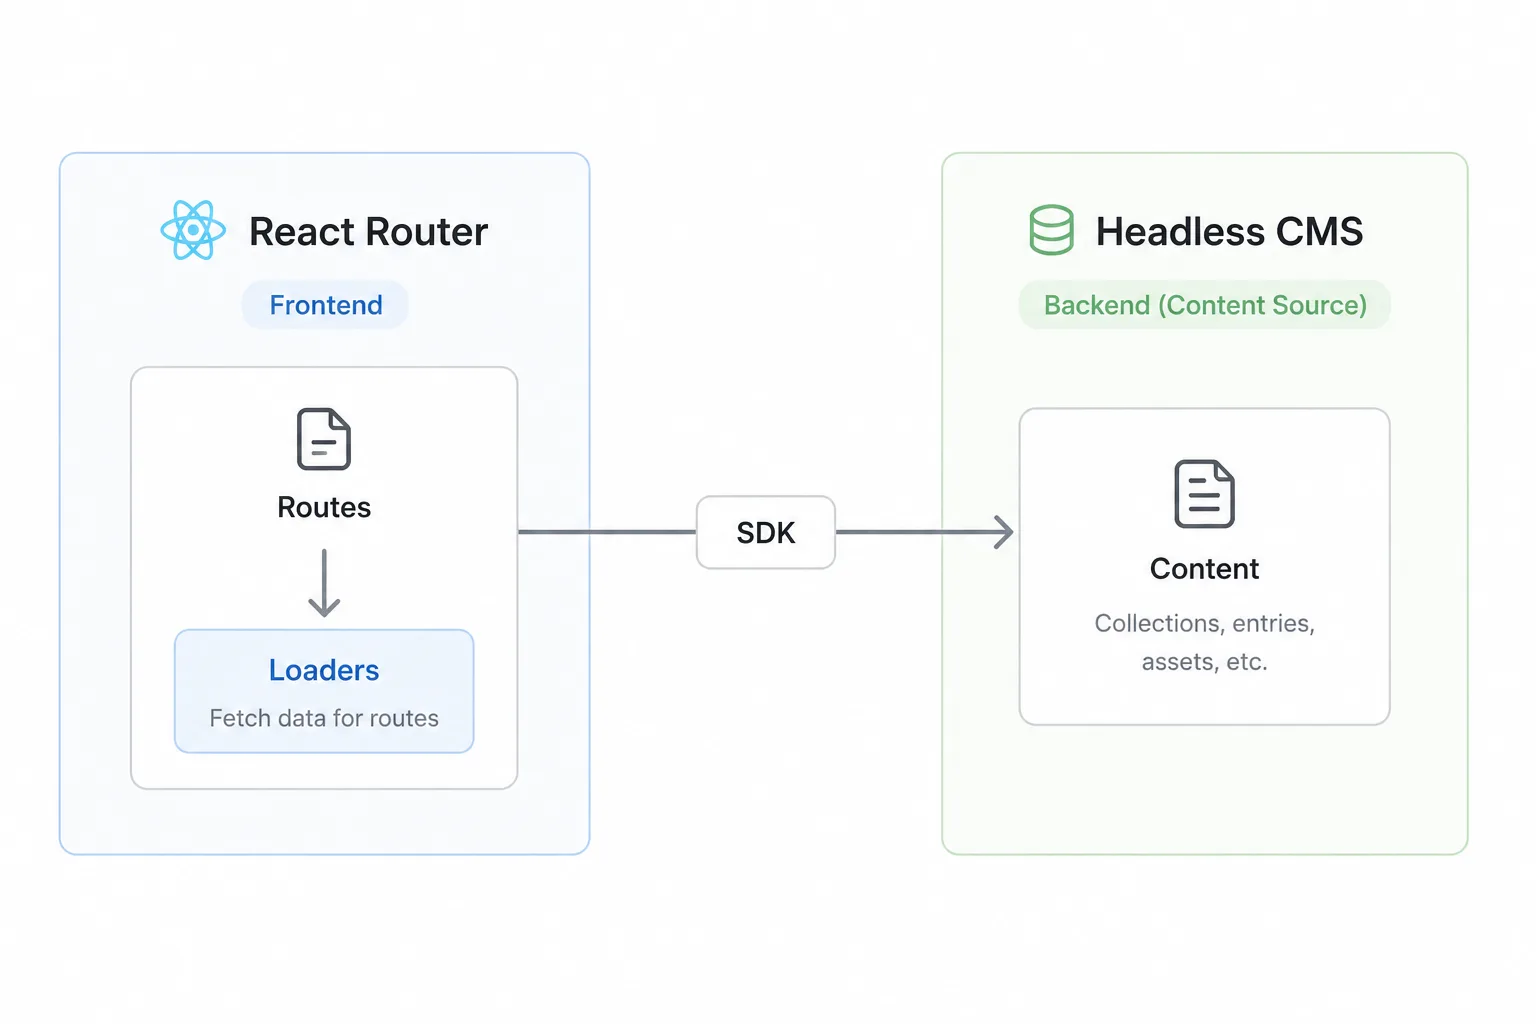
Un CMS headless gère le contenu sans contrôler votre couche de présentation frontend. Votre application React Router devient le système qui décide :
quelles URL existent
quelles données chaque route charge
comment le contenu est rendu
comment les mises en page, la navigation et le comportement de l’interface fonctionnent
En pratique, cela signifie généralement :
le CMS stocke les pages, entrées, slugs, métadonnées et contenus riches
React Router définit l’arborescence des routes
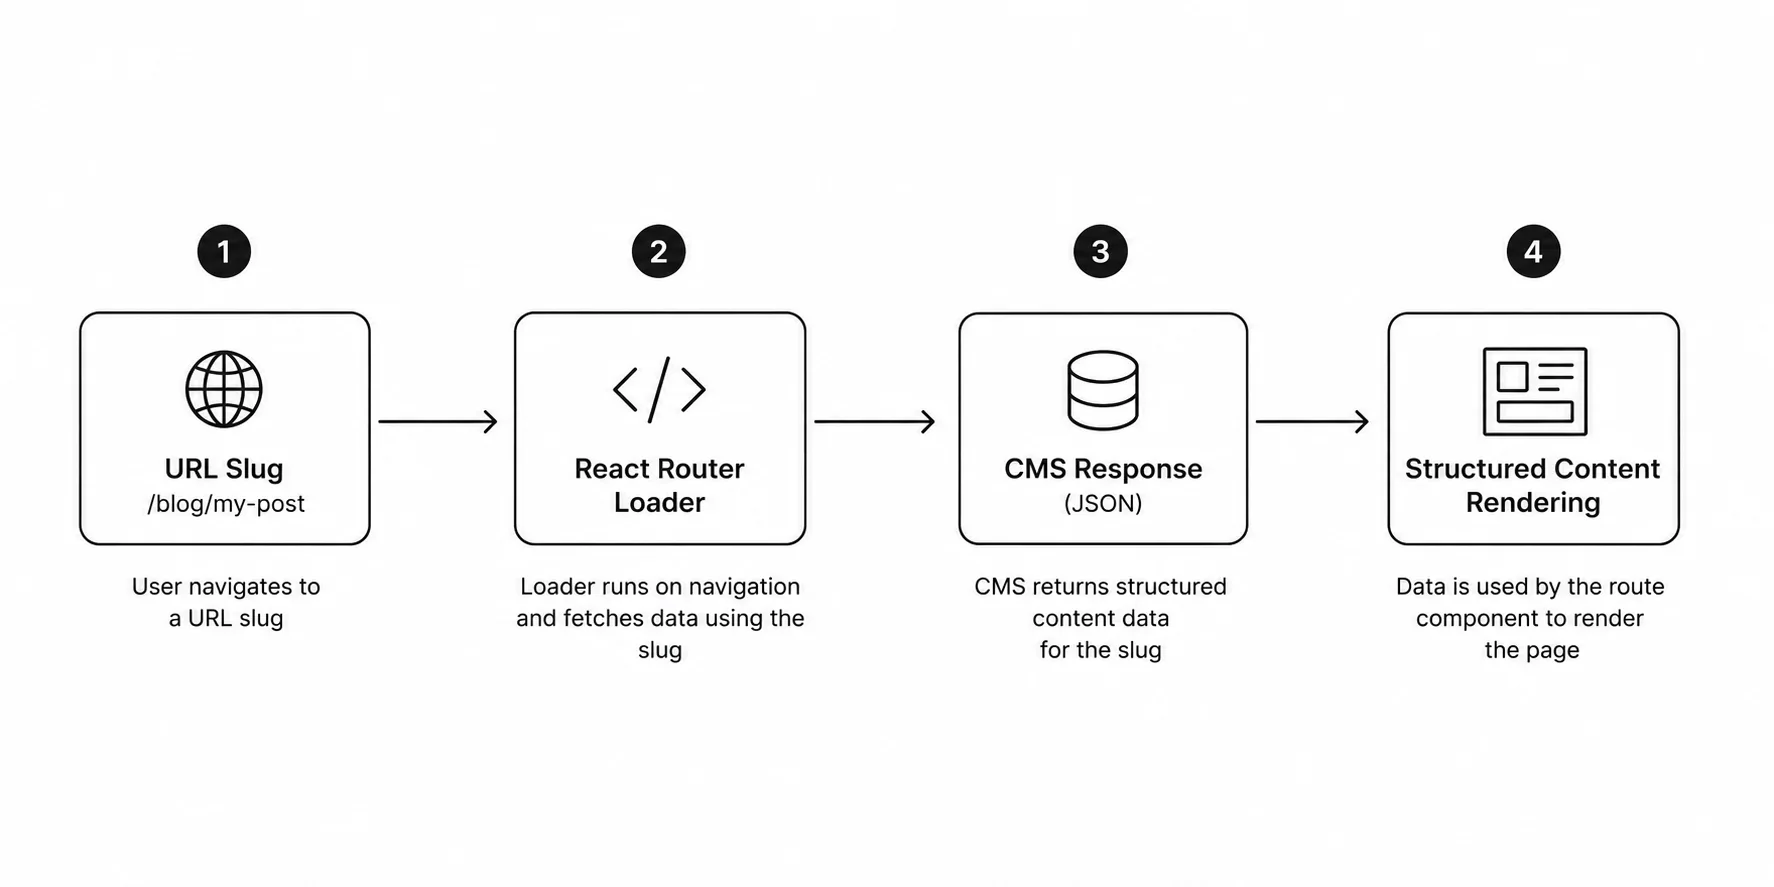
les loaders récupèrent le contenu sur le serveur
les modules de route renvoient les données aux composants
les composants React rendent le contenu structuré dans l’interface finale
Cette répartition des responsabilités est l’idée centrale derrière l’expression React Router headless CMS.
Pourquoi React Router est particulièrement adapté aux projets CMS headless
React Router convient très bien à la diffusion de contenu via un CMS headless, car il prend en charge les applications rendues côté serveur en Framework Mode, y compris un point d’entrée ServerRouter dédié et la gestion intégrée des scripts du document via Scripts. Sa documentation de sécurité couvre également la gestion des nonce CSP pour les applications rendues côté serveur.
Pour les applications pilotées par le contenu, cela compte parce que les équipes ont généralement besoin de :
résolution des pages basée sur l’URL
chargement des données côté serveur
diffusion de HTML favorable au SEO
gestion sécurisée des identifiants API
contrôle de la récupération au niveau des routes
liberté totale sur la couche composants
Ces besoins correspondent naturellement à l’architecture orientée loaders de React Router. Si vous créez un blog, un site de documentation, un site marketing, une base de connaissances ou une plateforme éditoriale, le framework vous fournit déjà la plupart des briques nécessaires. Vous pouvez aussi consulter le guide officiel des stratégies de rendu et la référence react-router.config.ts pour voir en quoi les modes SSR et SPA diffèrent.
L’architecture : framework d’abord, CMS ensuite
La manière la plus claire de penser à cette configuration est :
React Router est le framework applicatif.
Le CMS headless est le backend de contenu.
Un client API ou un SDK relie les deux.
Les loaders de route récupèrent les données pour une URL.
Les composants React décident comment le contenu est présenté.
Ce cadrage est important parce qu’il garde l’architecture frontend claire. Un CMS peut être remplacé plus facilement que votre modèle de routage, votre modèle de rendu et l’expérience utilisateur de l’application. L’intégration spécifique au fournisseur compte, mais elle doit venir après le modèle architectural.
À quoi ressemble généralement une stack React Router headless CMS
La plupart des implémentations aboutissent aux mêmes éléments de base :
une application React Router exécutée avec SSR
des variables d’environnement pour les identifiants du CMS
un client API partagé
une ou plusieurs routes de liste
une ou plusieurs routes dynamiques par slug
un moteur de rendu pour le contenu structuré
des utilitaires SEO optionnels pour sitemap, robots, flux et métadonnées
Cette structure dépasse le cadre d’un seul CMS. C’est simplement le modèle de diffusion normal pour du contenu headless dans une application React basée sur les routes.
Pourquoi le SSR est important dans ce modèle
Le rendu côté serveur fait généralement partie de l’architecture, pas seulement d’une optimisation de performance.
Avec le SSR :
les loaders peuvent récupérer les données du CMS sur le serveur
les clés API restent hors du bundle navigateur
les pages peuvent résoudre le contenu avant l’envoi du HTML
le contenu basé sur des slugs est plus facile à servir pour le SEO et les aperçus
le contenu structuré peut être rendu avec les données déjà disponibles
La documentation de React Router explicite ce modèle orienté serveur. ServerRouter est le point d’entrée serveur pour le Framework Mode, et le guide de sécurité explique comment fonctionne la gestion des nonce pour les scripts inline lorsque vous utilisez une CSP.
Une configuration minimale ressemble souvent à ceci :
import type { Config } from "@react-router/dev/config";export default { ssr: true,} satisfies Config;Si vous ne souhaitez pas de rendu serveur pour un projet donné, React Router documente également un mode SPA avecssr: false. Cela peut convenir à certaines applications de contenu, mais cela change la façon dont vous récupérez et protégez les données, c’est pourquoi le SSR reste l’option la plus courante pour la diffusion via un CMS headless.
Client partagé : une seule passerelle de contenu
Une bonne intégration centralise l’accès au CMS plutôt que de répéter la configuration API dans les fichiers de route.
Par exemple :
import { Client } from "@paragraphcms/client";const apiKey = process.env.PARAGRAPH_API_KEY;if (!apiKey) { throw new Error("PARAGRAPH_API_KEY environment variable is not set");}export const client = new Client({ apiKey });Ce modèle est utile quel que soit le CMS que vous choisissez. La leçon importante est architecturale :
centraliser la configuration API
garder les secrets côté serveur
faire dépendre les loaders d’une frontière d’intégration partagée
éviter de dupliquer la logique d’accès au contenu
Paragraph CMS se présente publiquement comme un CMS headless orienté API avec des SDK officiels et des quickstarts de framework sur son site, c’est pourquoi il fonctionne bien ici comme exemple concret.
La structure de routes avec laquelle la plupart des équipes commencent
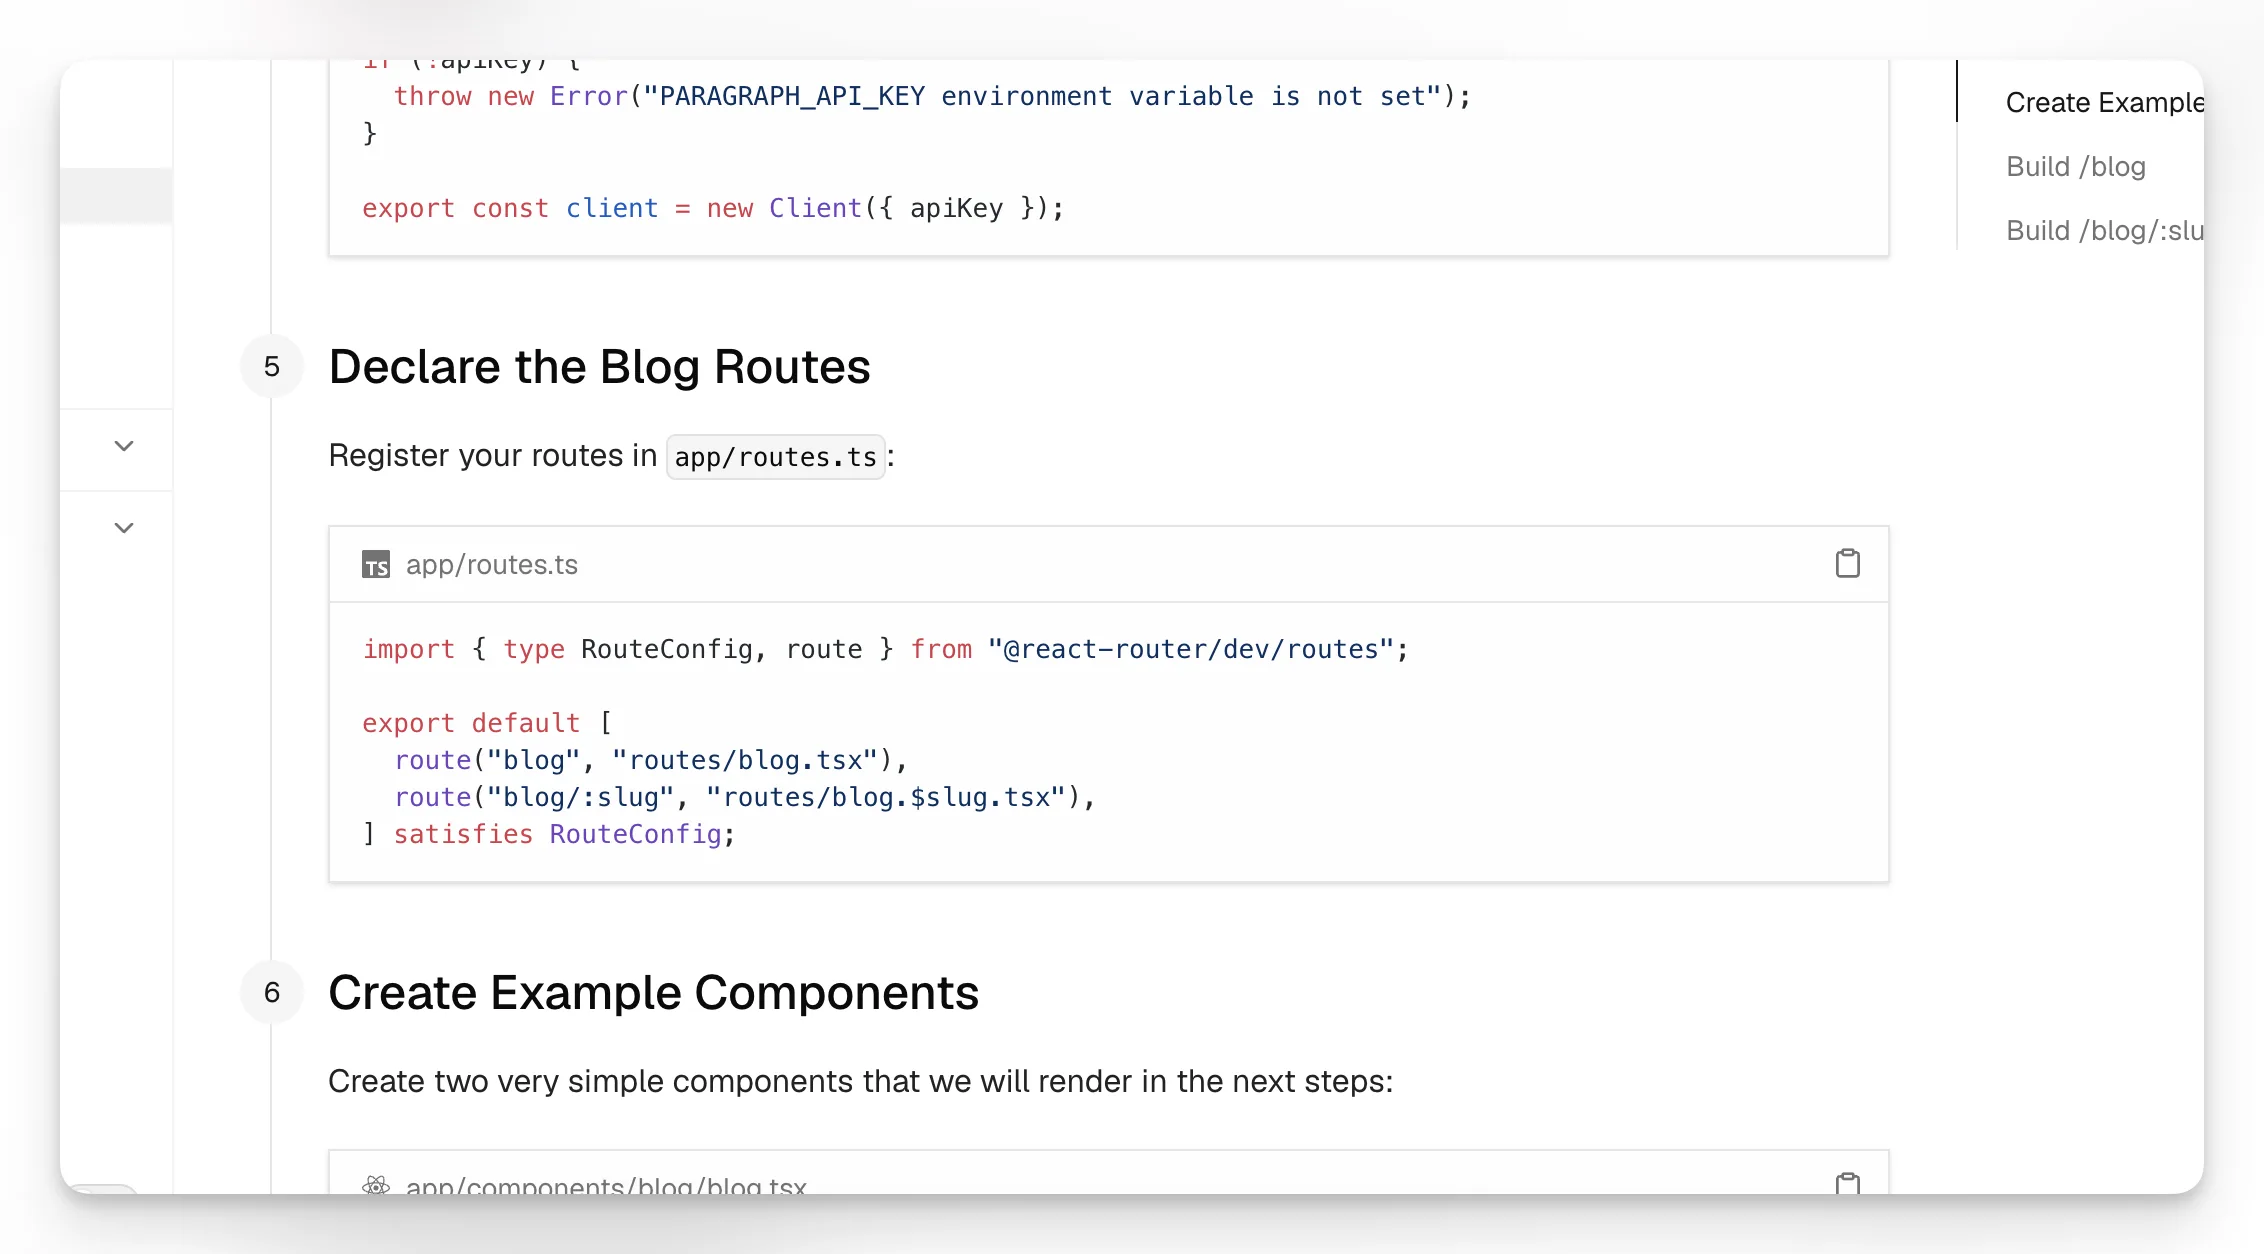
Un site de contenu simple commence souvent avec seulement deux routes :
une route de liste telle que
/blogune route de détail dynamique telle que
/blog/:slug
Exemple de configuration de routes :
import { type RouteConfig, route } from "@react-router/dev/routes";export default [ route("blog", "routes/blog.tsx"), route("blog/:slug", "routes/blog.$slug.tsx"),] satisfies RouteConfig;C’est le modèle standard orienté slug pour les sites de contenu. React Router maîtrise la forme des URL, et le loader associe cette URL à un enregistrement du CMS.
Le journal des modifications officiel de Paragraph CMS indique que son starter React Router a été publié le 5 juin 2026 avec des routes /blog et /blog/[slug] fonctionnelles, et que son exemple React Router avancé a été publié le 8 juin 2026 avec un routage sensible à la locale et des ressources générées telles que le sitemap et le RSS.
Comment fonctionne la route de liste
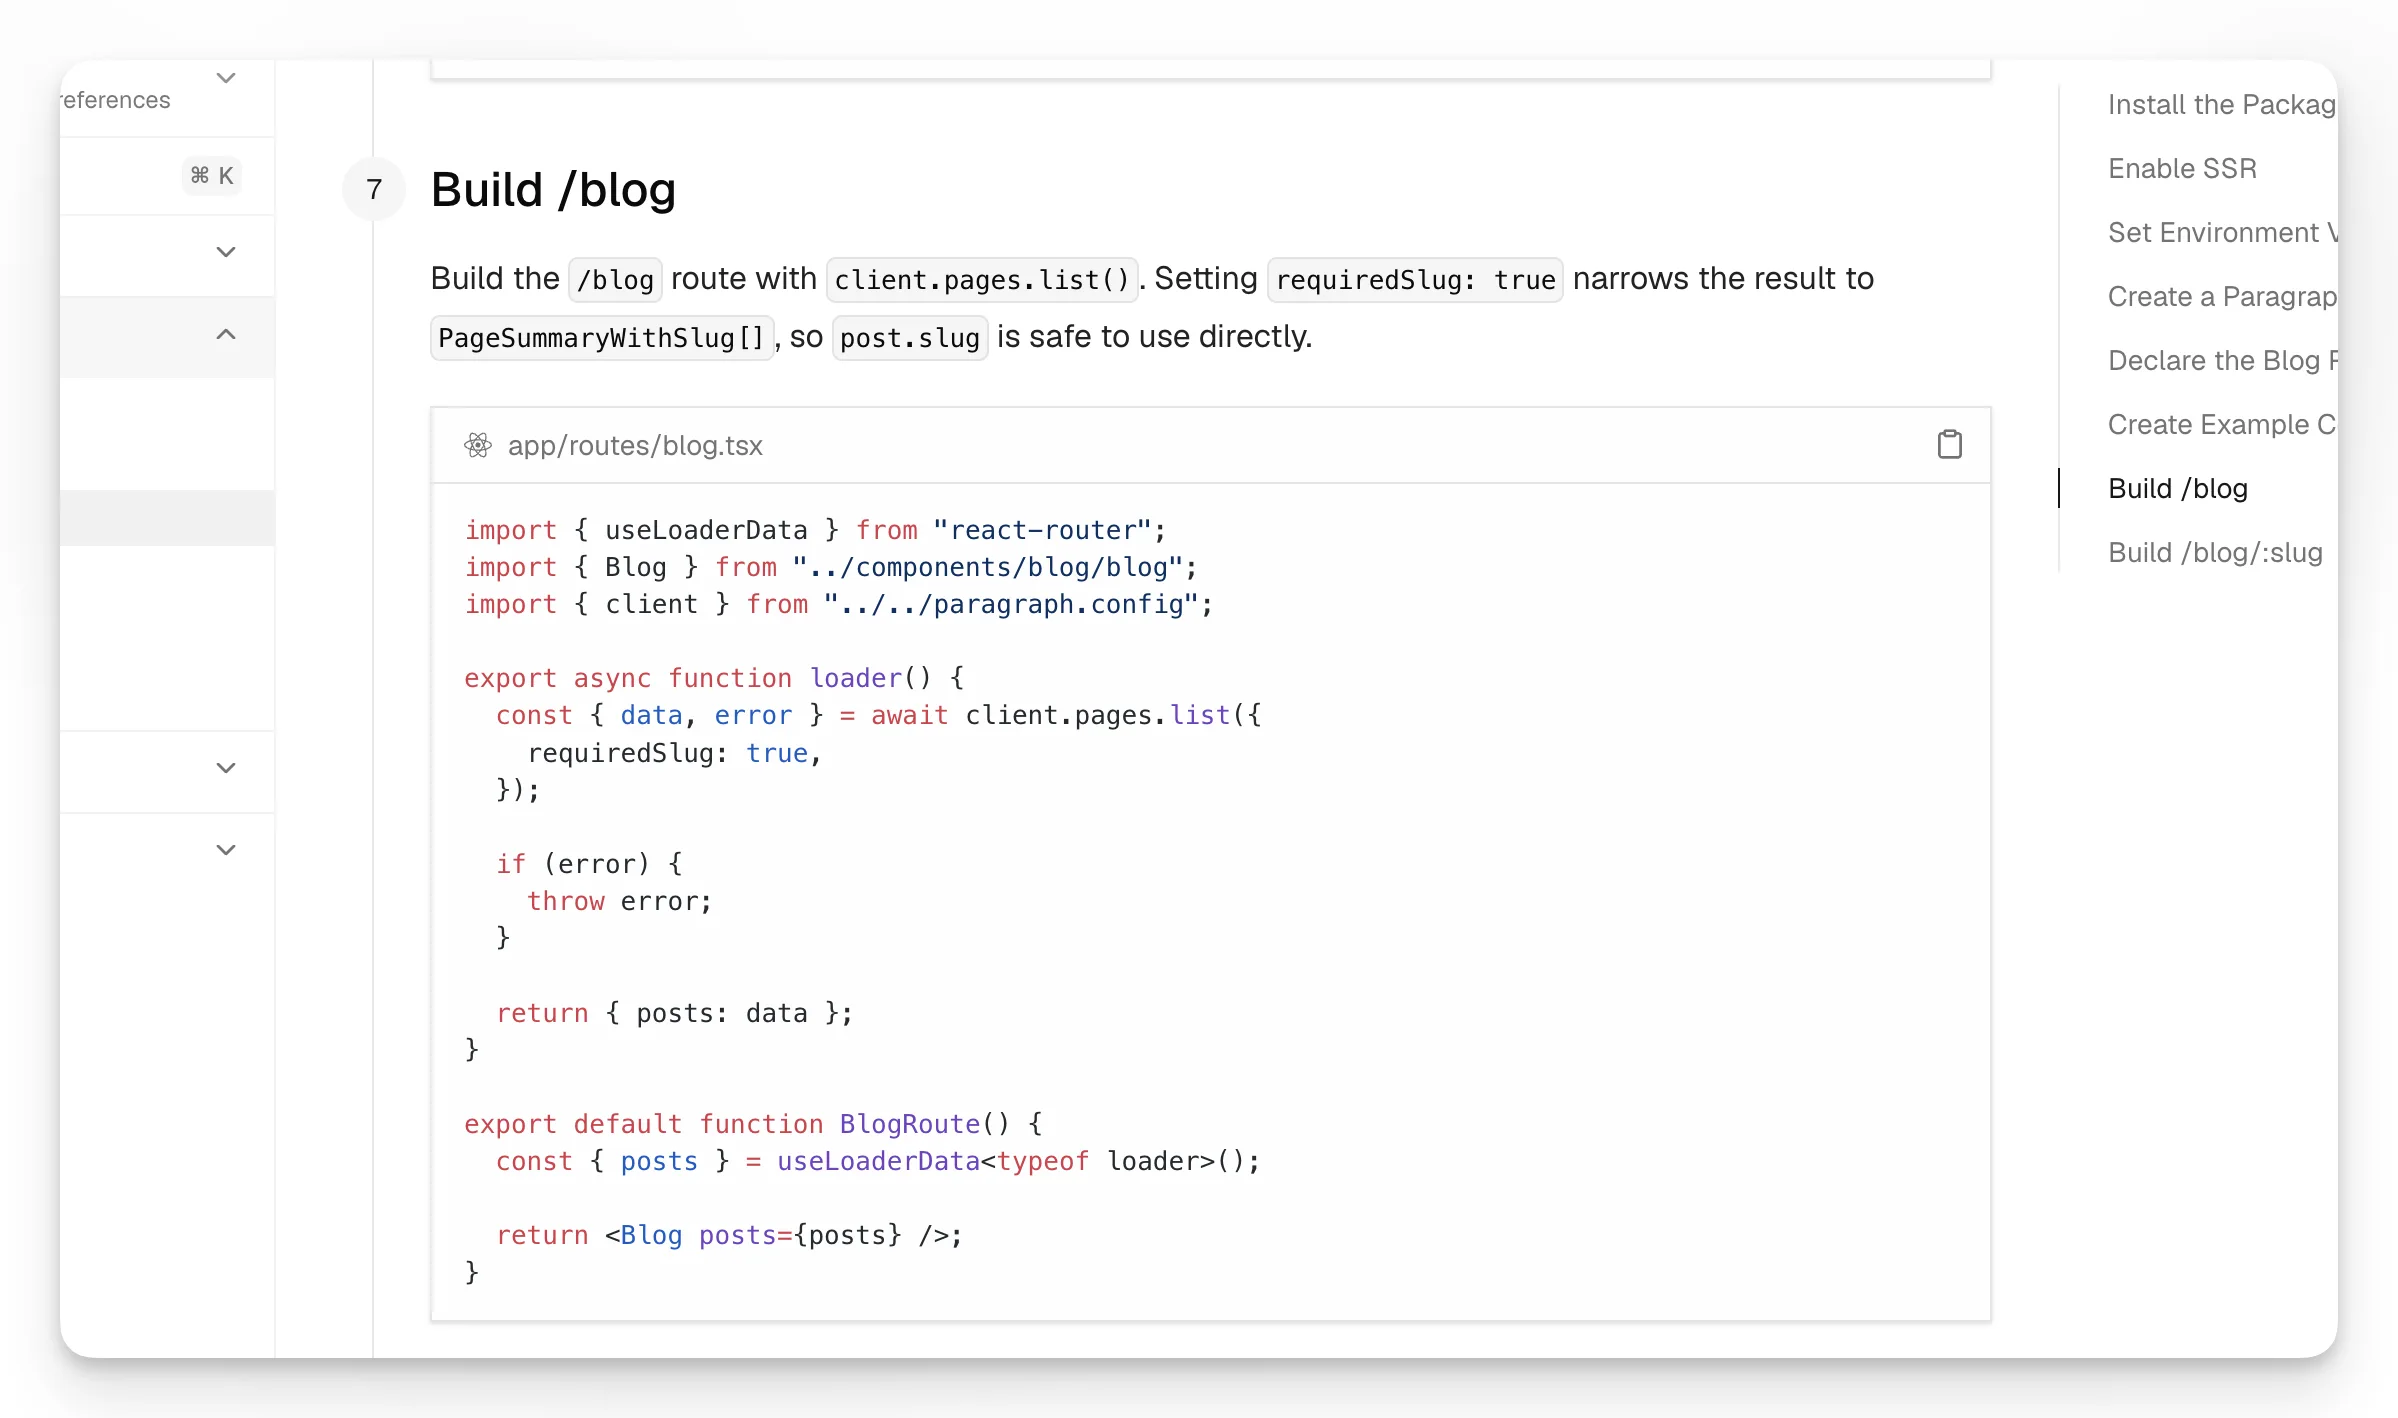
La route de liste récupère généralement des résumés de contenu et laisse la présentation à la couche composants.
Exemple :
import { useLoaderData } from "react-router";import { Blog } from "../components/blog/blog";import { client } from "../../paragraph.config";export async function loader() { const { data, error } = await client.pages.list({ requiredSlug: true, }); if (error) { throw error; } return { posts: data };}export default function BlogRoute() { const { posts } = useLoaderData<typeof loader>(); return <Blog posts={posts} />;}Cette séparation des responsabilités est l’idée principale :
le loader récupère le contenu
la route renvoie des données spécifiques à la route
le composant d’interface les rend
Le journal des modifications de Paragraph CMS note que le 2 juin 2026, client.pages.list() a été simplifié pour les réponses non paginées afin que les développeurs puissent lire les résultats directement depuis data.
Comment fonctionne la route par slug
La route de détail représente le flux classique d’un CMS headless : lire le slug de l’URL, récupérer l’enregistrement correspondant et l’afficher.
Exemple :
import { useLoaderData } from "react-router";import type { Route } from "./+types/blog.$slug";import { Post } from "../components/blog/post";import { client } from "../../paragraph.config";export async function loader({ params }: Route.LoaderArgs) { const { data, error } = await client.page.getBySlug(params.slug!); if (error) { throw error; } return { data };}export default function BlogPostRoute() { const { data } = useLoaderData<typeof loader>(); return <Post page={data} />;}Ce modèle se généralise bien à :
articles de blog
landing pages
pages de documentation
entrées de journal des modifications
articles de base de connaissances
études de cas
contenu localisé
Le fournisseur peut changer, mais le modèle de route, lui, ne change généralement pas.
React Router documente également la sécurité de typage des modules de route, ce qui est utile lorsque vos routes par slug deviennent plus complexes et nécessitent un typage prévisible des loaders et des params.
Rendu du contenu structuré dans React
Un vrai CMS headless renvoie généralement du contenu structuré, pas seulement des chaînes brutes. Ce contenu doit être rendu via un moteur fiable qui comprend le modèle de données du CMS.
Exemple :
import type { PageWithSlug } from "@paragraphcms/client";import { ParagraphContent } from "@paragraphcms/parser-react";export function Post({ page }: { page: PageWithSlug }) { return ( <main> <h1>{page.title}</h1> <ParagraphContent content={page.content} /> </main> );}La leçon transférable est :
stocker du contenu structuré dans le CMS
récupérer ce contenu structuré dans les loaders
le rendre via des composants React ou un moteur officiel
éviter d’aplatir tout en HTML non sûr quand ce n’est pas nécessaire
La couche interface reste simple
L’un des meilleurs aspects d’une intégration propre de CMS headless est que l’interface devient souvent très simple, dans le bon sens du terme.
Exemple de composant de liste :
import type { PageSummaryWithSlug } from "@paragraphcms/client";import { Link } from "react-router";export function Blog({ posts }: { posts: PageSummaryWithSlug[] }) { return ( <main> <h1>Blog</h1> <ul> {posts.map((post) => ( <li key={post.id}> <Link to={`/blog/${post.slug}`}>{post.title}</Link> </li> ))} </ul> </main> );}Cela montre clairement la répartition :
le CMS fournit des données de contenu structuré
React Router fournit la navigation et les frontières de données des routes
votre application décide du design, de la mise en page, des états et de l’UX
Ce qui en fait un véritable workflow de CMS headless
Un projet n’est pas vraiment « headless » simplement parce qu’il appelle une API une fois. Il devient un workflow de CMS headless lorsque la séparation est cohérente :
les éditeurs travaillent dans le CMS
les développeurs possèdent le code frontend
l’application définit les routes
le contenu est fourni via une API ou un SDK
le rendu est géré dans l’application React
les changements éditoriaux et les changements frontend peuvent évoluer indépendamment
Paragraph CMS se présente publiquement comme un CMS headless avec clés API, SDK, contenu multilingue, gestion des médias, SEO de page et prise en charge de React Router sur son site, ce qui correspond bien à ce modèle à titre d’exemple.
Ce que cette configuration ne résout pas à elle seule
Une intégration de blog simple est un bon point de départ, mais elle ne résout pas automatiquement tout.
Vous devez encore concevoir :
la stratégie d’URL multilingue
les workflows d’aperçu et de brouillon
la taxonomie et le filtrage
l’invalidation du cache
l’indexation de recherche
la stratégie de métadonnées
le contrôle d’accès
la gouvernance d’entreprise
Le journal des modifications de Paragraph CMS montre comment un starter peut évoluer vers une configuration plus complète. Le 8 juin 2026, le fournisseur a publié des exemples avancés avec routage de blog sensible à la locale ainsi que des sitemap.xml, robots.txt, llms.txt et flux RSS générés. Le 25 mai 2026, il a également annoncé un package SEO pour générer ce type de ressources.
Comment évaluer n’importe quel CMS headless pour React Router
Si vous comparez des options de CMS pour une application React Router, posez des questions pratiques plutôt que des questions de marque.
Modélisation du contenu
Peut-il représenter clairement vos types de contenu ?
Prend-il en charge le contenu structuré, et pas seulement du rich text plat ?
Les slugs, métadonnées et relations sont-ils faciles à gérer ?
Diffusion
Fournit-il une API propre ou un SDK officiel ?
Pouvez-vous résoudre efficacement le contenu par slug ?
La structure des réponses est-elle suffisamment prévisible pour les loaders de route ?
Compatibilité avec React Router
Fonctionne-t-il bien avec le SSR ?
Les secrets peuvent-ils rester côté serveur ?
L’intégration est-elle simple dans les loaders et les modules de route ?
Besoins de mise à l’échelle
Prend-il en charge la localisation ?
Gère-t-il proprement les médias ?
Aide-t-il avec les métadonnées SEO et les ressources d’indexation ?
Peut-il évoluer d’un blog simple vers un système de contenu plus vaste ?
Ce sont les bonnes questions, que vous utilisiez Paragraph CMS ou un autre CMS headless.
Considérations de sécurité
Toute intégration de CMS headless doit traiter la sécurité comme une partie de l’architecture.
Les bonnes pratiques de base incluent :
conserver les clés API dans des variables d’environnement
récupérer le contenu protégé sur le serveur lorsque c’est possible
éviter d’exposer des identifiants privilégiés au navigateur
utiliser des approches de rendu fiables pour le contenu structuré
configurer correctement la CSP si votre application en utilise une
Le guide de sécurité officiel de React Router explique spécifiquement la gestion des nonce pour les scripts inline dans les applications basées sur une CSP, et ServerRouter prend en charge le passage d’un nonce pour la conformité CSP. Si vous voulez une protection supplémentaire contre l’inclusion accidentelle côté client de code réservé au serveur, React Router documente aussi les modules .server.
Implications SEO du modèle
Un CMS headless ne crée pas le SEO à lui seul. Ce qui aide le SEO, c’est la combinaison de :
une architecture d’URL stable
du HTML rendu côté serveur
une bonne gestion des métadonnées
un maillage interne
une modélisation de contenu structurée
des ressources d’exploration générées si nécessaire
C’est une autre raison pour laquelle React Router fonctionne bien ici : le frontend maîtrise les URL, le rendu et la stratégie de métadonnées, tandis que le CMS maîtrise le contenu source.
Une meilleure manière de cadrer ce sujet
Le meilleur cadrage éditorial est simple :
Ceci est un article sur le modèle React Router headless CMS, utilisant un CMS comme exemple d’implémentation.
C’est préférable à transformer la page en argumentaire produit, car les développeurs qui recherchent ce terme veulent généralement comprendre :
comment fonctionnent les loaders
comment le SSR s’intègre
comment les routes basées sur des slugs récupèrent le contenu
comment le contenu structuré est rendu
comment séparer la gestion de contenu de la logique applicative frontend
À retenir en pratique
Si vous voulez le résumé exact le plus court, c’est celui-ci :
React Router fonctionne bien avec un CMS headless parce qu’il vous offre un chargement serveur au niveau des routes, une prise en charge du SSR, des primitives de sécurité pour de vraies applications et un contrôle complet sur la manière dont le contenu est rendu. Un CMS devient alors le backend de contenu derrière cette couche applicative.
C’est le cœur du modèle.
Que signifie concrètement « React Router headless CMS » ?
Cela signifie que React Router gère les routes, les loaders, le SSR et le rendu de l’interface, tandis qu’un CMS headless stocke et fournit le contenu via une API ou un SDK.
Pourquoi React Router convient-il bien à un CMS headless ?
Parce qu’il vous offre un chargement de données basé sur les routes, la prise en charge du rendu serveur, le contrôle de la structure des URL et une séparation claire entre la récupération du contenu et le rendu de l’interface.
Ai-je besoin du SSR pour une configuration React Router headless CMS ?
Pas toujours, mais le SSR est souvent la meilleure option parce qu’il garde les identifiants sur le serveur, résout le contenu avant l’envoi du HTML et prend plus naturellement en charge les cas d’usage SEO riches en contenu.
Quel est le modèle de route habituel pour le contenu d’un CMS ?
Le point de départ le plus courant est une route de liste comme /blog et une route de détail comme /blog/:slug. Le loader lit le slug et récupère l’entrée correspondante dans le CMS.
Ce modèle peut-il fonctionner avec des plateformes CMS autres que Paragraph CMS ?
Oui. L’architecture est indépendante du fournisseur. Tout CMS disposant d’une API ou d’un SDK exploitable, de la prise en charge des slugs et de la diffusion de contenu structuré peut généralement s’intégrer au même modèle React Router.
Que dois-je évaluer lors du choix d’un CMS pour React Router ?
Concentrez-vous sur la qualité de l’API, la compatibilité SSR, la prise en charge du contenu structuré, la résolution par slug, la gestion des médias, la localisation, la prise en charge des métadonnées et la propreté avec laquelle le modèle de contenu s’aligne sur votre structure de routes.