React Router Headless CMS: Wie es funktioniert
Erfahren Sie, wie React Router und ein Headless CMS für SEO-freundliches SSR, Route-Loader und die strukturierte Bereitstellung von Inhalten zusammenarbeiten.
 Grzegorz
Wenn Menschen nach React Router headless CMS suchen, suchen sie in der Regel nicht nach einem einzelnen Anbieter. Sie möchten eine Frontend-Architektur verstehen: React Router übernimmt Routen, Loader, Server-Rendering und UI-Komposition, während ein Headless CMS strukturierte Inhalte über eine API oder ein SDK speichert und ausliefert. React Router dokumentiert ausdrücklich ServerRouter, Scripts und Sicherheitshinweise für SSR-Anwendungen, weshalb es gut zu diesem Muster passt.
Dieser Artikel erklärt dieses Muster auf eine saubere, CMS-agnostische Weise. Um die Konzepte greifbar zu machen, verwendet er Paragraph CMS als Beispiel, weil der Anbieter React-Router-Support, Starter-Projekte und fortgeschrittene Beispiele öffentlich auf seiner offiziellen Website und im Changelog dokumentiert.
TL;DR: In einem React-Router-Headless-CMS-Setup gehört die Anwendungsschicht React Router und die Inhaltsschicht dem CMS. Entscheidend ist die Architektur, nicht die CMS-Marke.
Was „React Router headless CMS“ bedeutet
Ein Headless CMS verwaltet Inhalte, ohne deine Frontend-Präsentationsschicht zu steuern. Deine React-Router-App wird zum System, das entscheidet:
welche URLs es gibt
welche Daten jede Route lädt
wie Inhalte gerendert werden
wie Layouts, Navigation und UI-Verhalten funktionieren
In der Praxis bedeutet das meist:
das CMS speichert Seiten, Einträge, Slugs, Metadaten und Rich Content
React Router definiert den Routenbaum
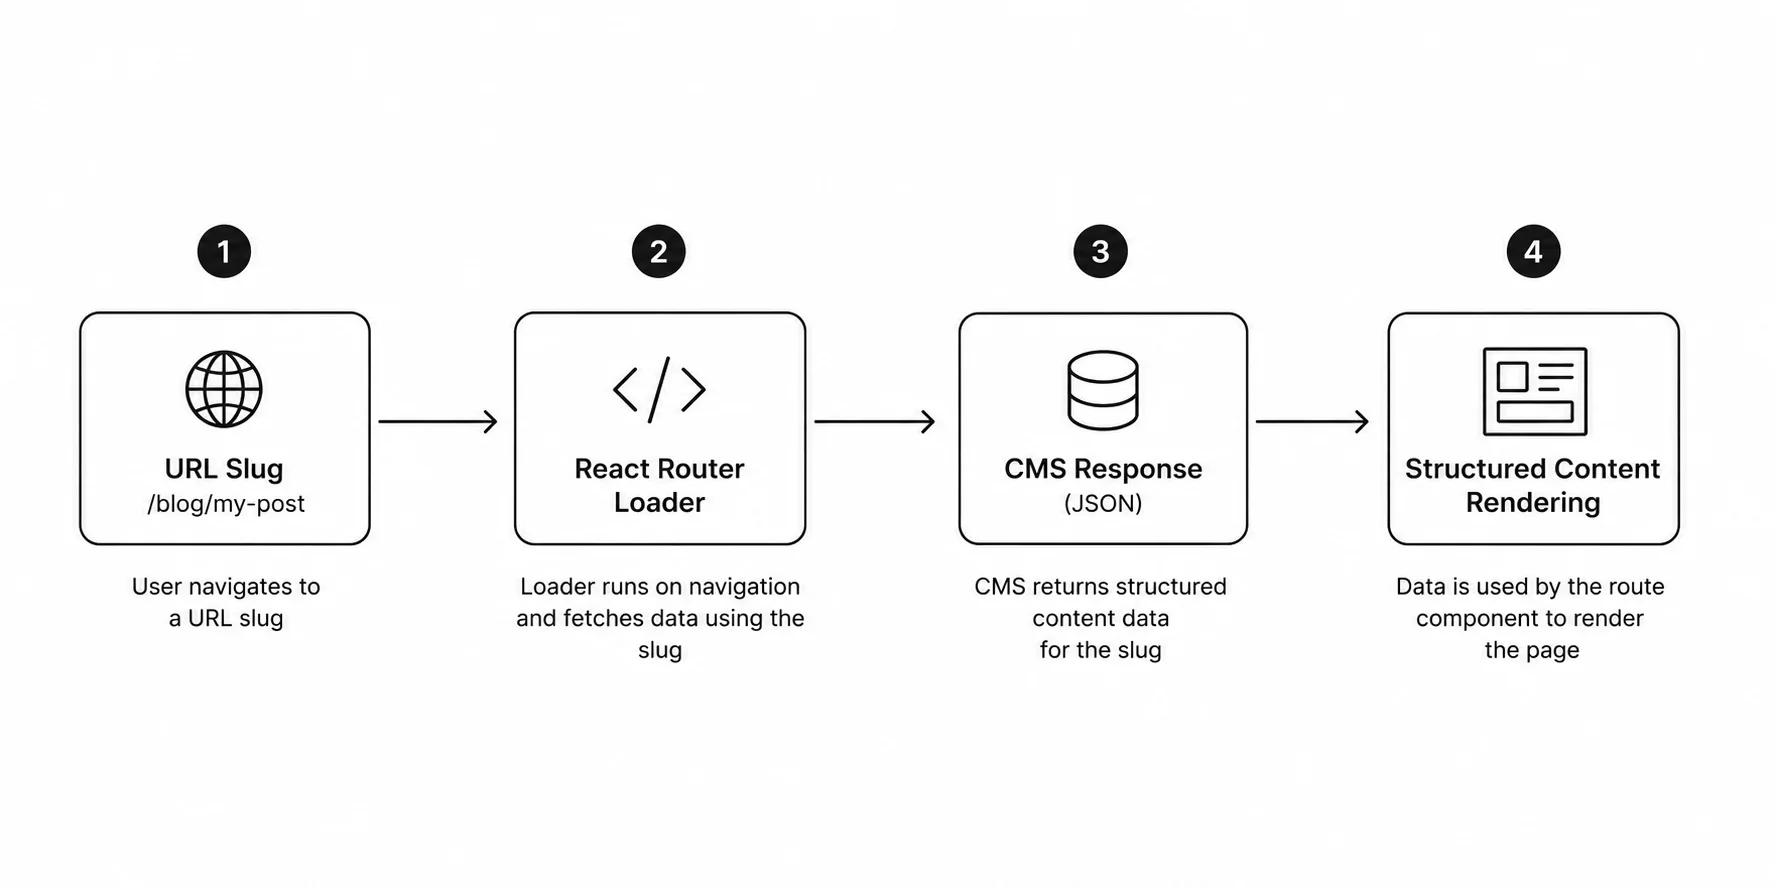
Loader rufen Inhalte auf dem Server ab
Routenmodule geben Daten an Komponenten zurück
React-Komponenten rendern strukturierte Inhalte in die finale UI
Diese Aufgabenteilung ist die Kernidee hinter dem Begriff React Router headless CMS.
Warum React Router gut für Headless-CMS-Projekte geeignet ist
React Router eignet sich gut für die Auslieferung mit einem Headless CMS, weil es servergerenderte Anwendungen im Framework Mode unterstützt, einschließlich eines dedizierten ServerRouter-Einstiegspunkts und integrierter Handhabung von Dokument-Skripten über Scripts. Seine Sicherheitsdokumentation behandelt außerdem die Handhabung von CSP-Nonces für servergerenderte Apps.
Für content-getriebene Anwendungen ist das wichtig, weil Teams in der Regel Folgendes brauchen:
URL-basierte Seitenauflösung
serverseitiges Laden von Daten
SEO-freundliche HTML-Auslieferung
sichere Handhabung von API-Zugangsdaten
Kontrolle des Abrufs auf Routenebene
vollständige Freiheit über die Komponentenebene
Diese Anforderungen passen ganz natürlich zu der loader-getriebenen Architektur von React Router. Wenn du einen Blog, eine Dokumentationsseite, eine Marketing-Website, eine Wissensdatenbank oder eine redaktionelle Plattform baust, liefert das Framework bereits die meisten Bausteine, die du brauchst. Du kannst dir auch den offiziellen Leitfaden zu Rendering-Strategien und die react-router.config.ts-Referenz ansehen, um zu verstehen, wie sich SSR- und SPA-Modi unterscheiden.
Die Architektur: zuerst das Framework, dann das CMS
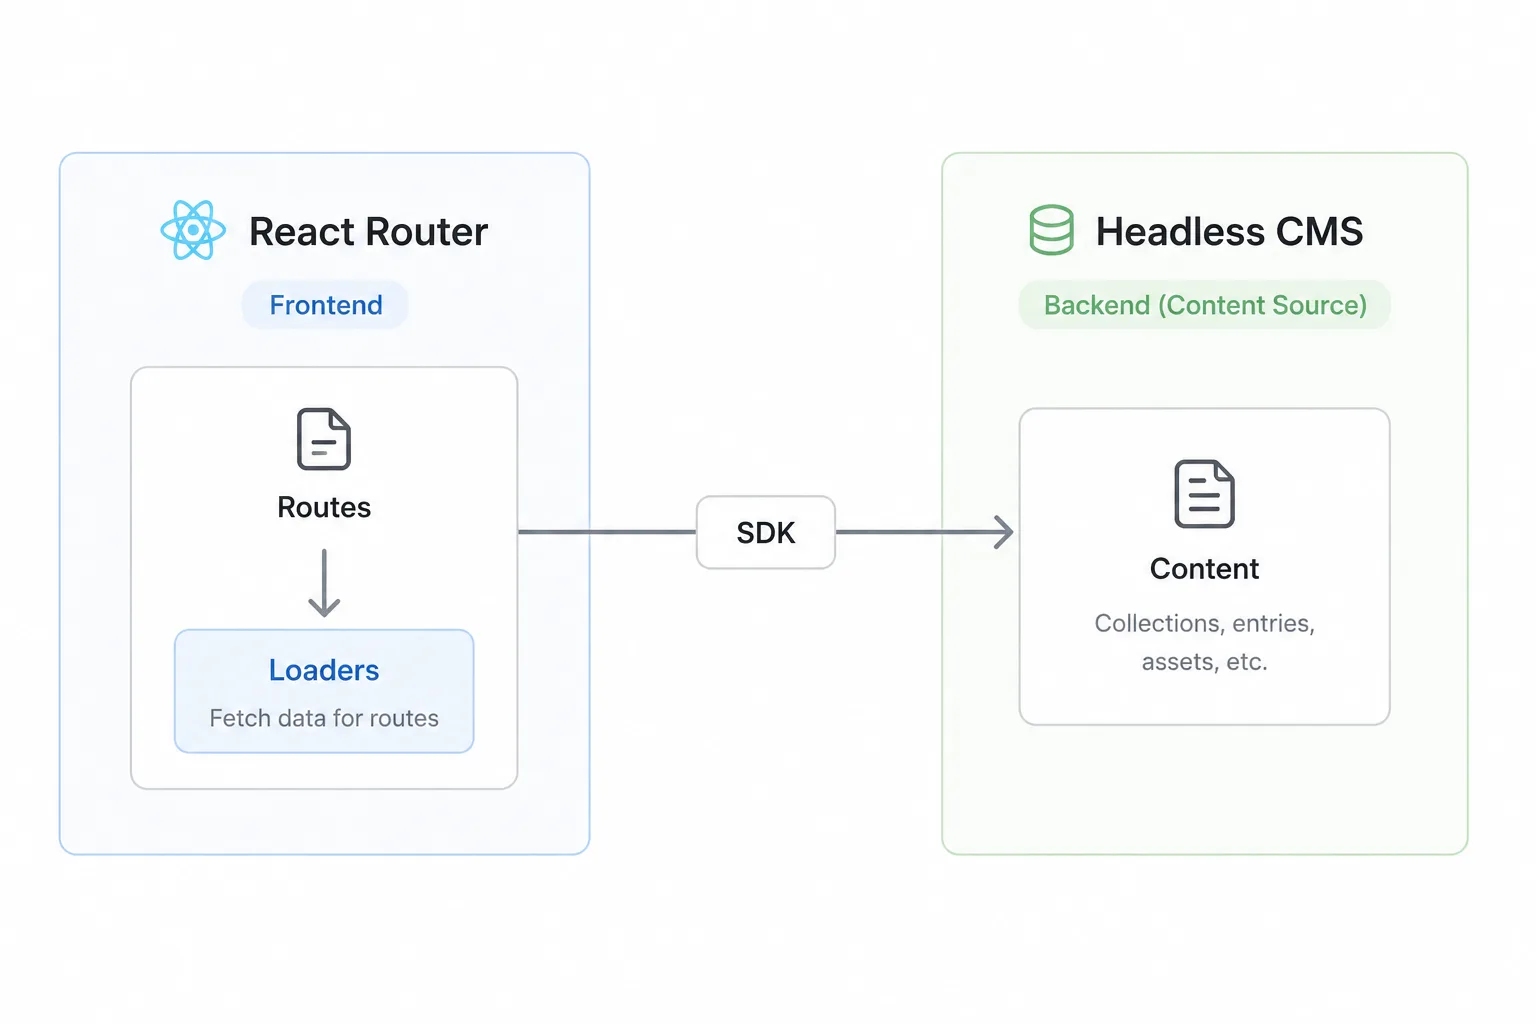
Am einfachsten lässt sich dieses Setup so verstehen:
React Router ist das Anwendungs-Framework.
Das Headless CMS ist das Content-Backend.
Ein API-Client oder SDK verbindet beides.
Routen-Loader laden die Daten für eine URL.
React-Komponenten entscheiden, wie die Inhalte präsentiert werden.
Diese Einordnung ist wichtig, weil sie die Frontend-Architektur klar hält. Ein CMS lässt sich leichter austauschen als dein Routing-Modell, Rendering-Modell und die UX deiner Anwendung. Die anbieterspezifische Integration ist wichtig, sollte aber nach dem Architektur-Muster kommen.
Wie ein typischer React-Router-Headless-CMS-Stack aussieht
Die meisten Implementierungen enden bei denselben Grundbausteinen:
eine React-Router-App mit SSR
Umgebungsvariablen für CMS-Zugangsdaten
ein gemeinsamer API-Client
eine oder mehrere Listenrouten
eine oder mehrere dynamische Slug-Routen
ein Renderer für strukturierte Inhalte
optionale SEO-Helfer für Sitemap, robots, Feeds und Metadaten
Diese Struktur ist breiter angelegt als jedes einzelne CMS. Sie ist schlicht das normale Auslieferungsmodell für Headless-Inhalte in einer routenbasierten React-App.
Warum SSR in diesem Muster wichtig ist
Server-Side Rendering ist in der Regel Teil der Architektur und nicht nur eine Performance-Optimierung.
Mit SSR:
können Loader CMS-Daten auf dem Server abrufen
bleiben API-Schlüssel aus dem Browser-Bundle heraus
können Seiten Inhalte auflösen, bevor HTML gesendet wird
lassen sich slug-basierte Inhalte leichter für SEO und Previews ausliefern
können strukturierte Inhalte gerendert werden, wenn die Daten bereits verfügbar sind
Die Dokumentation von React Router macht dieses serverorientierte Modell ausdrücklich deutlich. ServerRouter ist der Server-Einstiegspunkt für den Framework Mode, und der Sicherheitsleitfaden erklärt, wie die Nonce-Handhabung für Inline-Skripte funktioniert, wenn du CSP verwendest.
Eine minimale Konfiguration sieht oft so aus:
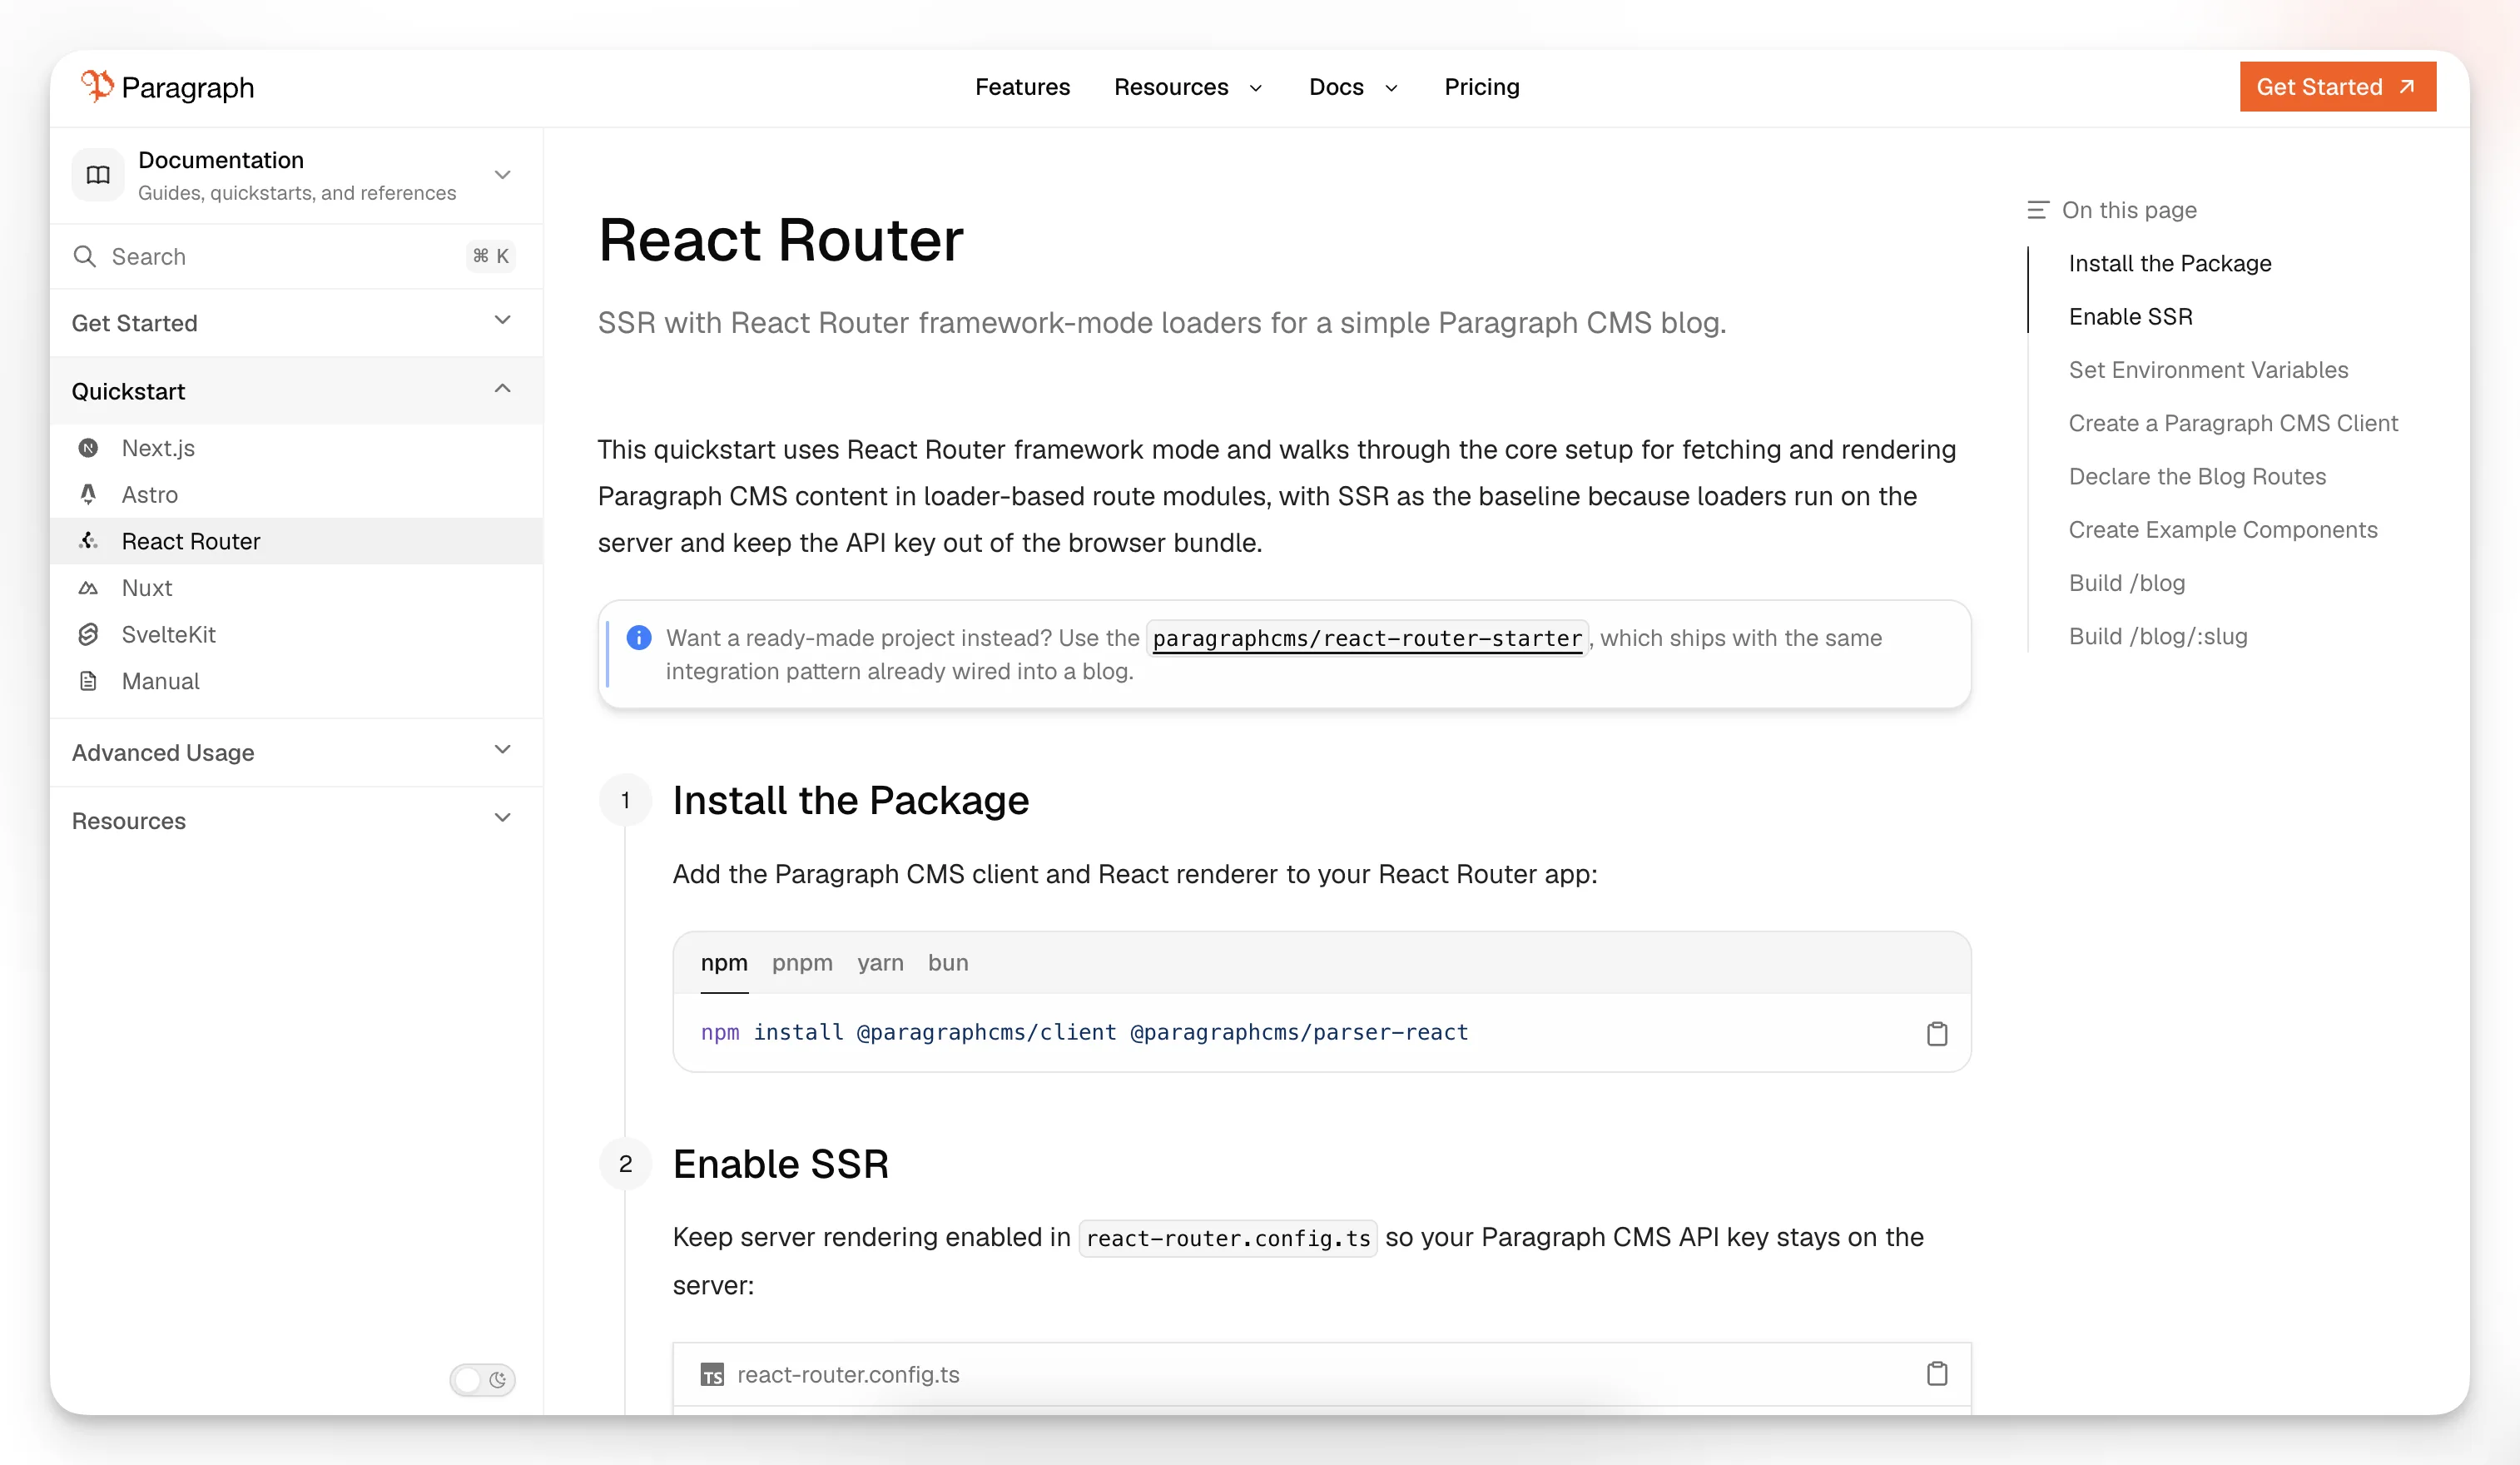
import type { Config } from "@react-router/dev/config";export default { ssr: true,} satisfies Config;Wenn du für ein bestimmtes Projekt kein Server-Rendering möchtest, dokumentiert React Router auch einen SPA-Modus mitssr: false. Das kann für manche Content-Anwendungen funktionieren, verändert aber, wie du Daten abrufst und schützt. Deshalb ist SSR für die Auslieferung mit einem Headless CMS weiterhin häufiger die passende Wahl.
Gemeinsamer Client: ein zentrales Content-Gateway
Eine gute Integration hält den CMS-Zugriff an einer Stelle, statt die API-Einrichtung in Routen-Dateien zu wiederholen.
Zum Beispiel:
import { Client } from "@paragraphcms/client";const apiKey = process.env.PARAGRAPH_API_KEY;if (!apiKey) { throw new Error("PARAGRAPH_API_KEY environment variable is not set");}export const client = new Client({ apiKey });Dieses Muster ist nützlich, unabhängig davon, welches CMS du wählst. Die wichtige architektonische Erkenntnis ist:
API-Konfiguration zentralisieren
Geheimnisse auf dem Server halten
Loader von einer gemeinsamen Integrationsgrenze abhängig machen
Duplizierung von Inhaltszugriffslogik vermeiden
Paragraph CMS positioniert sich öffentlich als API-first-Headless-CMS mit offiziellen SDKs und Framework-Quickstarts auf seiner Website, weshalb es sich hier als konkretes Beispiel eignet.
Die Routenstruktur, mit der die meisten Teams starten
Eine einfache Content-Seite beginnt oft mit nur zwei Routen:
eine Listenroute wie
/blogeine dynamische Detailroute wie
/blog/:slug
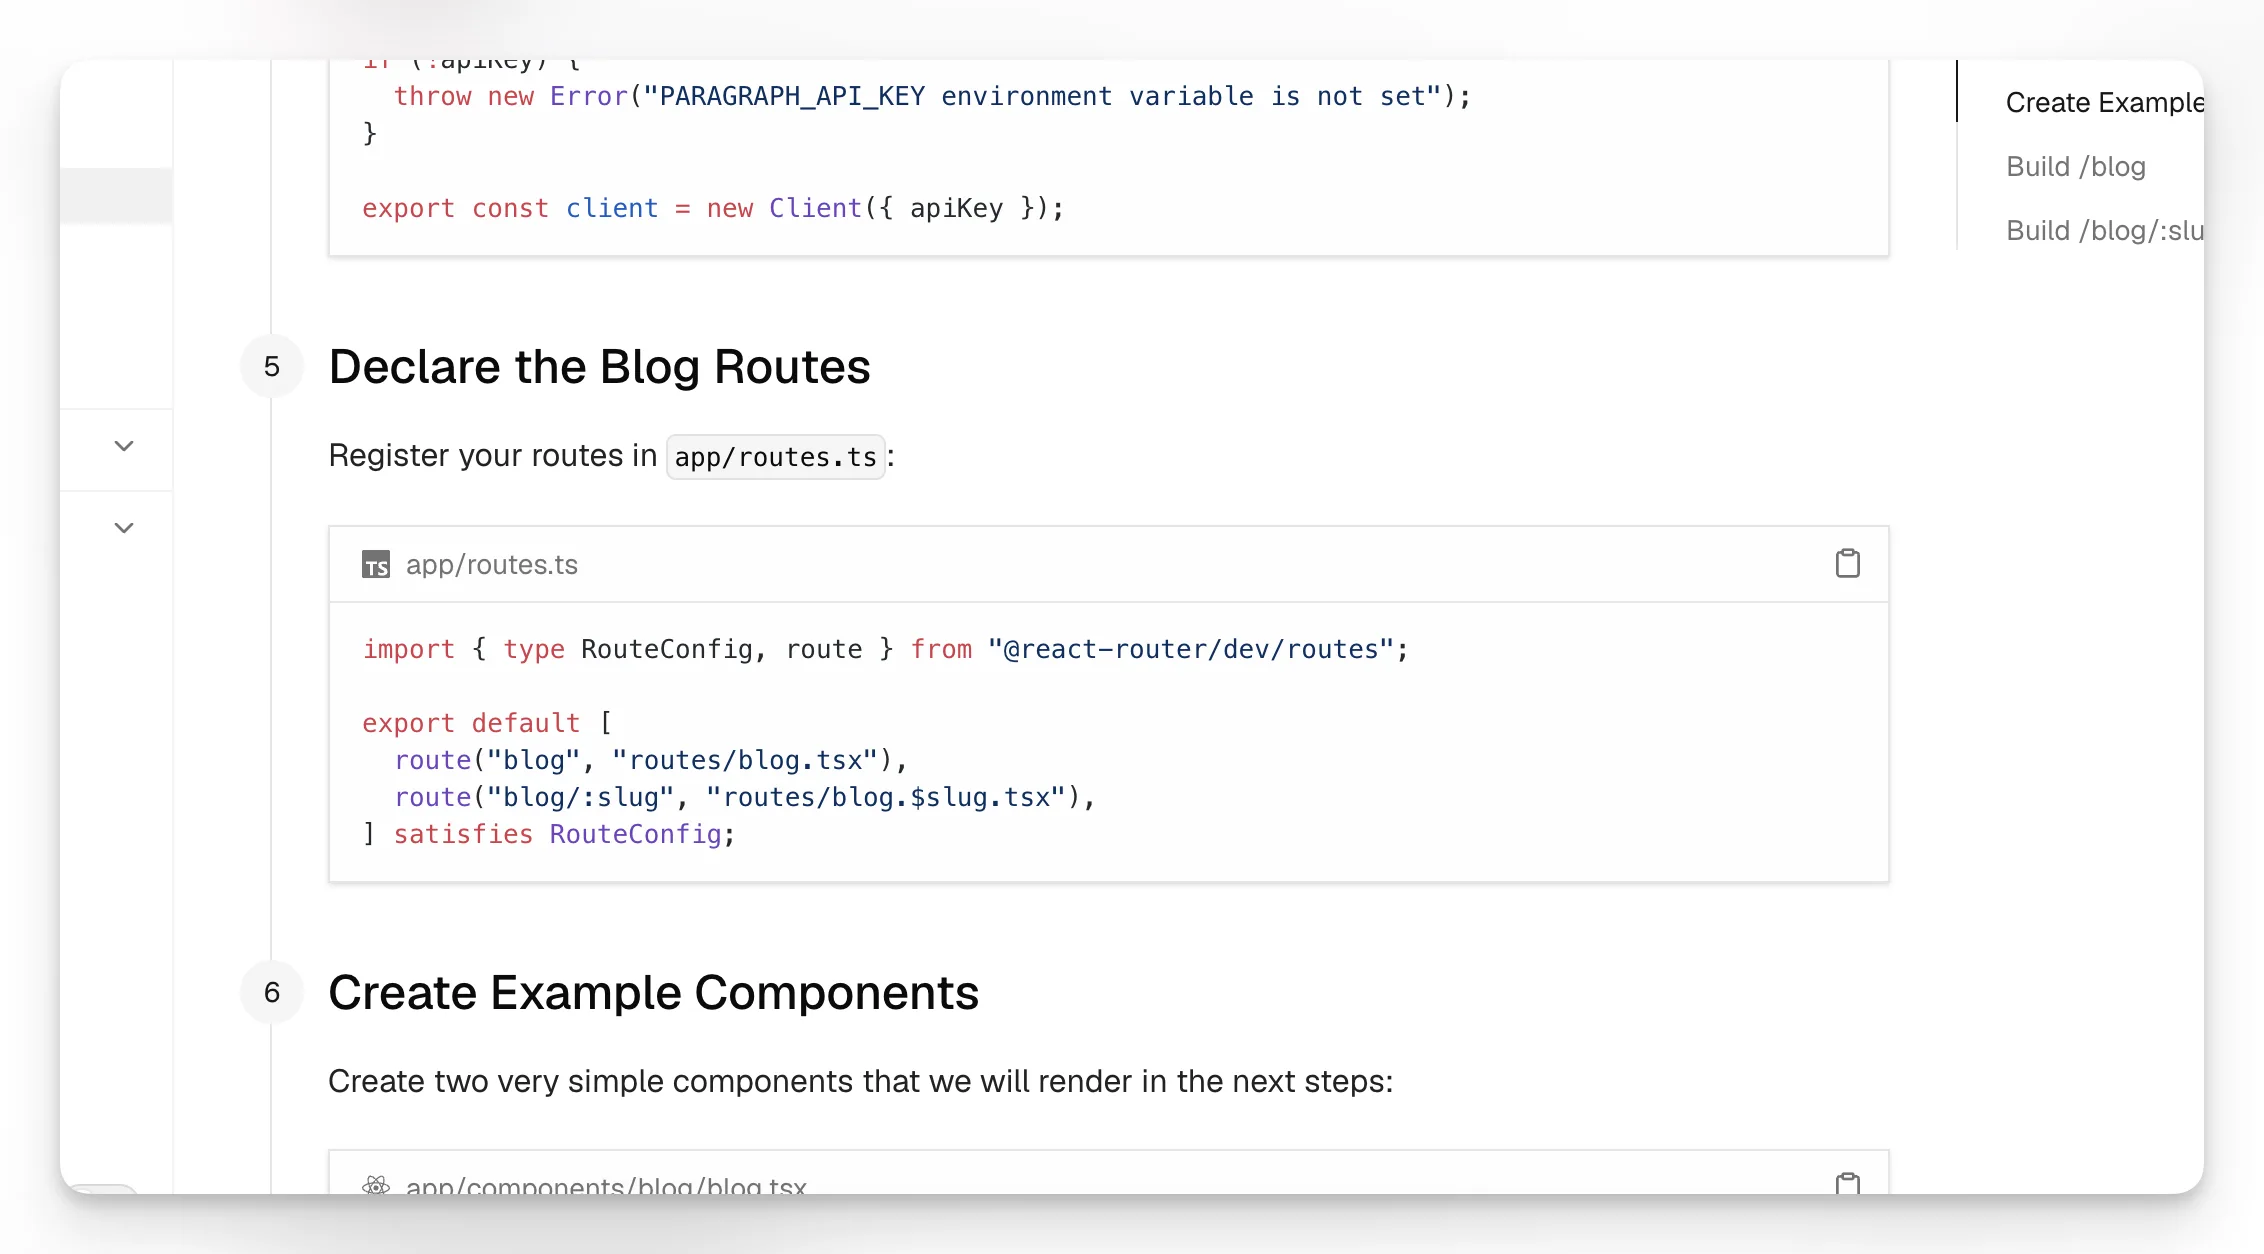
Beispiel für eine Routenkonfiguration:
import { type RouteConfig, route } from "@react-router/dev/routes";export default [ route("blog", "routes/blog.tsx"), route("blog/:slug", "routes/blog.$slug.tsx"),] satisfies RouteConfig;Das ist das standardmäßige slug-gesteuerte Muster für Content-Seiten. React Router besitzt die URL-Struktur, und der Loader ordnet diese URL einem CMS-Datensatz zu.
Im offiziellen Changelog von Paragraph CMS steht, dass der React-Router-Starter am 5. Juni 2026 mit funktionierenden /blog- und /blog/[slug]-Routen veröffentlicht wurde und das fortgeschrittene React-Router-Beispiel am 8. Juni 2026 mit locale-aware Routing und generierten Ressourcen wie Sitemap und RSS erschien.
So funktioniert die Listenroute
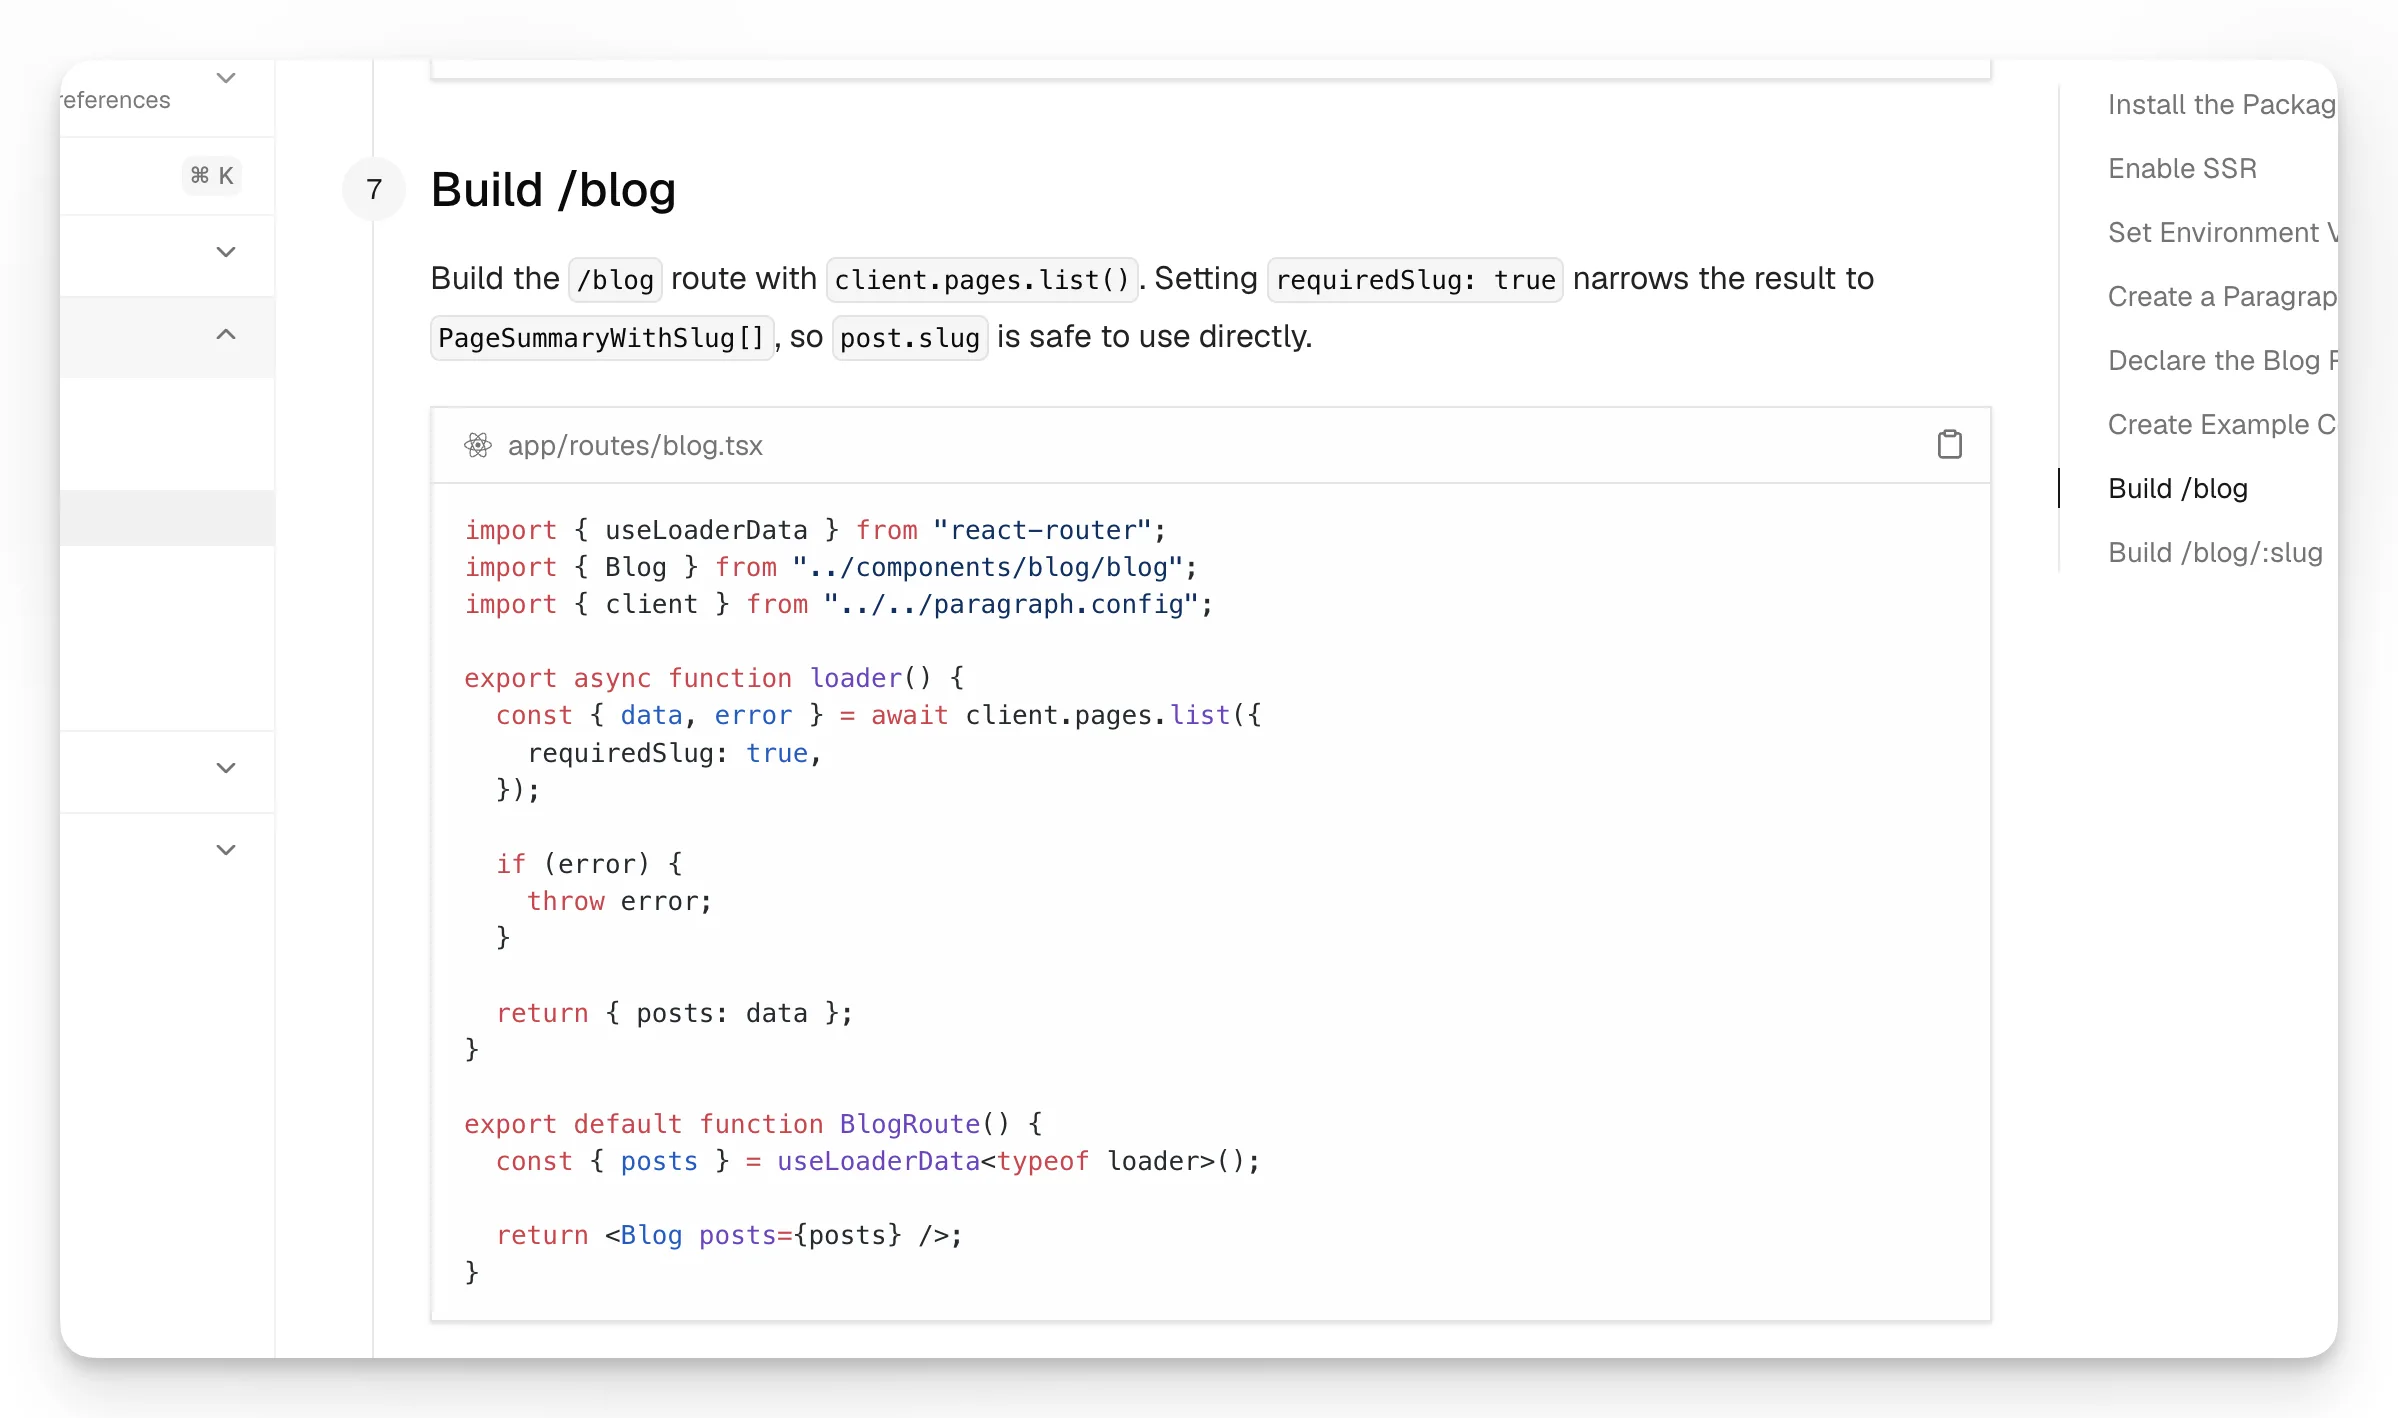
Die Listenroute ruft in der Regel Inhaltszusammenfassungen ab und überlässt die Präsentation der Komponentenebene.
Beispiel:
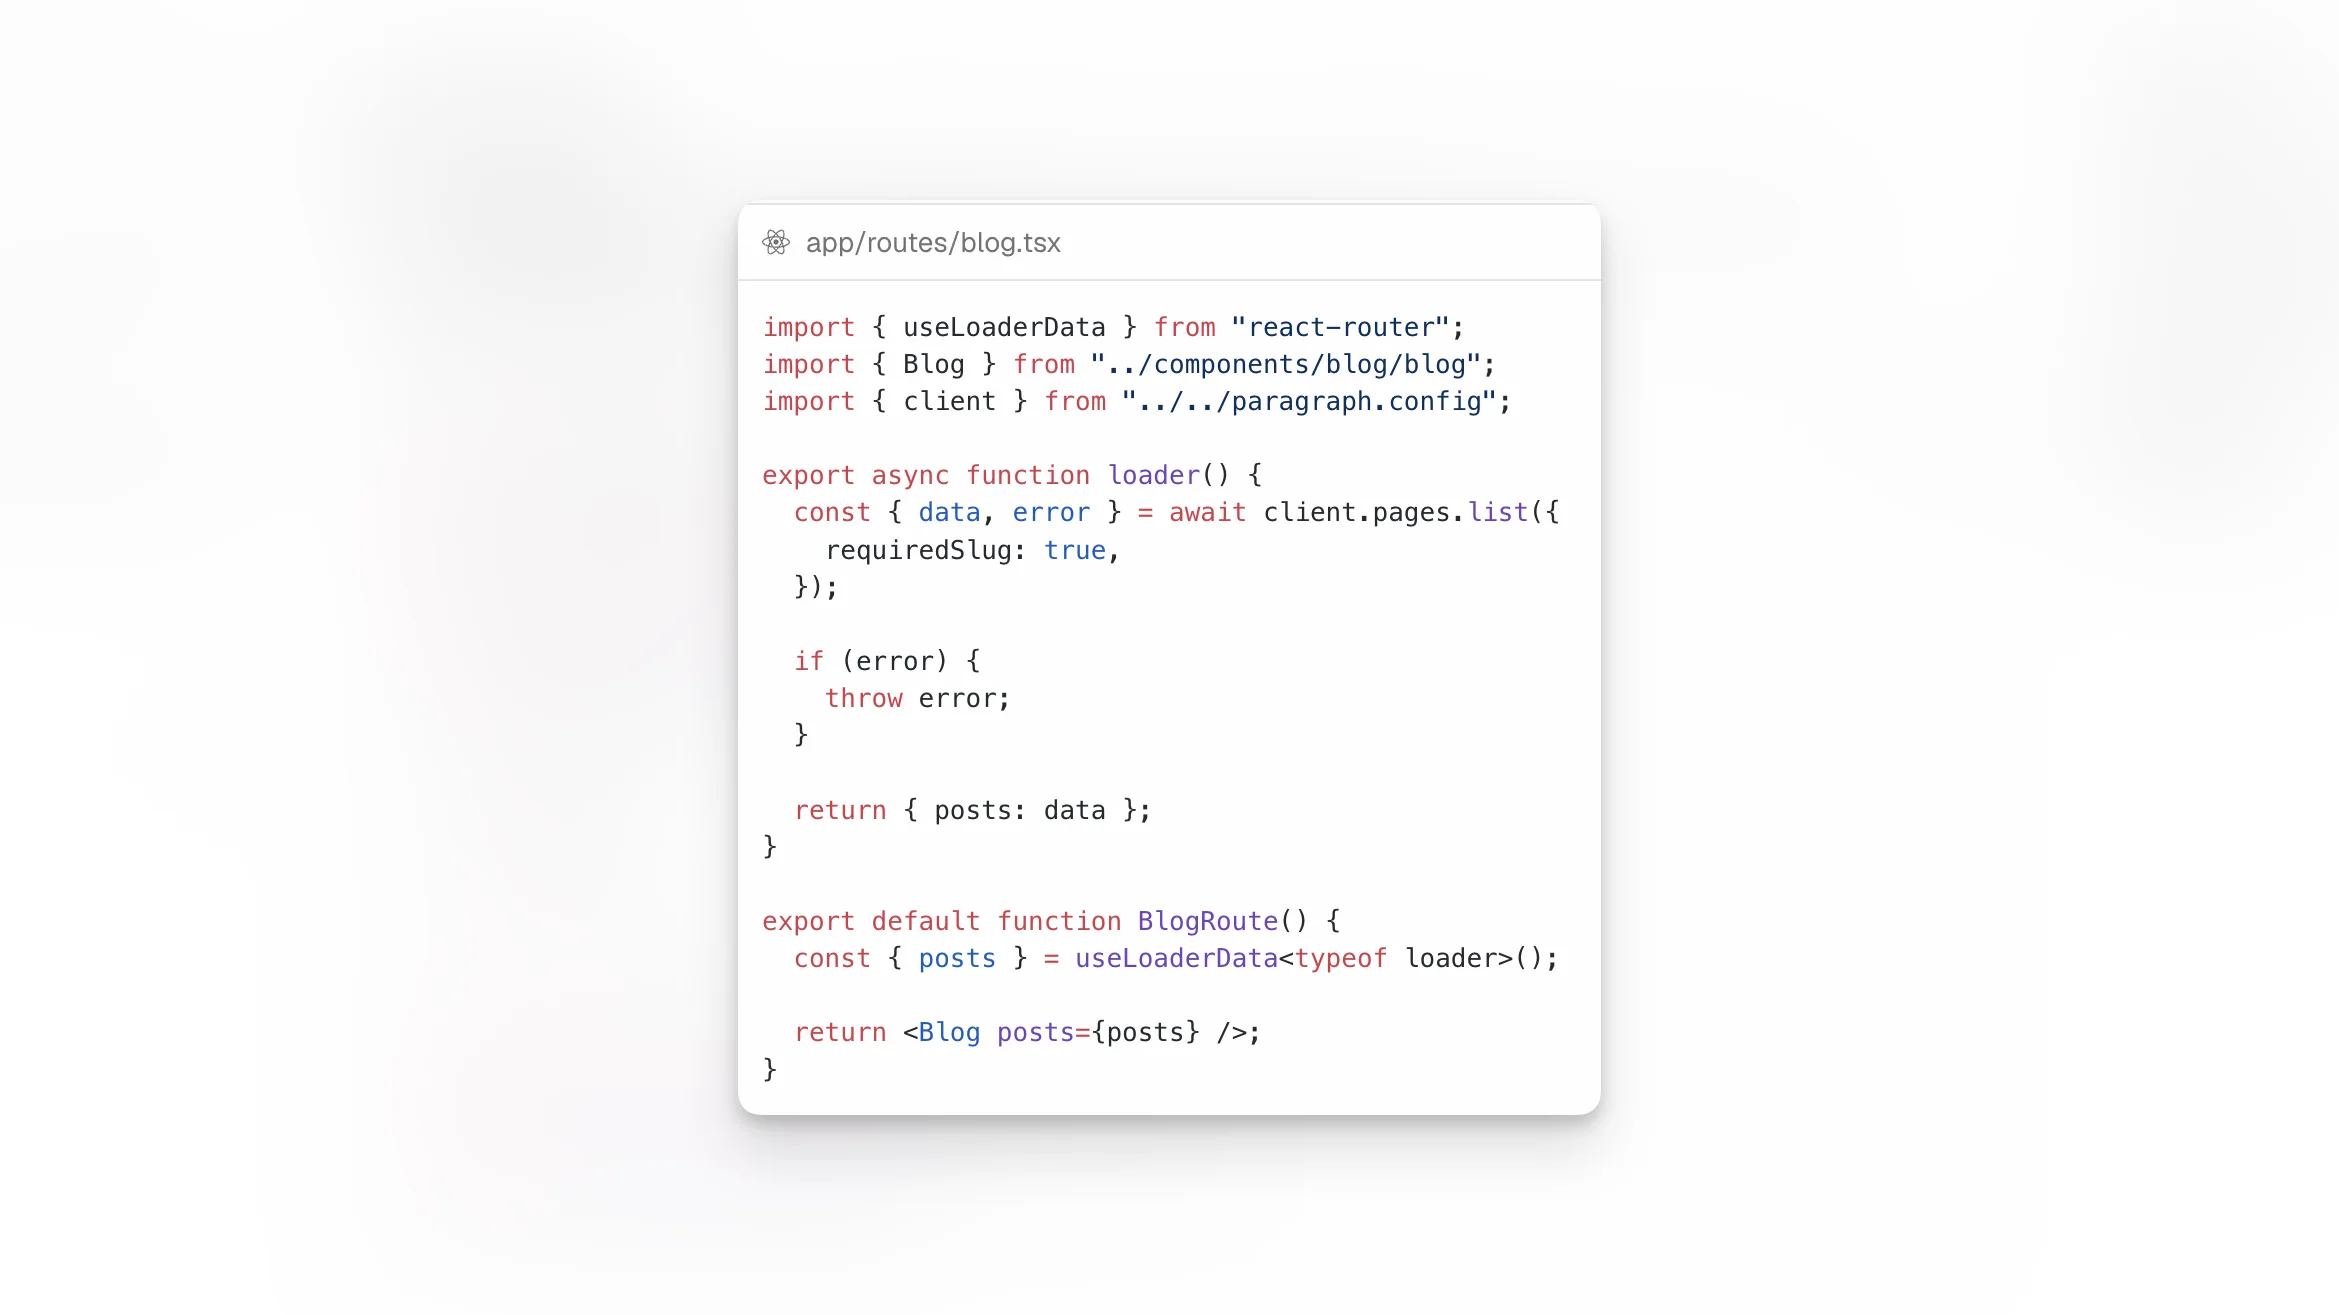
import { useLoaderData } from "react-router";import { Blog } from "../components/blog/blog";import { client } from "../../paragraph.config";export async function loader() { const { data, error } = await client.pages.list({ requiredSlug: true, }); if (error) { throw error; } return { posts: data };}export default function BlogRoute() { const { posts } = useLoaderData<typeof loader>(); return <Blog posts={posts} />;}Diese Aufteilung der Verantwortlichkeiten ist der Hauptpunkt:
der Loader ruft Inhalte ab
die Route gibt routenspezifische Daten zurück
die UI-Komponente rendert sie
Im Changelog von Paragraph CMS wird vermerkt, dass am 2. Juni 2026 client.pages.list() für nicht paginierte Antworten vereinfacht wurde, sodass Entwickler Ergebnisse direkt aus data lesen können.
So funktioniert die Slug-Route
Die Detailroute ist der klassische Headless-CMS-Ablauf: den URL-Slug lesen, den passenden Datensatz abrufen und ihn rendern.
Beispiel:
import { useLoaderData } from "react-router";import type { Route } from "./+types/blog.$slug";import { Post } from "../components/blog/post";import { client } from "../../paragraph.config";export async function loader({ params }: Route.LoaderArgs) { const { data, error } = await client.page.getBySlug(params.slug!); if (error) { throw error; } return { data };}export default function BlogPostRoute() { const { data } = useLoaderData<typeof loader>(); return <Post page={data} />;}Dieses Muster lässt sich gut verallgemeinern auf:
Blogbeiträge
Landingpages
Dokumentationsseiten
Changelog-Einträge
Wissensdatenbank-Artikel
Fallstudien
lokalisierte Inhalte
Der Anbieter kann sich ändern, aber das Routenmuster in der Regel nicht.
React Router dokumentiert auch Typsicherheit für Routenmodule, was nützlich ist, wenn deine Slug-Routen komplexer werden und eine verlässliche Typisierung für Loader und params brauchen.
Strukturierte Inhalte in React rendern
Ein echtes Headless CMS liefert in der Regel strukturierte Inhalte zurück, nicht nur rohe Strings. Diese Inhalte sollten über einen vertrauenswürdigen Renderer ausgegeben werden, der das Datenmodell des CMS versteht.
Beispiel:
import type { PageWithSlug } from "@paragraphcms/client";import { ParagraphContent } from "@paragraphcms/parser-react";export function Post({ page }: { page: PageWithSlug }) { return ( <main> <h1>{page.title}</h1> <ParagraphContent content={page.content} /> </main> );}Die übertragbare Erkenntnis ist:
strukturierte Inhalte im CMS speichern
strukturierte Inhalte in Loadern abrufen
sie über React-Komponenten oder einen offiziellen Renderer rendern
vermeiden, alles in unsicheres HTML zu flatten, wenn das nicht nötig ist
Die UI-Schicht bleibt einfach
Eines der besten Dinge an einer sauberen Headless-CMS-Integration ist, dass die UI oft auf gute Weise sehr unspektakulär wird.
Beispiel für eine Listenkomponente:
import type { PageSummaryWithSlug } from "@paragraphcms/client";import { Link } from "react-router";export function Blog({ posts }: { posts: PageSummaryWithSlug[] }) { return ( <main> <h1>Blog</h1> <ul> {posts.map((post) => ( <li key={post.id}> <Link to={`/blog/${post.slug}`}>{post.title}</Link> </li> ))} </ul> </main> );}Das zeigt die Aufteilung klar:
das CMS liefert strukturierte Inhaltsdaten
React Router liefert Navigation und Datengrenzen auf Routenebene
deine App entscheidet über Design, Layout, Zustände und UX
Was daraus einen echten Headless-CMS-Workflow macht
Ein Projekt ist nicht wirklich „headless“, nur weil es einmal eine API aufruft. Es wird zu einem Headless-CMS-Workflow, wenn die Trennung konsequent umgesetzt ist:
Redakteure arbeiten im CMS
Entwickler verantworten die Frontend-Codebasis
die App definiert Routen
Inhalte werden über eine API oder ein SDK ausgeliefert
das Rendering wird in der React-App übernommen
redaktionelle Änderungen und Frontend-Änderungen können unabhängig voneinander erfolgen
Paragraph CMS präsentiert sich öffentlich als Headless CMS mit API-Schlüsseln, SDKs, mehrsprachigen Inhalten, Medienverwaltung, Seiten-SEO und React-Router-Support auf seiner Website, was als Beispiel gut zu diesem Modell passt.
Was dieses Setup nicht von selbst löst
Eine einfache Blog-Integration ist ein guter Startpunkt, löst aber nicht automatisch alles.
Du musst weiterhin Folgendes entwerfen:
mehrsprachige URL-Strategie
Preview- und Entwurfs-Workflows
Taxonomie und Filterung
Cache-Invalidierung
Suchindexierung
Metadaten-Strategie
Zugriffskontrolle
Enterprise-Governance
Das Changelog von Paragraph CMS zeigt, wie ein Starter zu einem vollständigeren Setup ausgebaut werden kann. Am 8. Juni 2026 veröffentlichte der Anbieter fortgeschrittene Beispiele mit locale-aware Blog-Routing plus generierten sitemap.xml, robots.txt, llms.txt und RSS-Feeds. Am 25. Mai 2026 kündigte er außerdem ein SEO-Paket zur Generierung solcher Ressourcen an.
Wie man jedes Headless CMS für React Router bewertet
Wenn du CMS-Optionen für eine React-Router-App vergleichst, stelle praktische Fragen statt Markenfragen.
Content-Modellierung
Kann es deine Inhaltstypen klar abbilden?
Unterstützt es strukturierte Inhalte und nicht nur flachen Rich Text?
Lassen sich Slugs, Metadaten und Beziehungen einfach verwalten?
Auslieferung
Bietet es eine saubere API oder ein offizielles SDK?
Kannst du Inhalte effizient per Slug auflösen?
Ist die Antwortstruktur vorhersehbar genug für Routen-Loader?
React-Router-Fit
Funktioniert es gut mit SSR?
Können Geheimnisse serverseitig bleiben?
Ist die Integration in Routen-Loadern und Routenmodulen einfach?
Skalierungsanforderungen
Unterstützt es Lokalisierung?
Geht es sauber mit Medien um?
Hilft es bei SEO-Metadaten und Indexierungsressourcen?
Kann es von einem einfachen Blog zu einem größeren Content-System mitwachsen?
Das sind die richtigen Fragen, egal ob du Paragraph CMS oder ein anderes Headless CMS verwendest.
Sicherheitsaspekte
Jede Headless-CMS-Integration sollte Sicherheit als Teil der Architektur behandeln.
Zu den grundlegenden Best Practices gehören:
API-Schlüssel in Umgebungsvariablen speichern
geschützte Inhalte nach Möglichkeit auf dem Server abrufen
vermeiden, privilegierte Zugangsdaten im Browser offenzulegen
vertrauenswürdige Rendering-Ansätze für strukturierte Inhalte verwenden
CSP korrekt konfigurieren, falls deine App sie verwendet
Der offizielle Sicherheitsleitfaden von React Router erklärt ausdrücklich die Nonce-Handhabung für Inline-Skripte in CSP-basierten Anwendungen, und ServerRouter unterstützt die Übergabe einer Nonce zur Einhaltung von CSP. Wenn du zusätzlichen Schutz gegen versehentliches Client-Bundling von rein serverseitigem Code möchtest, dokumentiert React Router auch .server-Module.
SEO-Auswirkungen dieses Musters
Ein Headless CMS erzeugt nicht von selbst SEO. Was SEO hilft, ist die Kombination aus:
stabiler URL-Architektur
servergerendertem HTML
guter Handhabung von Metadaten
interner Verlinkung
strukturierter Content-Modellierung
generierten Crawl-Ressourcen, wo nötig
Das ist ein weiterer Grund, warum React Router hier gut funktioniert: Das Frontend besitzt URLs, Rendering und Metadatenstrategie, während das CMS die Quellinhalte besitzt.
Eine bessere Einordnung dieses Themas
Die beste redaktionelle Einordnung ist einfach:
Dies ist ein Artikel über das React-Router-Headless-CMS-Muster, der ein CMS als Implementierungsbeispiel verwendet.
Das ist besser, als die Seite in einen Produkt-Pitch zu verwandeln, denn Entwickler, die nach diesem Begriff suchen, möchten in der Regel verstehen:
wie Loader funktionieren
wie SSR hineinpasst
wie slug-basierte Routen Inhalte abrufen
wie strukturierte Inhalte gerendert werden
wie sich Content-Management von Frontend-Anwendungslogik trennen lässt
Praktische Erkenntnis
Wenn du die kürzeste treffende Zusammenfassung willst, dann diese:
React Router funktioniert gut mit einem Headless CMS, weil es serverseitiges Laden auf Routenebene, SSR-Unterstützung, Sicherheitsbausteine für echte Anwendungen und vollständige Kontrolle darüber bietet, wie Inhalte gerendert werden. Ein CMS wird dann zum Content-Backend hinter dieser Anwendungsschicht.
Das ist der Kern dieses Musters.
Was bedeutet „React Router headless CMS“ in der Praxis?
Es bedeutet, dass React Router Routen, Loader, SSR und UI-Rendering übernimmt, während ein Headless CMS Inhalte über eine API oder ein SDK speichert und ausliefert.
Warum ist React Router gut für ein Headless CMS geeignet?
Weil es routenbasiertes Laden von Daten, Unterstützung für Server-Rendering, Kontrolle über die URL-Struktur und eine saubere Grenze zwischen Content-Abruf und UI-Rendering bietet.
Brauche ich SSR für ein React-Router-Headless-CMS-Setup?
Nicht immer, aber SSR ist oft die beste Wahl, weil Zugangsdaten auf dem Server bleiben, Inhalte aufgelöst werden, bevor HTML gesendet wird, und SEO-Anwendungsfälle mit vielen Inhalten natürlicher unterstützt werden.
Was ist das übliche Routenmuster für CMS-Inhalte?
Der häufigste Ausgangspunkt ist eine Listenroute wie /blog und eine Detailroute wie /blog/:slug. Der Loader liest den Slug und ruft den passenden CMS-Eintrag ab.
Kann dieses Muster auch mit anderen CMS-Plattformen als Paragraph CMS funktionieren?
Ja. Die Architektur ist anbieteragnostisch. Jedes CMS mit einer nutzbaren API oder einem SDK, Slug-Unterstützung und Auslieferung strukturierter Inhalte kann in der Regel in dasselbe React-Router-Muster passen.
Was sollte ich bewerten, wenn ich ein CMS für React Router auswähle?
Konzentriere dich auf API-Qualität, SSR-Kompatibilität, Unterstützung für strukturierte Inhalte, Slug-Auflösung, Medienhandhabung, Lokalisierung, Unterstützung für Metadaten und darauf, wie sauber das Content-Modell zu deiner Routenstruktur passt.